
छोटी तर्क-श्रृंखला — हमेशा सबसे अच्छी नहीं
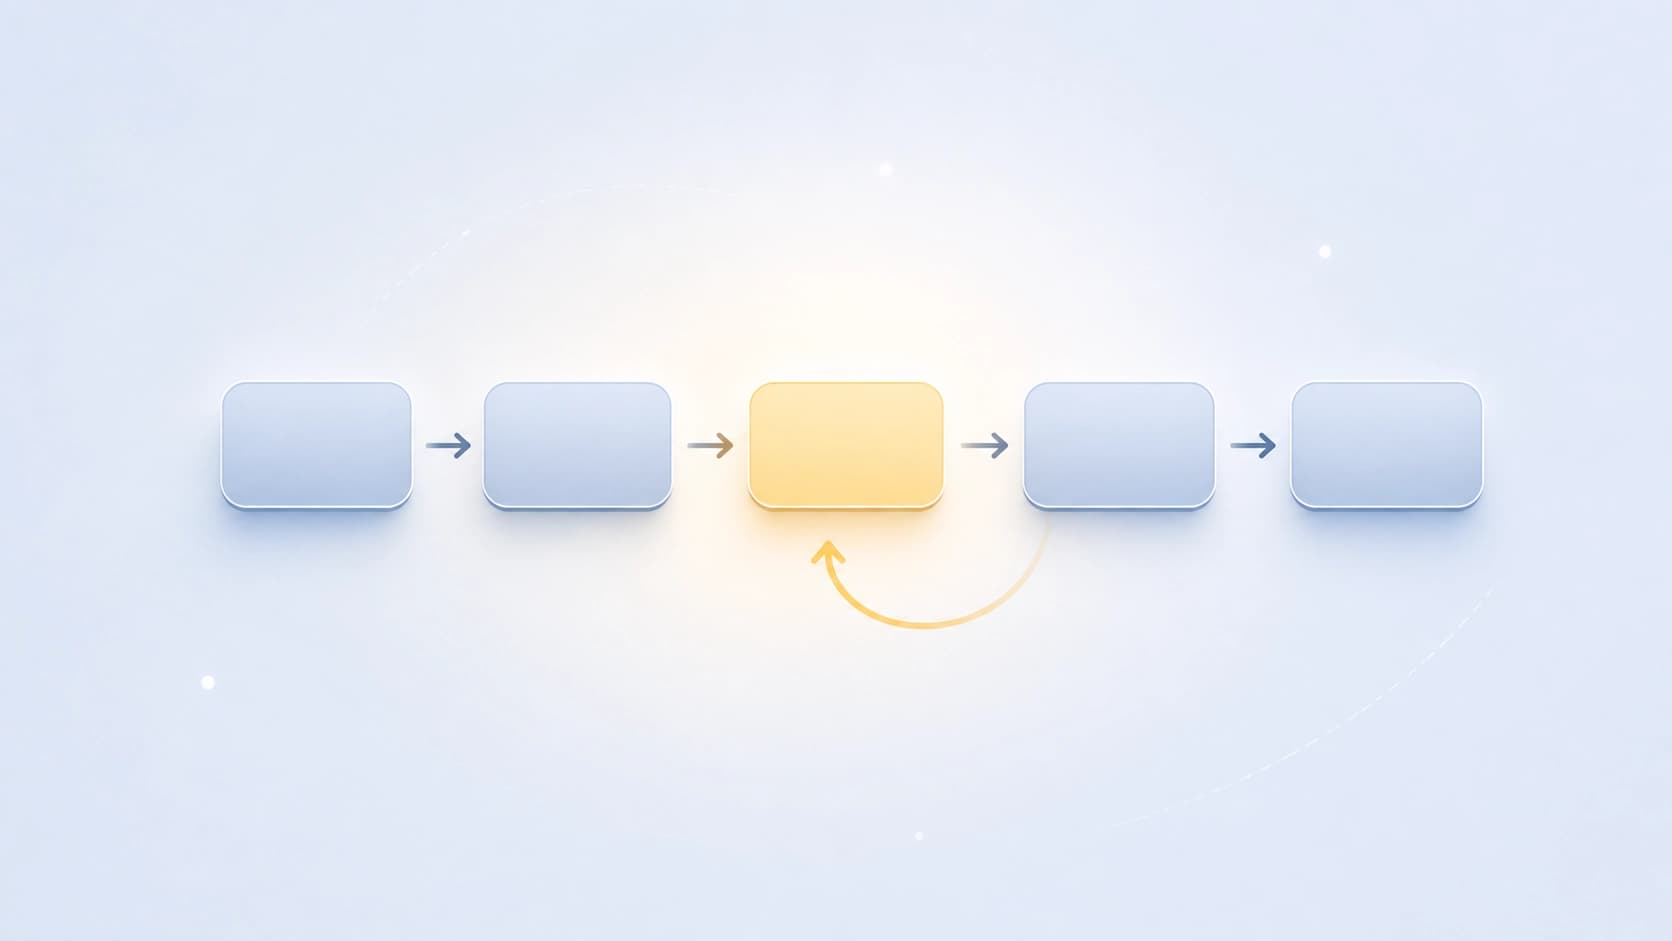
"ज़ोर से सोचने" के लिए प्रशिक्षित बड़े मॉडल लंबी तर्क-श्रृंखलाओं के दम पर बेहतर प्रदर्शन करते हैं। कार्य जितना जटिल होता है, मॉडल उत्तर देने से पहले उतने ही अधिक मध्यवर्ती चरण लिखता है। ऐसी गुणवत्ता के लिए जिस एक तंत्र को मुख्य माना जाता है, वह है आत्म-चिंतन: पहले किए गए चरणों पर नज़र डालने, गलती पहचानने और समाधान का रास्ता फिर से लिखने की क्षमता।
समस्या यह है कि इस क्षमता की कीमत चुकानी पड़ती है। पुनरावलोकन का हर कार्य इन्फ़रेंस में अतिरिक्त टोकन है, यानी पैसा, समय और कंप्यूट संसाधन। साथ ही, अब तक किसी ने ठीक से यह नहीं समझाया था कि मॉडल का "रुककर खुद को जाँचने" का निर्णय वास्तव में किससे नियंत्रित होता है। आत्म-चिंतन एक तरह से ब्लैक बॉक्स के भीतर का ब्लैक बॉक्स था: पता है कि यह काम करता है, समझ नहीं आता कि कैसे।
Ge Yan, Chung-En Sun, Linbo Liu और Tsui-Wei Weng का काम (arXiv:2512.13979, COLM 2026 में स्वीकृत) इस प्रश्न को अप्रत्याशित दिशा से उठाता है — प्रॉम्प्ट्स से नहीं और फ़ाइन-ट्यूनिंग से नहीं, बल्कि मॉडल के लेटेंट प्रतिनिधित्वों से।
मॉडल के भीतर चिंतन की दिशा
क्या खोजा और क्या पाया
शोधकर्ताओं ने आत्म-चिंतन पर representation engineering का तंत्र लागू किया — वह क्षेत्र जो मॉडल के आउटपुट टेक्स्ट की नहीं, बल्कि उसके आंतरिक एक्टिवेशन की जाँच करता है। तर्क सरल है: यदि मॉडल "निर्णय" लेता है कि चिंतन करना है, तो यह निर्णय उसके प्रतिनिधित्वों में कहीं प्रतिबिंबित होता है। यानी इसे खोजा जा सकता है, वर्णित किया जा सकता है और — सबसे महत्वपूर्ण — उपयोग किया जा सकता है।
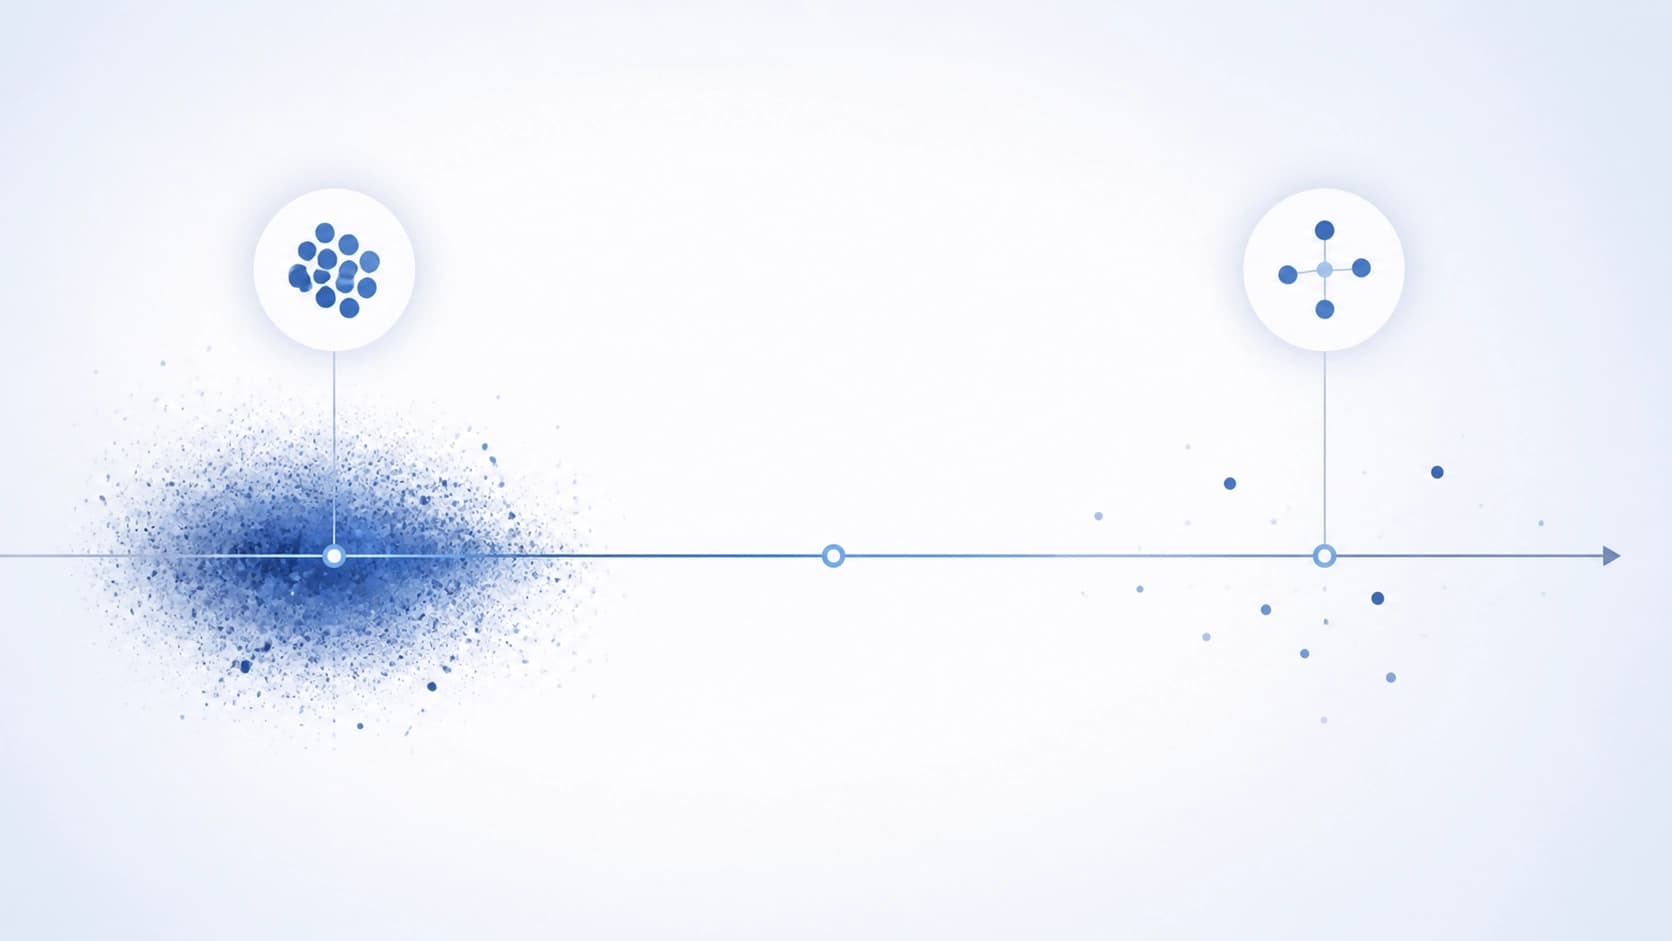
और ऐसा ही निकला। लेटेंट स्पेस में एक विशिष्ट दिशा मिली, जिसके अनुदिश चिंतन वाले चरण बिना चिंतन वाले चरणों से अलग हो जाते हैं। मूलतः यह "फिर से जाँचना / न जाँचना" की धुरी है, और इस धुरी पर बिंदु की स्थिति दो प्रकार के चरणों को स्थिर रूप से अलग पहचानती है।
चिंतन को अनिश्चितता नियंत्रित करती है
लेख का सबसे दिलचस्प अवलोकन: मिली दिशा के अनुदिश एक्टिवेशन का परिमाण अच्छी तरह भविष्यवाणी करता है कि अंततः उत्तर सही होगा या नहीं। दूसरे शब्दों में, चिंतन संयोग से या किसी कार्यक्रम के अनुसार सक्रिय नहीं होता — यह मॉडल की आंतरिक अनिश्चितता से जुड़ा है। जब मॉडल "महसूस" करता है कि मामला फिसलन भरा है, तो वह रुककर पुनर्विचार करता है; जब सब स्पष्ट है, तो आगे बढ़ जाता है।
यह विश्वदृष्टि में एक महत्वपूर्ण बदलाव है। चिंतन एक अलग क्षमता होना बंद हो जाता है जिसे विकसित करना होता है, और बल्कि एक संकेत बन जाता है — इस बात का सूचक कि मॉडल स्वयं अपने चरण पर संदेह कर रहा है।
ReflCtrl कैसे बना है
यदि चिंतन का निर्णय एक्टिवेशन में रहता है, तो उसे सीधे प्रभावित किया जा सकता है — प्रॉम्प्ट फिर से लिखने के बजाय प्रतिनिधित्वों में हस्तक्षेप करके। इसी पर ReflCtrl आधारित है: एक फ़्रेमवर्क जो स्टीयरिंग के माध्यम से आत्म-चिंतन को नियंत्रित करता है — मिली दिशा के अनुदिश एक्टिवेशन का विस्थापन।
मुख्य बारीकी — हस्तक्षेप कब करना है
सरल दृष्टिकोण स्पष्ट है: हर उत्पन्न होने वाले टोकन पर आवश्यक विस्थापन जोड़ना। यही सबसे पहले दिमाग में आता है — और यही खराब तरीके से काम करता है। प्रतिनिधित्वों पर निरंतर दबाव जनरेशन की गुणवत्ता को धुंधला कर देता है: मॉडल सुसंगति खो देता है, क्योंकि हस्तक्षेप वहाँ भी होता है जहाँ इसका कोई अर्थ नहीं है।
लेखक एक चरण-स्तरीय (step-level) विकल्प प्रस्तावित करते हैं। हस्तक्षेप ठीक एक बार लागू होता है — तर्क के हर नए चरण की शुरुआत में। इसके बाद मॉडल उस चरण के टोकन बिना किसी बाधा के स्वतंत्र रूप से उत्पन्न करता है। इससे एक सूक्ष्म संतुलन बनता है: चिंतन की आवृत्ति बदलती है, लेकिन चरण के भीतर विचार की धारा अछूती रहती है।
यही संयोजन — निरंतर के बजाय दुर्लभ, सटीक हस्तक्षेप — मुख्य लाभ देता है।
प्रयोगों ने क्या दिखाया
परीक्षण गणितीय और सामान्य तर्क के बेंचमार्क पर किए गए। परिणाम उद्योग के लिए काफ़ी असुविधाजनक निष्कर्ष में ढलते हैं: चिंतन अक्सर अनावश्यक होता है।
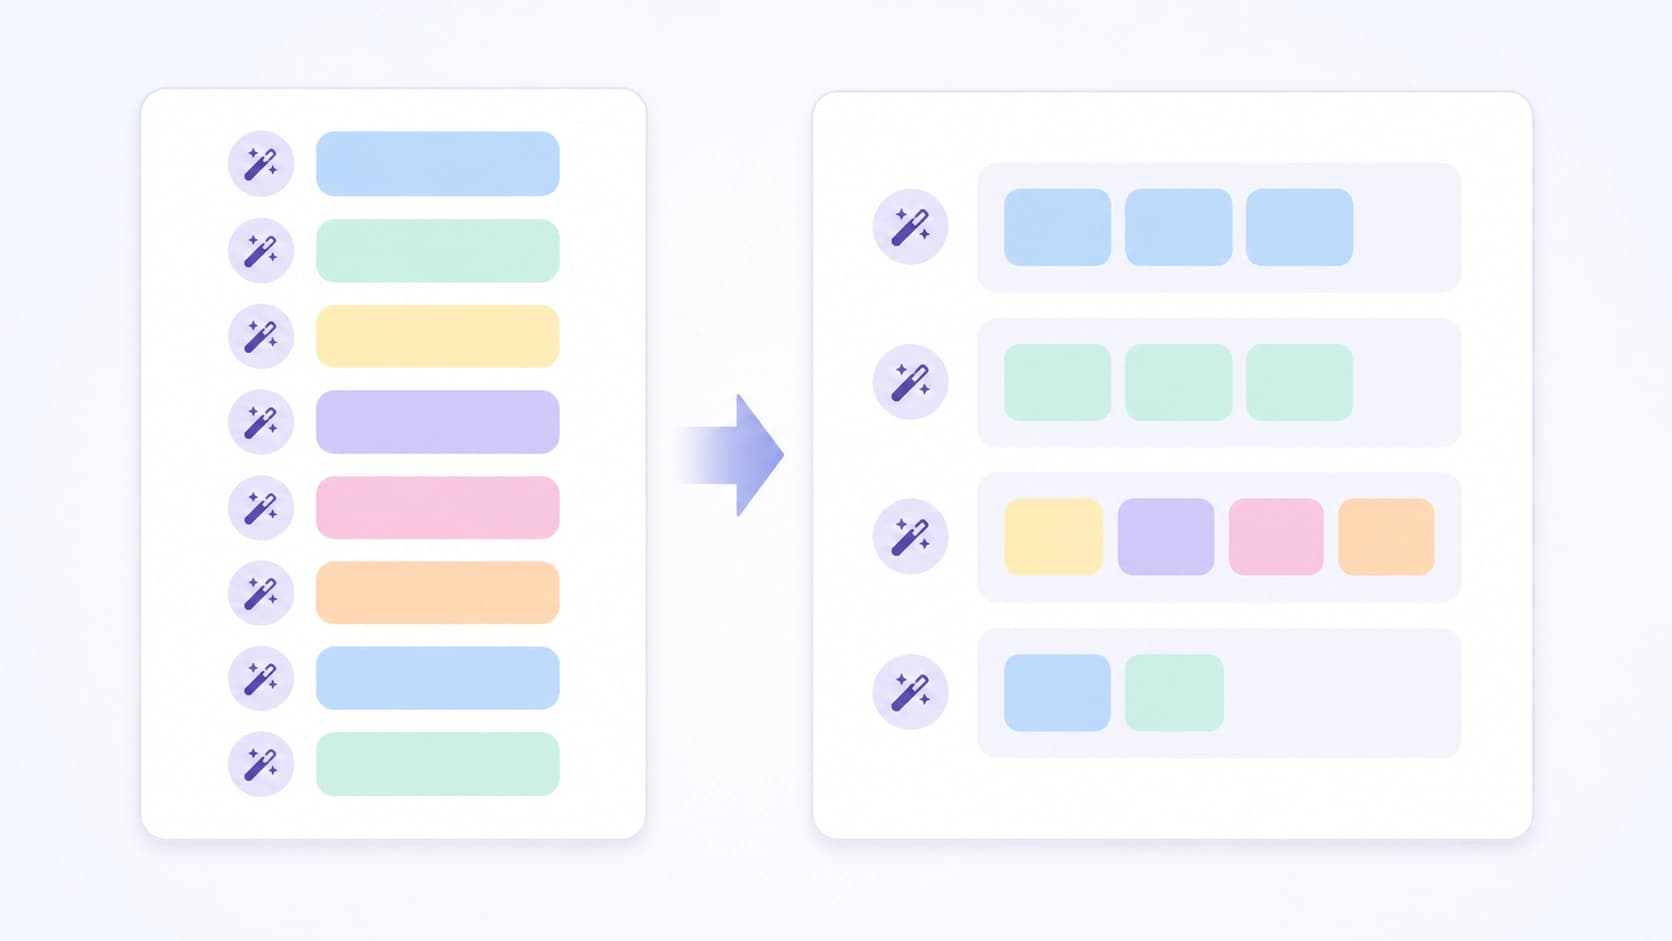
- तर्क के टोकनों की संख्या मूल मात्रा के 43,2% तक घटाई जा सकती है — सटीकता बनाए रखते हुए।
- प्रभाव अधिक मज़बूत मॉडलों पर विशेष रूप से स्पष्ट है: मॉडल जितना बेहतर होता है, उतनी ही अधिक बार वह बिना ज़रूरत के खुद को जाँचता है।
- तुलनीय टोकन बजट पर चरण-स्तरीय स्टीयरिंग पारंपरिक प्रति-टोकन स्टीयरिंग से स्पष्ट रूप से आगे निकल जाती है।
दूसरा और तीसरा बिंदु जुड़े हुए हैं। मज़बूत मॉडल अपने चरणों पर अधिक आश्वस्त होता है, इसलिए उसका चिंतन अधिक बार व्यर्थ साबित होता है — और प्रति-टोकन स्टीयरिंग ठीक इसी से पीड़ित होती है कि वह समय पर रुकना नहीं जानती।
प्रयोगशाला से बाहर यह क्यों महत्वपूर्ण है
तर्क की अर्थव्यवस्था कोई अमूर्त बात नहीं है। लंबी श्रृंखलाएँ इन्फ़रेंस के बिल बढ़ाती हैं, विलंबता बढ़ाती हैं और यह सीमित करती हैं कि उपलब्ध हार्डवेयर से कुल कितने अनुरोध गुज़ारे जा सकते हैं। यदि लगभग आधे "विचार" को गुणवत्ता खोए बिना हटाया जा सकता है, तो यह पैमाने पर सीधी बचत है।
एक कम स्पष्ट परत भी है। यह काम दिखाता है कि मॉडल के व्यवहार को प्रतिनिधित्व के स्तर पर समायोजित किया जा सकता है — प्रॉम्प्ट्स से अधिक कोमल और सटीक, और फ़ाइन-ट्यूनिंग से सस्ता। नियंत्रणीयता एक अलग इंजीनियरिंग आयाम बन जाती है: "निर्देश में क्या लिखना है" नहीं, बल्कि "एक्टिवेशन को कहाँ खिसकाना है और किस क्षण"।
अंत में, यह व्याख्याशीलता में योगदान है। हम बेहतर ढंग से समझ रहे हैं कि जब मॉडल रुककर खुद से कहता है "चलो फिर से देखता हूँ", तो भीतर वास्तव में क्या होता है।
खुले प्रश्न
प्रयोज्यता की सीमाएँ अभी तक पूरी तरह रेखांकित नहीं हैं। एक दिशा के अनुदिश स्टीयरिंग एक संकीर्ण उपकरण है: यह मिली चिंतन-धुरी को अच्छी तरह पकड़ती है, लेकिन आत्म-सुधार के अन्य प्रकारों का क्या करें — यह स्पष्ट नहीं है। यह प्रश्न भी बना हुआ है कि मिली दिशा आर्किटेक्चरों के बीच कितनी स्थानांतरणीय है: हर मॉडल के अपने प्रतिनिधित्व होते हैं, और यह ज़रूरी नहीं कि एक के लिए काम करने वाला वेक्टर दूसरे के काम आए।
उन कार्यों पर बचत और विश्वसनीयता के बीच का समझौता भी पूरी तरह स्पष्ट नहीं है जहाँ गलती महँगी पड़ती है। औसत सटीकता बनाए रखते हुए 43,2% टोकन काटना एक मज़बूत परिणाम है, लेकिन औसत सटीकता का अर्थ दुर्लभ विनाशकारी विफलताओं का अभाव नहीं है। "अतिरिक्त" चिंतन को उस एकमात्र चिंतन से अलग करना, जो उत्तर बचाता है — संभवतः इस शोध-दिशा का अगला कार्य है।


