
OWP दृष्टिकोण: Omni-LLM में साक्ष्यों और पूर्व-प्रायिकता संकेतों का पुनर्वितरण
बिना प्रशिक्षण के इस्तेमाल किया जा सकने वाला Omni-Woodpecker फ्रेमवर्क पेश किया गया है, जो विभिन्न मोडैलिटी के बीच टकराव का पता लगाता है और डिकोडिंग से पहले छिपी अवस्थाओं में संदर्भ डेटा और सीखे हुए पूर्वानुमानों के बीच संतुलन बदलता है। Qwen2.5-Omni-7B और VideoLLaMA2-AV पर यह विधि CMM और AVHBench में ऑडियो-विज़ुअल त्रुटियों के प्रति मजबूती बढ़ाती है, और सामान्य तर्क बेंचमार्क पर मध्यम सुधार देती है।
OWP क्या है और यह किस समस्या का समाधान करता है
Omni-Woodpecker (OWP) Omni LLMs में अंतर-मोडल मतिभ्रमों को सुधारने के लिए एक बिना-प्रशिक्षण वाला फ्रेमवर्क है। यह विधि सुधार को आउटपुट के स्तर से हटाकर, मोडैलिटी के टकराव के कारण होने वाले प्रतिनिधित्वों के पुनर्संतुलन पर ले जाती है। लेखकों ने 19 अक्टूबर 2026 को शोधपत्र प्रस्तुत किया: Zijian Liu, Chaoyou Fu, Yan Yang, Caifeng Shan, Ran He.
पारंपरिक सुधार तैयार जवाब पर काम करता है। OWP डिकोडिंग से पहले आंतरिक प्रतिनिधित्वों में हस्तक्षेप करता है। इससे विधि के अनुप्रयोग का बिंदु बदल जाता है।
निष्कर्ष: OWP सुधार का बिंदु बदलता है, तैयार जवाब को ठीक नहीं करता।
साक्ष्यों और पूर्व संकेतों के पुनर्वितरण के चरण
OWP कई चरणों में पुनर्संतुलन करता है। सबसे पहले, यह अलग-अलग मोडैलिटी के पूरक प्रतिनिधित्वों के आधार पर अंतर-मोडल टकरावों की पहचान करता है।
- अलग-अलग मोडैलिटी के पूरक प्रतिनिधित्वों के आधार पर अंतर-मोडल टकरावों की पहचान।
- ग्राउंडिंग-साक्ष्यों को प्रतिस्पर्धी पूर्वधारणा-आधारित अनुमानों से अलग करने के लिए हिडन स्टेट्स का ऑर्थोगोनल अपघटन।
- संयुक्त प्रतिनिधित्वों का अनुकूली पुनर्संतुलन: भ्रामक पूर्वधारणाओं को दबाना और अनदेखे साक्ष्यों को पुनः स्थापित करना।
- संशोधित प्रतिनिधित्वों को डिकोडिंग के लिए भेजना।
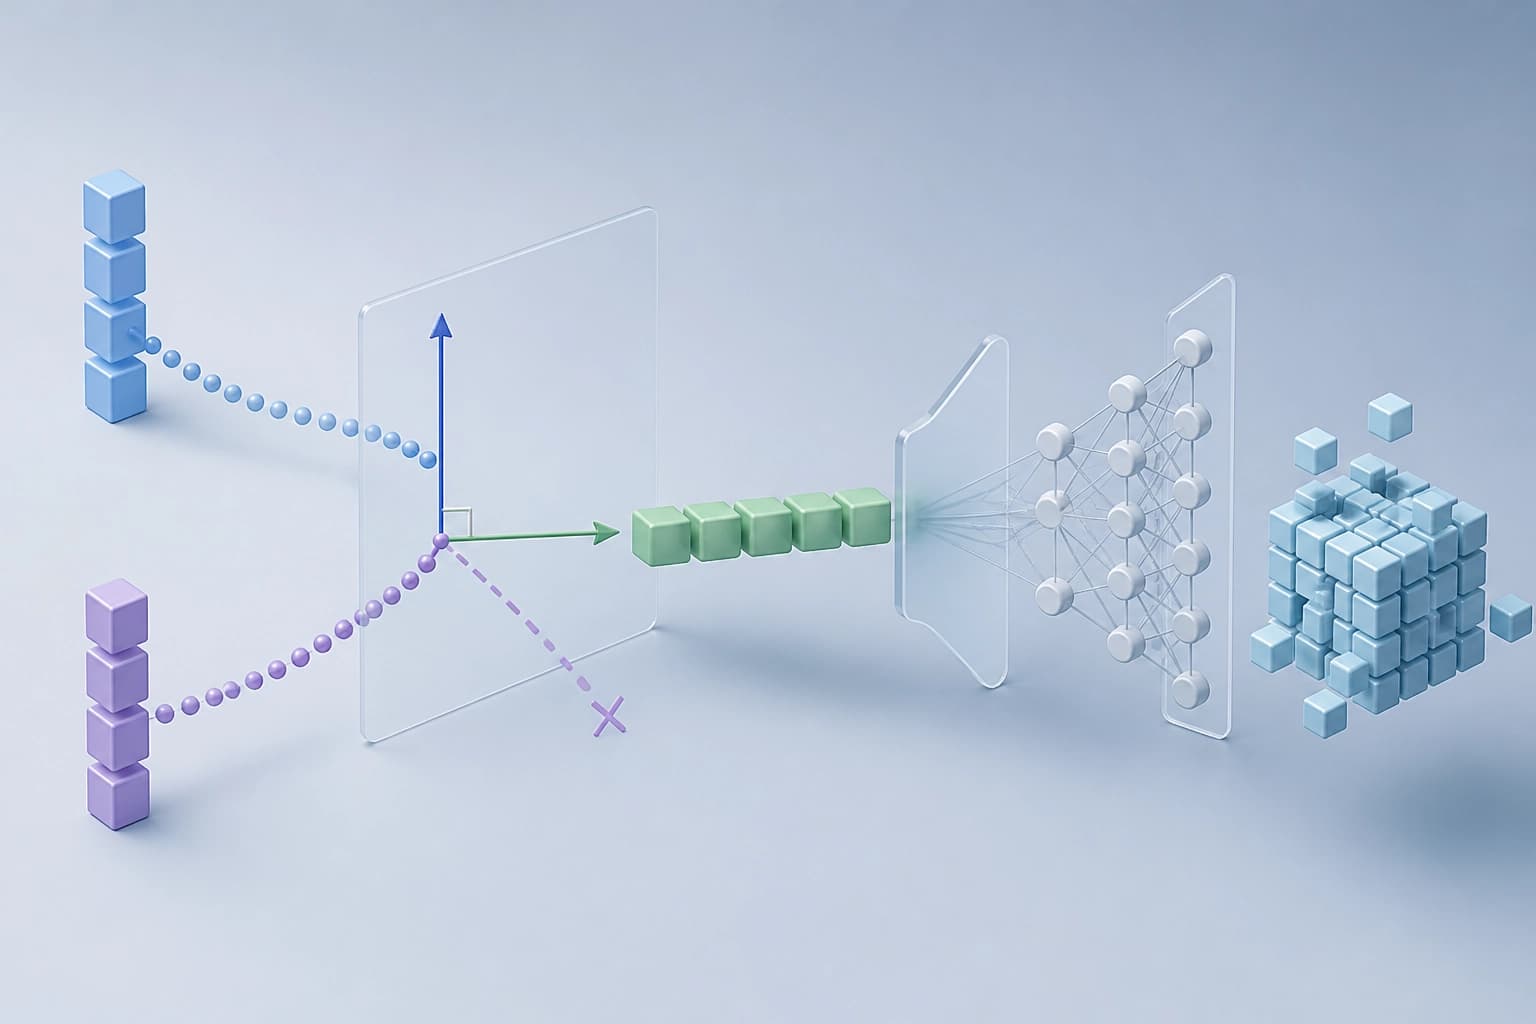
यह विधि मॉडल के वज़न नहीं बदलती। यह जनरेशन से पहले प्रतिनिधित्वों को संशोधित करती है।
निष्कर्ष: OWP के लिए प्रशिक्षण या वज़न में बदलाव की ज़रूरत नहीं है। यह डिकोडिंग से पहले हिडन स्टेट्स पर काम करता है।
नतीजे: बेंचमार्क पर सुधार और स्थानांतरणीयता
Qwen2.5-Omni-7B पर OWP, CMM और AVHBench पर क्रमशः 12,9 और 8,6 अंक तक परिणाम बेहतर करता है। OLLM के चार सामान्य तर्क-बेंचमार्क पर सुधार 0,67–2,25 अंक का है।
| मॉडल | CMM | AVHBench |
|---|---|---|
| Qwen2.5-Omni-7B | +12,9 अंक | +8,6 अंक |
| VideoLLaMA2-AV | +4,6 अंक | +3,9 अंक |
इस विधि ने VideoLLaMA2-AV पर भी स्थानांतरणीयता दिखाई: CMM और AVHBench पर क्रमशः 4,6 और 3,9 अंकों का सुधार। लेखक अलग-अलग आर्किटेक्चर में इसकी प्रभावशीलता और स्थानांतरणीयता की जानकारी देते हैं। कोड सार्वजनिक रूप से उपलब्ध है।
निष्कर्ष: सुधार मॉडल और बेंचमार्क पर निर्भर करता है। व्यावहारिक कसौटी: इसे लागू करने से पहले अपने आर्किटेक्चर और लक्षित कार्यों के सेट पर OWP को जाँचना चाहिए।
OWP चुनने के व्यावहारिक मानदंड
OWP कई शर्तों के तहत उपयुक्त है। यह विधि मॉडल को प्रशिक्षित किए बिना और उसके वज़न बदले बिना काम करती है।
- बिना प्रशिक्षण के अंतर-मोडल मतिभ्रमों में सुधार की ज़रूरत है।
- हिडन स्टेट्स और अलग-अलग मोडैलिटी के प्रतिनिधित्व उपलब्ध हैं।
- जवाब के पोस्ट-प्रोसेसिंग के बजाय डिकोडिंग से पहले हस्तक्षेप करना ज़रूरी है।
- विधि को दोहराने की सुविधा है: कोड सार्वजनिक रूप से उपलब्ध है।
OWP साक्ष्यों और पूर्व संकेतों को पुनर्संतुलित करने का एक बिना-प्रशिक्षण वाला तरीका है। लेखक अलग-अलग आर्किटेक्चर में इसकी स्थानांतरणीयता का दावा करते हैं। किसी खास मॉडल पर इसकी जाँच करना फिर भी ज़रूरी है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री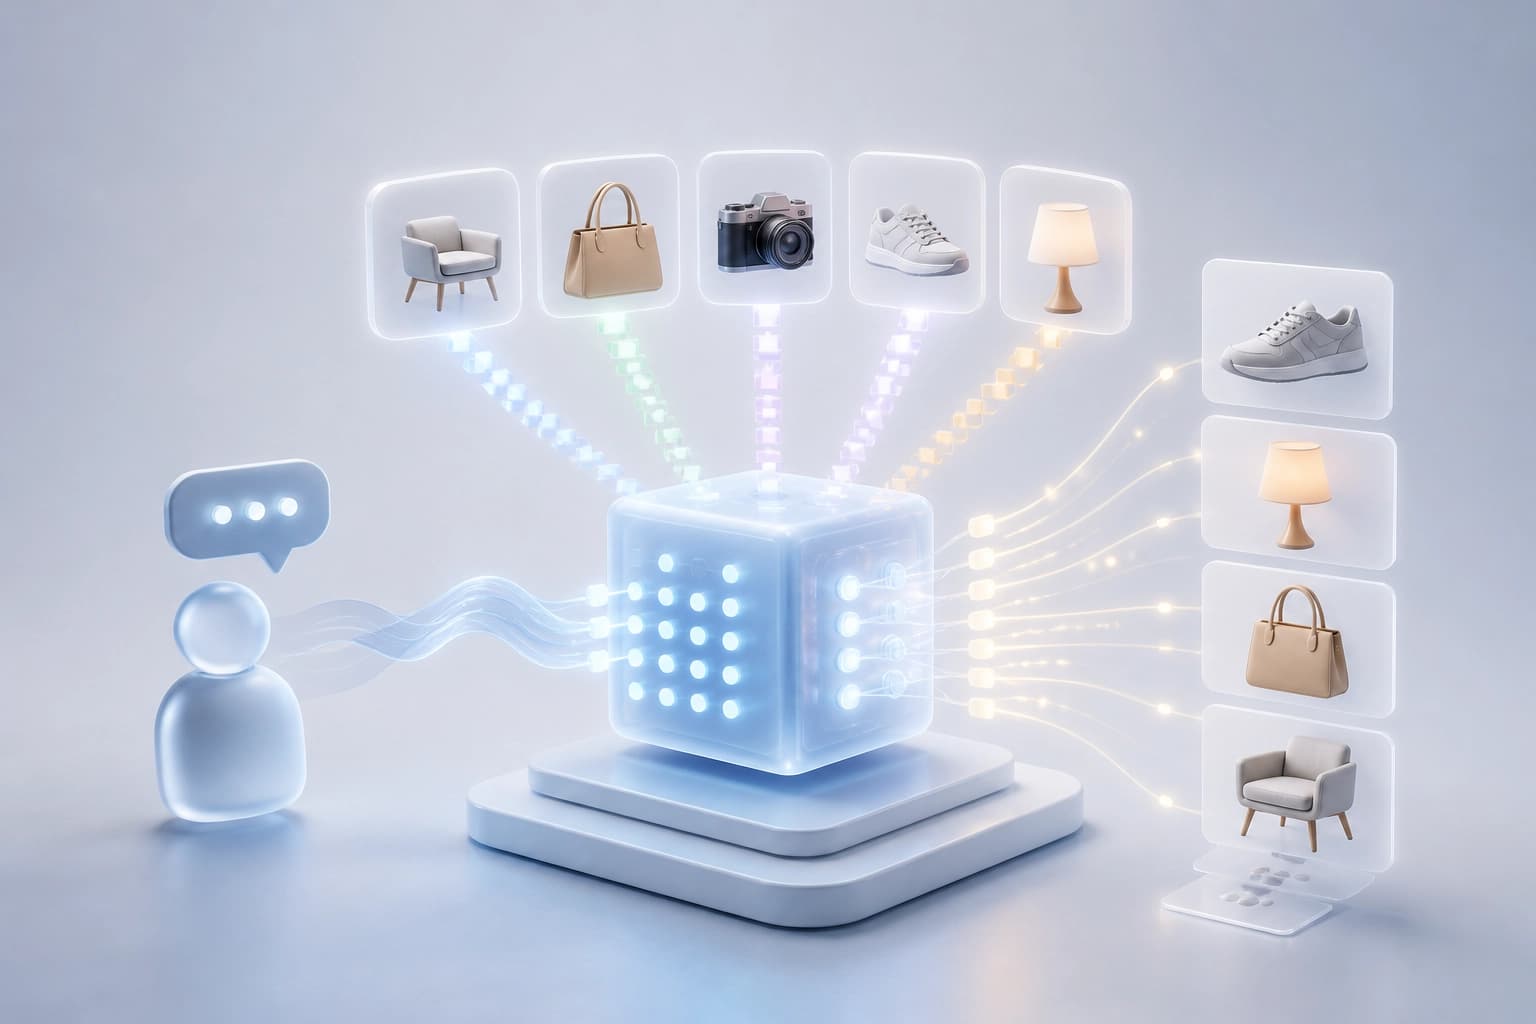
LightCRS: प्रत्येक श्रेणी के लिए अलग VLM के बिना संवादात्मक अनुशंसाओं की कॉम्पैक्ट बहु-डोमेन योजना
लेखक ऐसी प्रणाली प्रस्तुत करते हैं जिसमें उत्पादों के मल्टीमॉडल फीचर्स की गणना ऑफ़लाइन फ़्रीज़ किए गए एन्कोडर्स द्वारा की जाती है, और संवाद के दौरान उन्हें सभी डोमेन के लिए साझा 5.3 मिलियन पैरामीटर वाले मॉड्यूल द्वारा संसाधित किया जाता है, जिसमें क्वेरी पर निर्भर क्रॉस-अटेंशन है। 25 डोमेन के बेंचमार्क पर यह तरीका रैंकिंग के औसत मेट्रिक्स को बेहतर बनाता है, विलंबता को काफ़ी कम करता है और दिखाता है कि संयुक्त प्रशिक्षण से अलग-अलग एकल-डोमेन मॉडल की तुलना में बेहतर परिणाम मिलते हैं।
16 नवम्बर 2026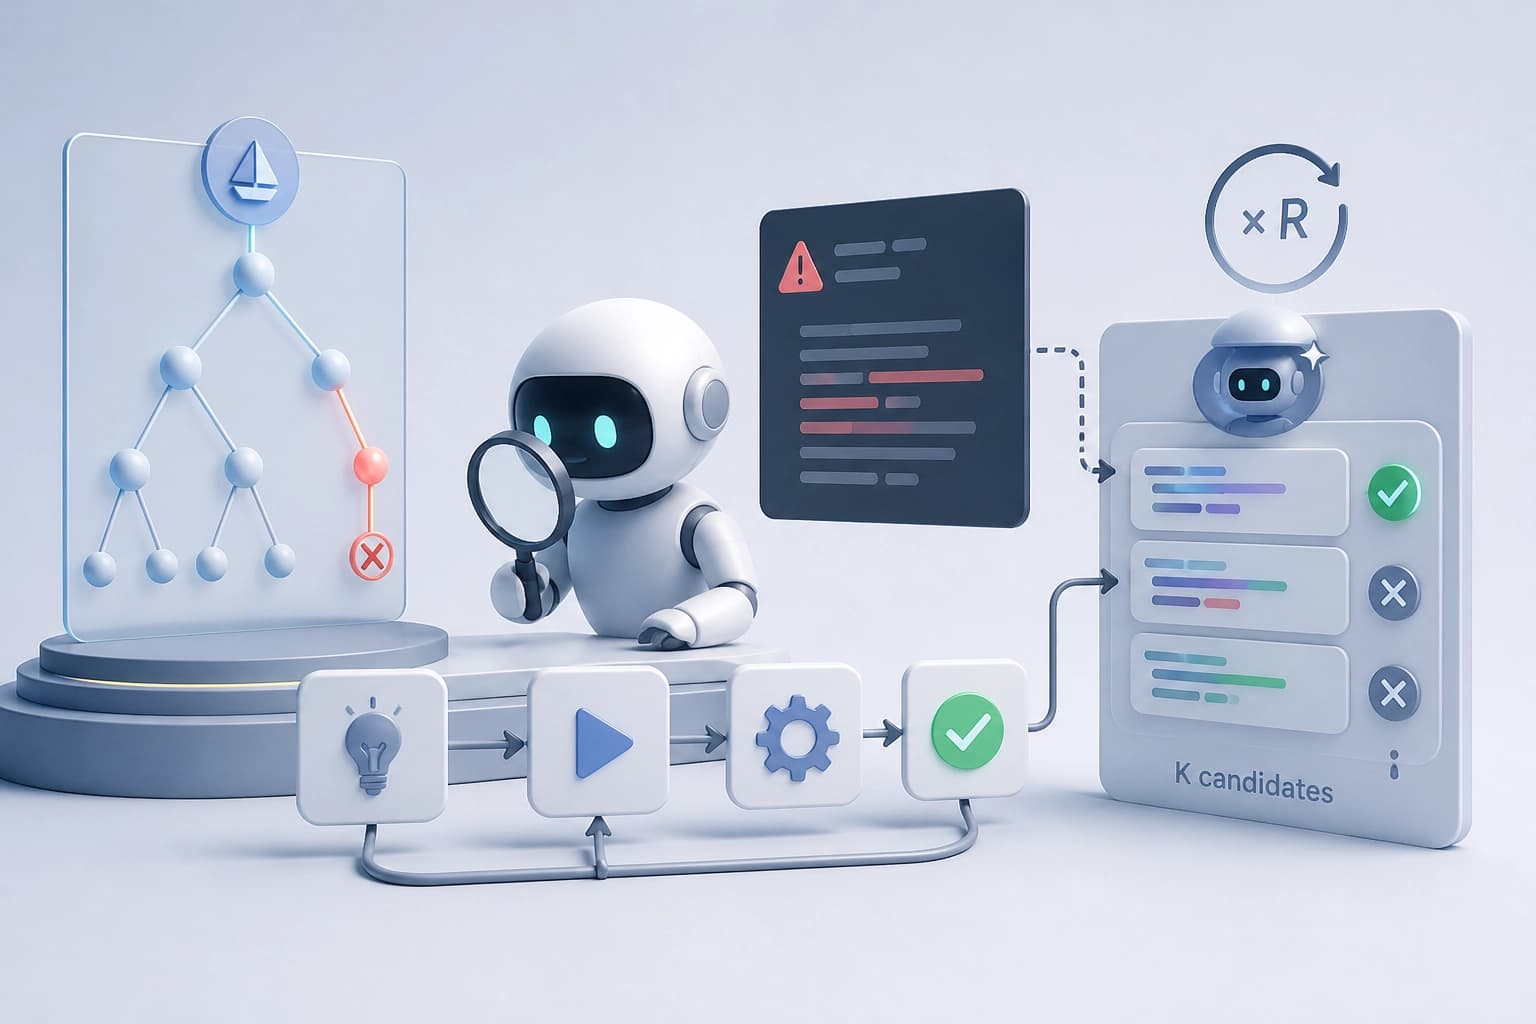
कंपाइलर डायग्नोस्टिक्स पर आधारित Lean 4 में रणनीतियों की सीमित मरम्मत
एक चरण-दर-चरण मॉड्यूल पेश किया गया है, जो अस्वीकृत रणनीति को छोड़ने के बजाय, सुधारक मॉडल को Lean की त्रुटि के आधार पर उसे अधिकतम R बार सुधारने का निर्देश देता है; K उम्मीदवारों के साथ इससे हल की गई समस्याओं का अनुपात बढ़ता है। LeanDojo और Lean Workbook पर किए गए प्रयोगों से पता चलता है कि यह बढ़ोतरी मुख्यतः निष्पादन की सतही विफलताओं को ठीक करने से आती है, जिसकी कीमत खोज में लगने वाला अधिक समय है।
16 नवम्बर 2026
Genesis Steering विधि: फ़ाइन-ट्यूनिंग के लिए उपयोग किए गए डेटा पर एक्टिवेशन स्टीयरिंग
यह विधि फ़ाइन-ट्यूनिंग डेटा में मौजूद कंट्रास्टिव उदाहरणों से नियंत्रण वेक्टर निकालती है और, उनके अनुपलब्ध होने पर, मेंबरशिप इन्फ़रेंस के ज़रिए संभावित प्रशिक्षण नमूने चुनकर एक प्रॉक्सी डेटासेट तैयार करती है। सैद्धांतिक भाग निर्णय सीमा की ओर इष्टतम विस्थापन और प्रॉक्सी डेटा के आधार पर अनुमान का वर्णन करता है; अनुभवजन्य रूप से, Tülu-3-8B के आंतरिक डेटा का प्रभाव बाहरी डेटासेट की तुलना में अधिक स्पष्ट है, जबकि Llama-3.1-8B-Instruct पर MIA-प्रॉक्सी की उपयोगिता दिशा-विस्थापनों के अनुपात से सीमित है।
16 नवम्बर 2026