
Genesis Steering विधि: फ़ाइन-ट्यूनिंग के लिए उपयोग किए गए डेटा पर एक्टिवेशन स्टीयरिंग
यह विधि फ़ाइन-ट्यूनिंग डेटा में मौजूद कंट्रास्टिव उदाहरणों से नियंत्रण वेक्टर निकालती है और, उनके अनुपलब्ध होने पर, मेंबरशिप इन्फ़रेंस के ज़रिए संभावित प्रशिक्षण नमूने चुनकर एक प्रॉक्सी डेटासेट तैयार करती है। सैद्धांतिक भाग निर्णय सीमा की ओर इष्टतम विस्थापन और प्रॉक्सी डेटा के आधार पर अनुमान का वर्णन करता है; अनुभवजन्य रूप से, Tülu-3-8B के आंतरिक डेटा का प्रभाव बाहरी डेटासेट की तुलना में अधिक स्पष्ट है, जबकि Llama-3.1-8B-Instruct पर MIA-प्रॉक्सी की उपयोगिता दिशा-विस्थापनों के अनुपात से सीमित है।
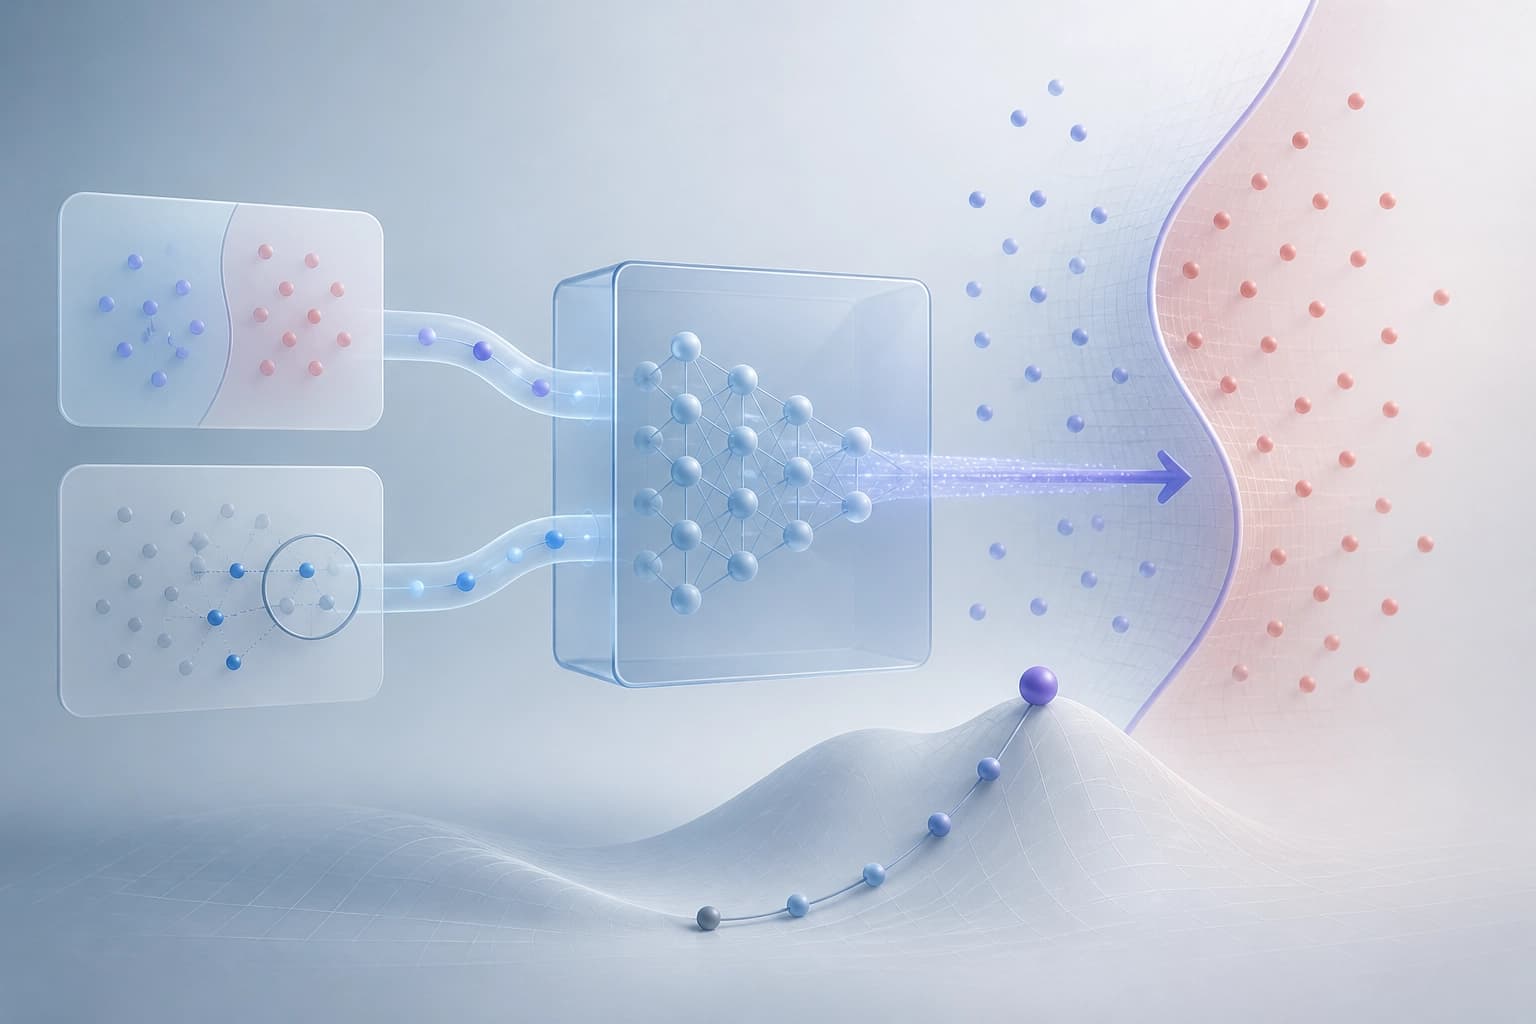
Genesis Steering क्या है
Activation steering, inference के दौरान बड़े भाषा मॉडल को नियंत्रित करता है। इस विधि की प्रभावशीलता संदर्भ डेटा के चुनाव पर निर्भर करती है। Genesis steering, मॉडल के अपने fine-tuning डेटा के कंट्रास्टिव उदाहरणों पर genesis vector बनाता है।
यदि यह डेटा उपलब्ध नहीं है, तो विधि membership inference साहित्य में वर्णित तरीकों का उपयोग करती है। ये तरीके संभावित प्रशिक्षण उदाहरणों को खोजते हैं और एक proxy डेटासेट तैयार करते हैं।
लेख «Genesis Steering: Better Activation Steering Through Training Data» 13 Oct 2026 (v1) को प्रस्तुत किया गया। अपडेट — 19 Oct 2026 (v2)। लेखक: Tora Bodin, Eric Aubinais, Ilaria Torre, Chih-Hong Cheng।
निष्कर्ष: Genesis steering, steering को fine-tuning डेटा से जोड़ता है। मुख्य पैरामीटर कंट्रास्टिव उदाहरणों का स्रोत है।
genesis vector कैसे बनाया जाता है
यह विधि fine-tuning डेटा से कंट्रास्टिव उदाहरण लेती है। इनके आधार पर दिशा का एक वेक्टर बनाया जाता है। इस वेक्टर को inference के दौरान मॉडल पर लागू किया जाता है।
लेखक दो सैद्धांतिक परिणाम स्थापित करते हैं। पहला — निर्णय सीमा की ओर इष्टतम पूर्वाग्रह के बारे में। दूसरा — proxy डेटा पर मूल्यांकन करते समय पूर्वाग्रह कम होने के बारे में।
निष्कर्ष: सिद्धांत पूर्वाग्रह के लिए दिशानिर्देश तय करता है। वेक्टर की गुणवत्ता कंट्रास्टिव उदाहरणों के चुनाव पर निर्भर करती है।
membership inference के ज़रिए proxy डेटा
जब fine-tuning डेटा उपलब्ध नहीं होता, तो विधि membership inference का सहारा लेती है। यह तरीका संभावित प्रशिक्षण उदाहरणों को खोजता है। मिले हुए उदाहरणों से proxy डेटासेट तैयार किया जाता है।
genesis vector बनाते समय proxy डेटासेट, मूल डेटा की जगह काम करता है। विधि मिले हुए उदाहरणों को संदर्भ के रूप में इस्तेमाल करती है। अंतर केवल उदाहरणों के स्रोत का है।
निष्कर्ष: proxy डेटासेट विधि की प्रयोज्यता बढ़ाता है। इसे लागू करने की कसौटी fine-tuning डेटा तक पहुँच का न होना है।
मॉडल पर मूल्यांकनों से क्या पता चला
Tülu-3-8B और Llama-3.1-8B-Instruct पर मूल्यांकन किए गए। Tülu-3-8B का fine-tuning डेटा सार्वजनिक रूप से उपलब्ध है। Llama-3.1-8B-Instruct का उपयोग नियंत्रण मॉडल के रूप में किया गया।
Tülu-3-8B के प्रशिक्षण मिश्रण से मिले सुरक्षा डेटा ने बाहरी डेटासेट की तुलना में अधिक मजबूत steering दिया। यह दोनों मॉडलों के लिए सही है।
Tülu-3-8B पर, प्रशिक्षण उदाहरणों की पहचान करते समय membership स्कोर काफी हद तक एक-दूसरे से मेल खाते थे। सबसे ऊँचे स्कोर वाले उदाहरणों से बने वेक्टरों ने उसी आकार के यादृच्छिक उपसमूहों के बराबर परिणाम दिए।
Llama-3.1-8B-Instruct के नतीजे MIA के लिए एक शर्त तय करते हैं। विधि तभी सकारात्मक प्रभाव देगी, जब फ़िल्टर किए गए MIA इन-डोमेन डेटा के लिए दिशा का औसत बदलाव, OoD डेटा के बदलाव से काफ़ी कम हो।
निष्कर्ष: मॉडल का अपना fine-tuning डेटा, बाहरी डेटासेट की तुलना में अधिक मजबूत steering देता है। MIA के लिए दिशा में बदलाव की शर्त जाँचना ज़रूरी है।
चुनाव के व्यावहारिक मानदंड
विधि का चुनाव fine-tuning डेटा तक पहुँच पर निर्भर करता है। नीचे दी गई तालिका स्थिति, कार्रवाई और जाँच के बीच संबंध बताती है।
| स्थिति | कार्रवाई | जाँच |
|---|---|---|
| Fine-tuning डेटा उपलब्ध है | उस डेटा के कंट्रास्टिव उदाहरणों पर genesis vector बनाना | बाहरी डेटासेट से तुलना |
| डेटा उपलब्ध नहीं है | membership inference के ज़रिए संभावित प्रशिक्षण उदाहरण खोजना और proxy डेटासेट तैयार करना | दिशा के औसत बदलाव की शर्त जाँचना |
| Proxy डेटासेट तैयार है | सबसे ऊँचे स्कोर वाले उदाहरणों पर वेक्टर बनाना | उसी आकार के यादृच्छिक उपसमूहों से तुलना |
निष्कर्ष: Genesis steering का चुनाव fine-tuning डेटा की उपलब्धता के आधार पर किया जाता है। Proxy डेटासेट के लिए दिशा में बदलाव की शर्त जाँचें और यादृच्छिक उपसमूहों से तुलना करें।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
विरल विशेषज्ञों के साथ इन-कॉन्टेक्स्ट सारणीबद्ध शिक्षण: कॉम्पैक्ट OrionMoE-Small-v1.0
टैब्युलर कार्यों के लिए एक कॉम्पैक्ट बेस मॉडल प्रस्तुत किया गया है, जो पैरामीटर को फ़ाइन-ट्यून किए बिना लेबल वाली संदर्भ तालिका के आधार पर नए अवलोकनों की भविष्यवाणी करता है। डेटासेट और फ़ीचर प्रस्तुतियों के आधार पर विशेषज्ञों का अनुकूल चयन प्रतिस्पर्धी परिणाम देता है, विशेष रूप से कम संदर्भ और उच्च आयाम की स्थिति में।
15 नवम्बर 2026
अविश्वसनीय भविष्यवाणियों वाली प्रोफ़ाइलों के लिए कॉवेरिएट शिफ्ट की स्थानीय खोज
लेख एक नैदानिक पाइपलाइन का वर्णन करता है, जो पहले मॉडल के कम आत्मविश्वास वाले व्याख्यायोग्य रोगी समूहों की पहचान करती है और फिर इन समूहों के भीतर हानिकारक सहचर-परिवर्तन की मौजूदगी की जाँच करती है। तीन क्लिनिकल कार्यों और तीन कृत्रिम उपसमूह बदलावों के साथ MIMIC-IV पर किए गए प्रयोगों में, इस दृष्टिकोण ने उम्र-संबंधी बदलाव का पता लगाने में मदद की, जो समेकित मूल्यांकन में मुश्किल से दिखाई देता था।
15 नवम्बर 2026
FedPix: फ़ेडरेटेड लर्निंग में डेटा लीक कम करने के लिए क्लाइंट से संपीड़ित छवियों का स्थानांतरण
यह लेख इस बात की पड़ताल करता है कि क्लाइंट को सर्वर पर कौन-सी जानकारी भेजने की अनुमति दी जानी चाहिए, और मॉडल वज़न या मध्यवर्ती निरूपणों के बजाय छोटे, दृश्य रूप से जाँचे जा सकने वाले चित्रों का प्रसारण प्रशिक्षित करने का प्रस्ताव देता है। BloodMNIST, CIFAR-10, FashionMNIST और MNIST पर यह तरीका पुनर्निर्माण में कम PSNR दिखाता है और 65,63–99,18% सटीकता के साथ क्लाइंट का समय 96,0% तक घटाता है।
15 नवम्बर 2026