
LightCRS: प्रत्येक श्रेणी के लिए अलग VLM के बिना संवादात्मक अनुशंसाओं की कॉम्पैक्ट बहु-डोमेन योजना
लेखक ऐसी प्रणाली प्रस्तुत करते हैं जिसमें उत्पादों के मल्टीमॉडल फीचर्स की गणना ऑफ़लाइन फ़्रीज़ किए गए एन्कोडर्स द्वारा की जाती है, और संवाद के दौरान उन्हें सभी डोमेन के लिए साझा 5.3 मिलियन पैरामीटर वाले मॉड्यूल द्वारा संसाधित किया जाता है, जिसमें क्वेरी पर निर्भर क्रॉस-अटेंशन है। 25 डोमेन के बेंचमार्क पर यह तरीका रैंकिंग के औसत मेट्रिक्स को बेहतर बनाता है, विलंबता को काफ़ी कम करता है और दिखाता है कि संयुक्त प्रशिक्षण से अलग-अलग एकल-डोमेन मॉडल की तुलना में बेहतर परिणाम मिलते हैं।
कार्य: प्रत्येक डोमेन के लिए अलग VLM के बिना संवादात्मक अनुशंसाएँ
LightCRS कई डोमेन के लिए एक हल्की मल्टीमॉडल संवादात्मक अनुशंसा प्रणाली है। इस शोध पर He Ma, Lan You, Qiyang Wu और Chen Liu ने काम किया। arXiv प्रीप्रिंट 2610.26948, 18 अक्टूबर 2026 को प्रस्तुत किया गया।
मुख्य विशेषताएँ:
- संवादात्मक मोड में काम करती है।
- उत्पादों के बारे में मल्टीमॉडल डेटा का उपयोग करती है।
- एक ही प्रणाली में कई डोमेन शामिल हैं।
- हर श्रेणी के लिए अलग VLM के बिना हल्का आर्किटेक्चर।
यह प्रणाली संवाद में उत्पाद चुनने की समस्या हल करती है। उपयोगकर्ता कई डोमेन में अनुशंसा खोजता है। व्यावहारिक मानदंड: ऐसे डिज़ाइनों पर ध्यान दें जो कई डोमेन का समर्थन करते हों और हर श्रेणी के लिए अलग VLM की ज़रूरत न हो।
आर्किटेक्चर: ऑफ़लाइन एनकोडर और 5.3M का साझा मॉड्यूल
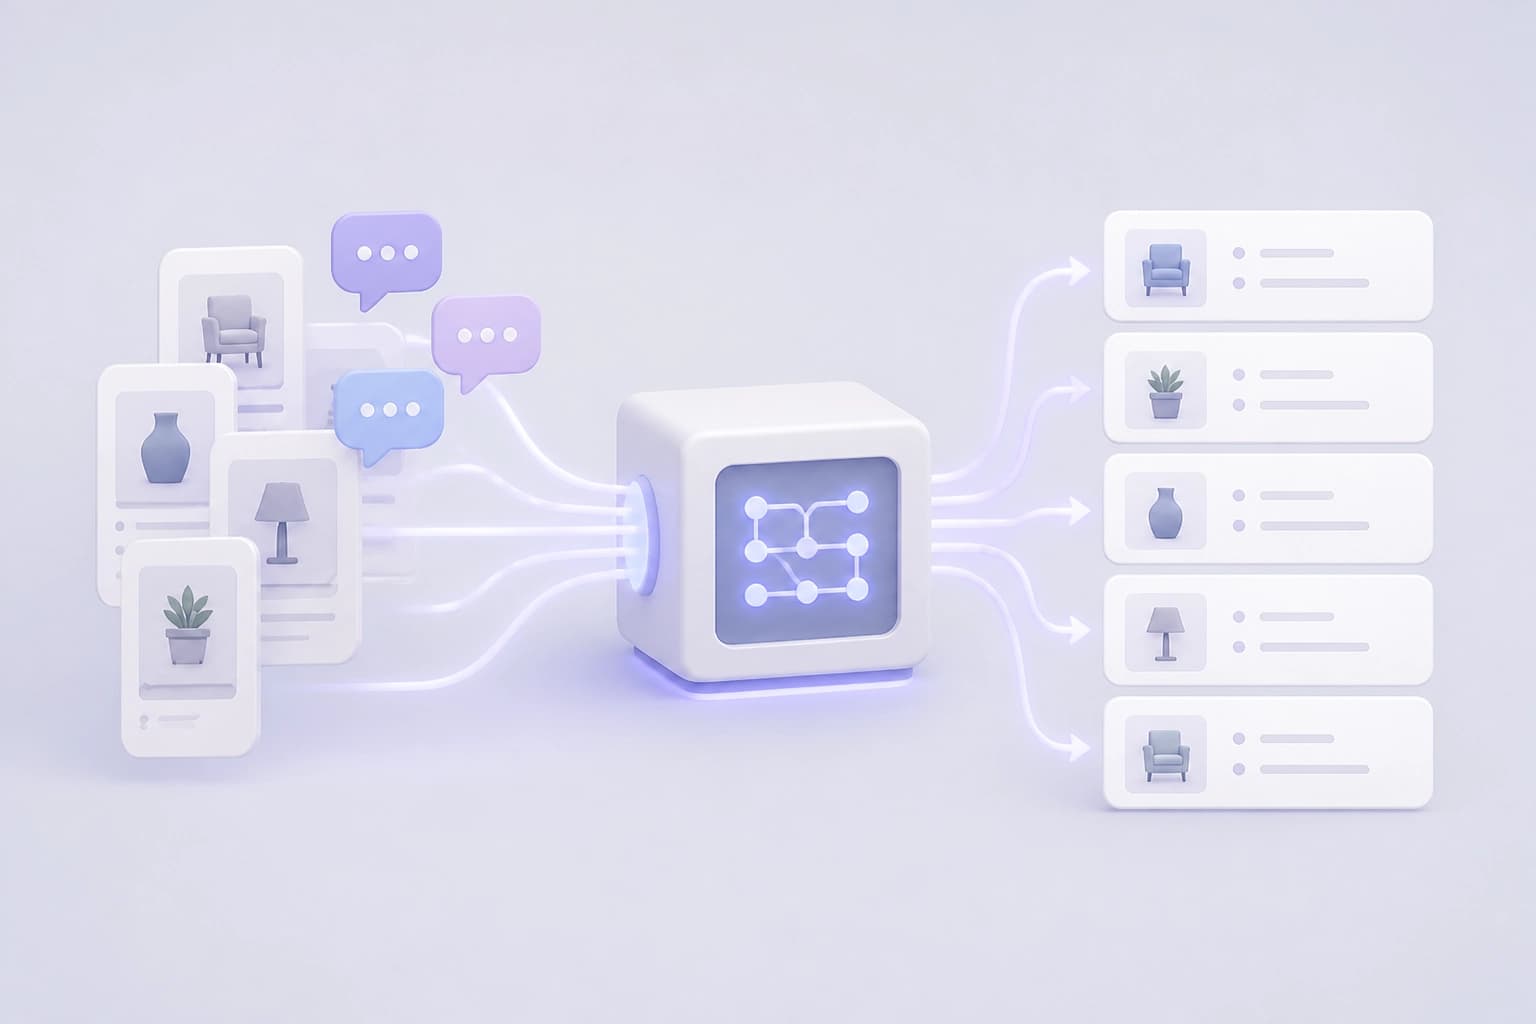
LightCRS में उत्पादों के मल्टीमॉडल निरूपण पहले से ऑफ़लाइन गणना करके तैयार किए जाते हैं। इसके लिए फ़्रीज़ किए गए एनकोडर इस्तेमाल किए जाते हैं।
रनटाइम के चरण:
- 5.3M पैरामीटर वाला एक कॉम्पैक्ट मॉड्यूल संवाद के डेटा को एक साथ जोड़ता है।
- क्वेरी और निरूपणों के बीच संबंध query-conditioned cross-attention के ज़रिए बनता है।
- inter-candidate Transformer उम्मीदवारों की तुलना एक साथ करता है।
मॉड्यूल के पैरामीटर सभी डोमेन के लिए साझा हैं। व्यावहारिक मानदंड: जाँचें कि कौन-से घटक ऑफ़लाइन किए गए हैं और रनटाइम में कितने पैरामीटर बचते हैं। मल्टीडोमेन डिज़ाइन में अलग-अलग मॉडलों के समूह के बजाय एक साझा मॉड्यूल अहम है।
मल्टीडोमेन क्षमता: साझा पैरामीटर और संयुक्त प्रशिक्षण
LightCRS सभी डोमेन के लिए पैरामीटरों का एक साझा सेट इस्तेमाल करता है। यही इसे हर श्रेणी के लिए अलग मॉडल वाले दृष्टिकोण से अलग करता है।
| प्रशिक्षण का तरीका | HR@1 |
|---|---|
| कई डोमेन पर संयुक्त प्रशिक्षण | एकल-डोमेन मॉडलों से +15.2% |
| अलग-अलग प्रशिक्षित एकल-डोमेन मॉडल | तुलना का आधार |
संयुक्त प्रशिक्षण एक अलग कारक है। व्यावहारिक मानदंड: HR@1 के आधार पर साझा मल्टीडोमेन मॉड्यूल की तुलना एकल-डोमेन मॉडलों के समूह से करें। संयुक्त प्रशिक्षण के प्रभाव को मान लेने के बजाय मापना चाहिए।
बेंचमार्क MM-R2A-25: Reddit और Amazon के 25 डोमेन
मूल्यांकन के लिए लेखकों ने MM-R2A-25 बनाया।
बेंचमार्क की संरचना:
- 25 डोमेन।
- Reddit से लिए गए स्वाभाविक संवाद, जिनमें उपयोगकर्ता अनुशंसाएँ खोजते हैं।
- Amazon की उत्पाद सूची।
LightCRS का मूल्यांकन इस डेटासेट पर किया जाता है। बेंचमार्क अलग-अलग डोमेन और स्वाभाविक संवादों पर प्रणाली की जाँच करता है। यह केवल एक प्रकार के उत्पादों तक सीमित नहीं है।
व्यावहारिक मानदंड: देखें कि प्रणाली का मूल्यांकन किन डोमेन और संवादों पर किया गया है। केवल एक श्रेणी की रिपोर्ट की तुलना में मल्टीडोमेन बेंचमार्क अधिक उपयोगी है।
परिणाम: HR@1, NDCG@5, MRR और विलंबता
LightCRS की तुलना तीन मेट्रिक्स और विलंबता के आधार पर बेसलाइन तरीकों से की जाती है।
| मापदंड | LightCRS का परिणाम |
|---|---|
| HR@1, NDCG@5 और MRR के औसत परिणाम | सर्वश्रेष्ठ |
| सबसे मज़बूत बेसलाइन तरीके की तुलना में HR@1 | +35.4% |
| प्रति क्वेरी विलंबता | 266 गुना कम |
वर्णित तुलना में गुणवत्ता में बढ़त के साथ विलंबता में कई गुना कमी भी आती है। व्यावहारिक मानदंड: केवल HR@1 ही नहीं, बल्कि NDCG@5, MRR और विलंबता भी देखें। कोई एक मापदंड गुणवत्ता और विलंबता के बीच के संतुलन को नहीं दर्शाता।
ऐसा डिज़ाइन चुनते समय किन बातों की जाँच करें
- सभी डोमेन के लिए साझा पैरामीटर।
- फ़्रीज़ किए गए एनकोडर से मल्टीमॉडल निरूपणों की ऑफ़लाइन एन्कोडिंग।
- रनटाइम मॉड्यूल का आकार: LightCRS में 5.3M पैरामीटर।
- inter-candidate Transformer के ज़रिए उम्मीदवारों की संयुक्त तुलना।
- HR@1, NDCG@5, MRR और प्रति क्वेरी विलंबता जैसे मेट्रिक्स के साथ मल्टीडोमेन संवादों पर मूल्यांकन।
व्यावहारिक मानदंड: प्रकाशित मेट्रिक्स और बेंचमार्क की शर्तों की माँग करें। कई डोमेन होने पर साझा कॉम्पैक्ट मॉड्यूल वाला डिज़ाइन उपयोगी है, खासकर तब जब रनटाइम को हल्का रखना हो।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री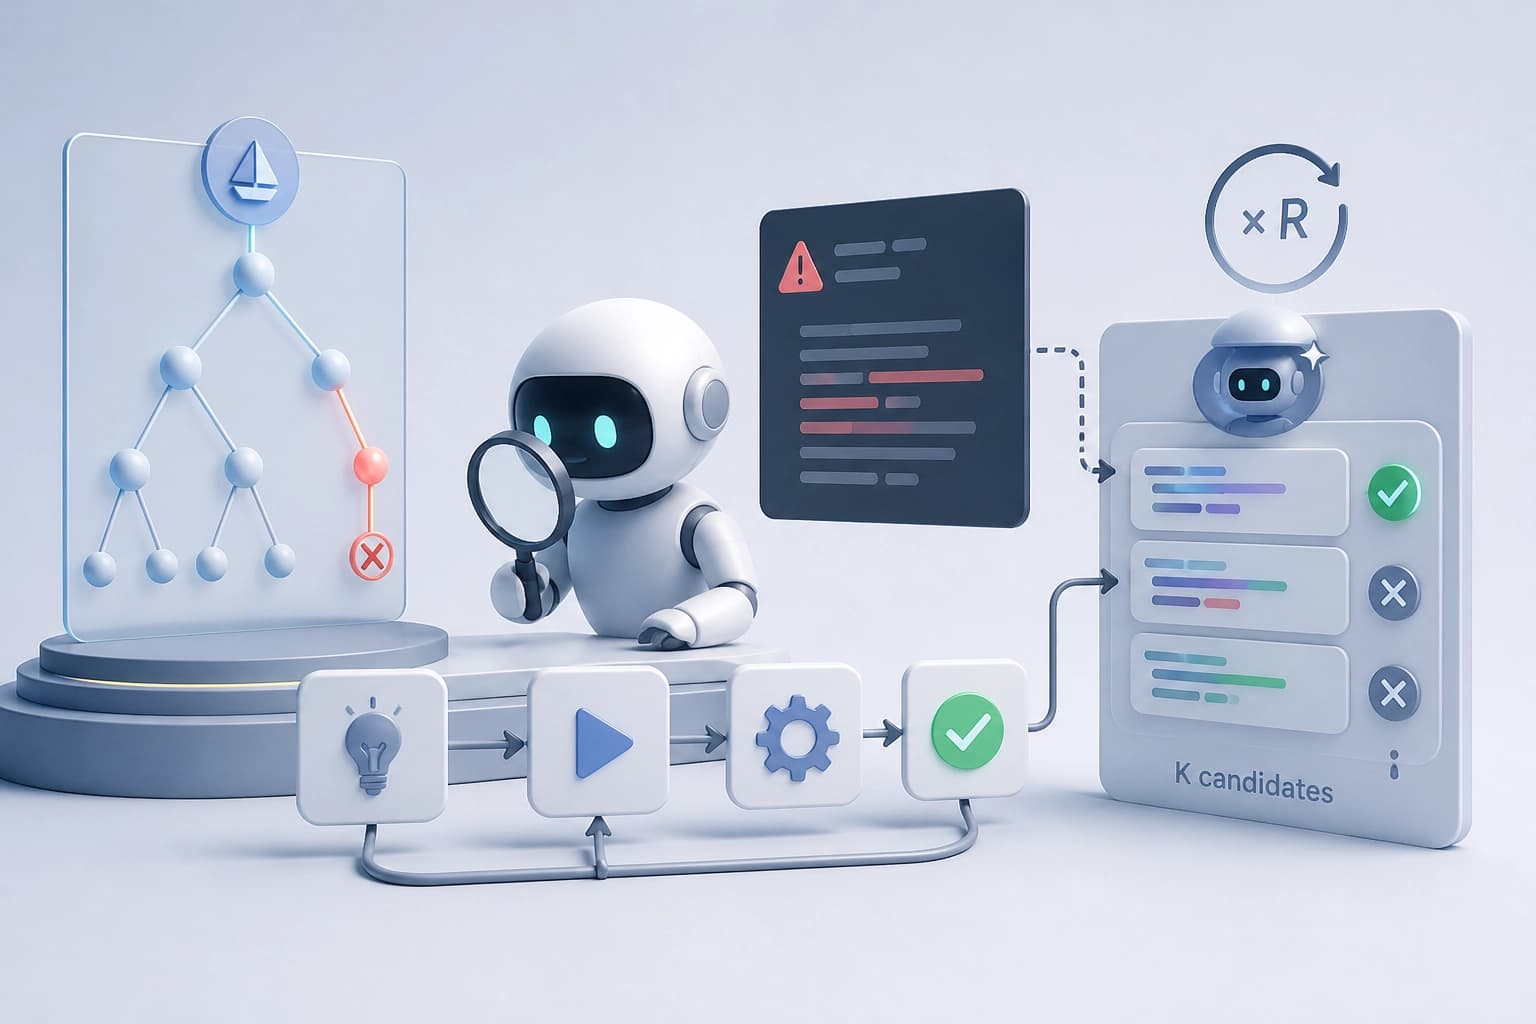
कंपाइलर डायग्नोस्टिक्स पर आधारित Lean 4 में रणनीतियों की सीमित मरम्मत
एक चरण-दर-चरण मॉड्यूल पेश किया गया है, जो अस्वीकृत रणनीति को छोड़ने के बजाय, सुधारक मॉडल को Lean की त्रुटि के आधार पर उसे अधिकतम R बार सुधारने का निर्देश देता है; K उम्मीदवारों के साथ इससे हल की गई समस्याओं का अनुपात बढ़ता है। LeanDojo और Lean Workbook पर किए गए प्रयोगों से पता चलता है कि यह बढ़ोतरी मुख्यतः निष्पादन की सतही विफलताओं को ठीक करने से आती है, जिसकी कीमत खोज में लगने वाला अधिक समय है।
16 नवम्बर 2026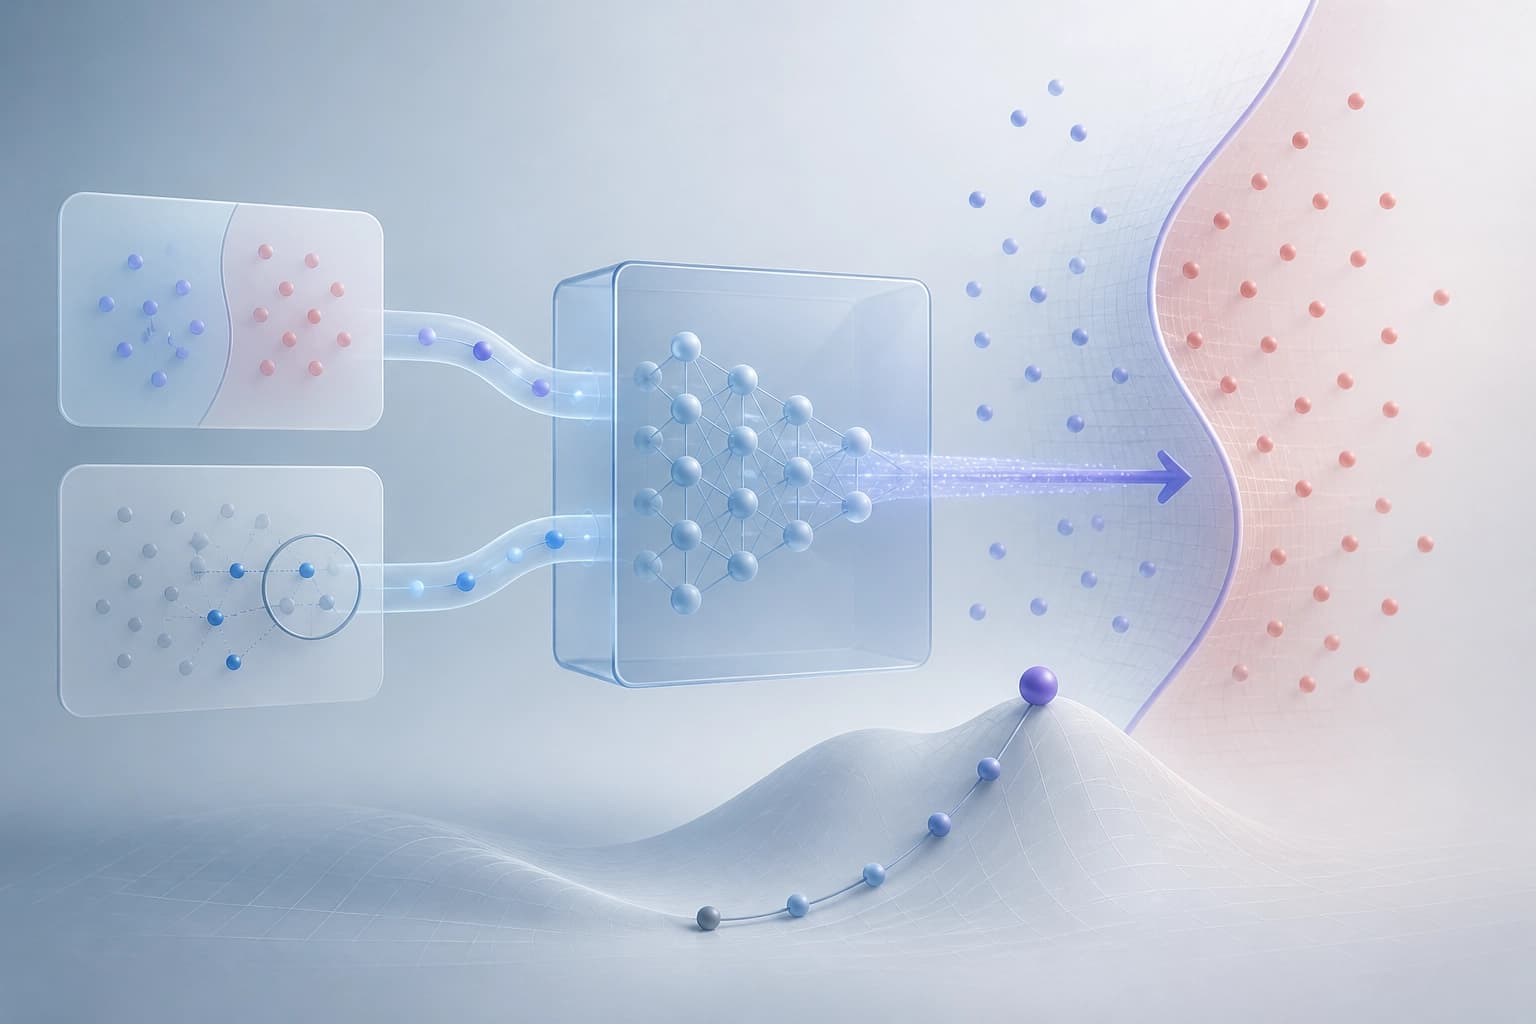
Genesis Steering विधि: फ़ाइन-ट्यूनिंग के लिए उपयोग किए गए डेटा पर एक्टिवेशन स्टीयरिंग
यह विधि फ़ाइन-ट्यूनिंग डेटा में मौजूद कंट्रास्टिव उदाहरणों से नियंत्रण वेक्टर निकालती है और, उनके अनुपलब्ध होने पर, मेंबरशिप इन्फ़रेंस के ज़रिए संभावित प्रशिक्षण नमूने चुनकर एक प्रॉक्सी डेटासेट तैयार करती है। सैद्धांतिक भाग निर्णय सीमा की ओर इष्टतम विस्थापन और प्रॉक्सी डेटा के आधार पर अनुमान का वर्णन करता है; अनुभवजन्य रूप से, Tülu-3-8B के आंतरिक डेटा का प्रभाव बाहरी डेटासेट की तुलना में अधिक स्पष्ट है, जबकि Llama-3.1-8B-Instruct पर MIA-प्रॉक्सी की उपयोगिता दिशा-विस्थापनों के अनुपात से सीमित है।
16 नवम्बर 2026
विरल विशेषज्ञों के साथ इन-कॉन्टेक्स्ट सारणीबद्ध शिक्षण: कॉम्पैक्ट OrionMoE-Small-v1.0
टैब्युलर कार्यों के लिए एक कॉम्पैक्ट बेस मॉडल प्रस्तुत किया गया है, जो पैरामीटर को फ़ाइन-ट्यून किए बिना लेबल वाली संदर्भ तालिका के आधार पर नए अवलोकनों की भविष्यवाणी करता है। डेटासेट और फ़ीचर प्रस्तुतियों के आधार पर विशेषज्ञों का अनुकूल चयन प्रतिस्पर्धी परिणाम देता है, विशेष रूप से कम संदर्भ और उच्च आयाम की स्थिति में।
15 नवम्बर 2026