
विरल विशेषज्ञों के साथ इन-कॉन्टेक्स्ट सारणीबद्ध शिक्षण: कॉम्पैक्ट OrionMoE-Small-v1.0
टैब्युलर कार्यों के लिए एक कॉम्पैक्ट बेस मॉडल प्रस्तुत किया गया है, जो पैरामीटर को फ़ाइन-ट्यून किए बिना लेबल वाली संदर्भ तालिका के आधार पर नए अवलोकनों की भविष्यवाणी करता है। डेटासेट और फ़ीचर प्रस्तुतियों के आधार पर विशेषज्ञों का अनुकूल चयन प्रतिस्पर्धी परिणाम देता है, विशेष रूप से कम संदर्भ और उच्च आयाम की स्थिति में।
संदर्भ में सीखना: इस मोड का सार
मॉडल लेबलयुक्त समर्थन तालिका के आधार पर अनदेखे अवलोकनों का पूर्वानुमान लगाता है। मॉडल किसी खास कार्य के लिए पैरामीटर अपडेट नहीं करता। लेख OrionMoE-Small-v1.0 का वर्णन करता है — संदर्भ में सीखने के लिए एक कॉम्पैक्ट टैबुलर बेस मॉडल।
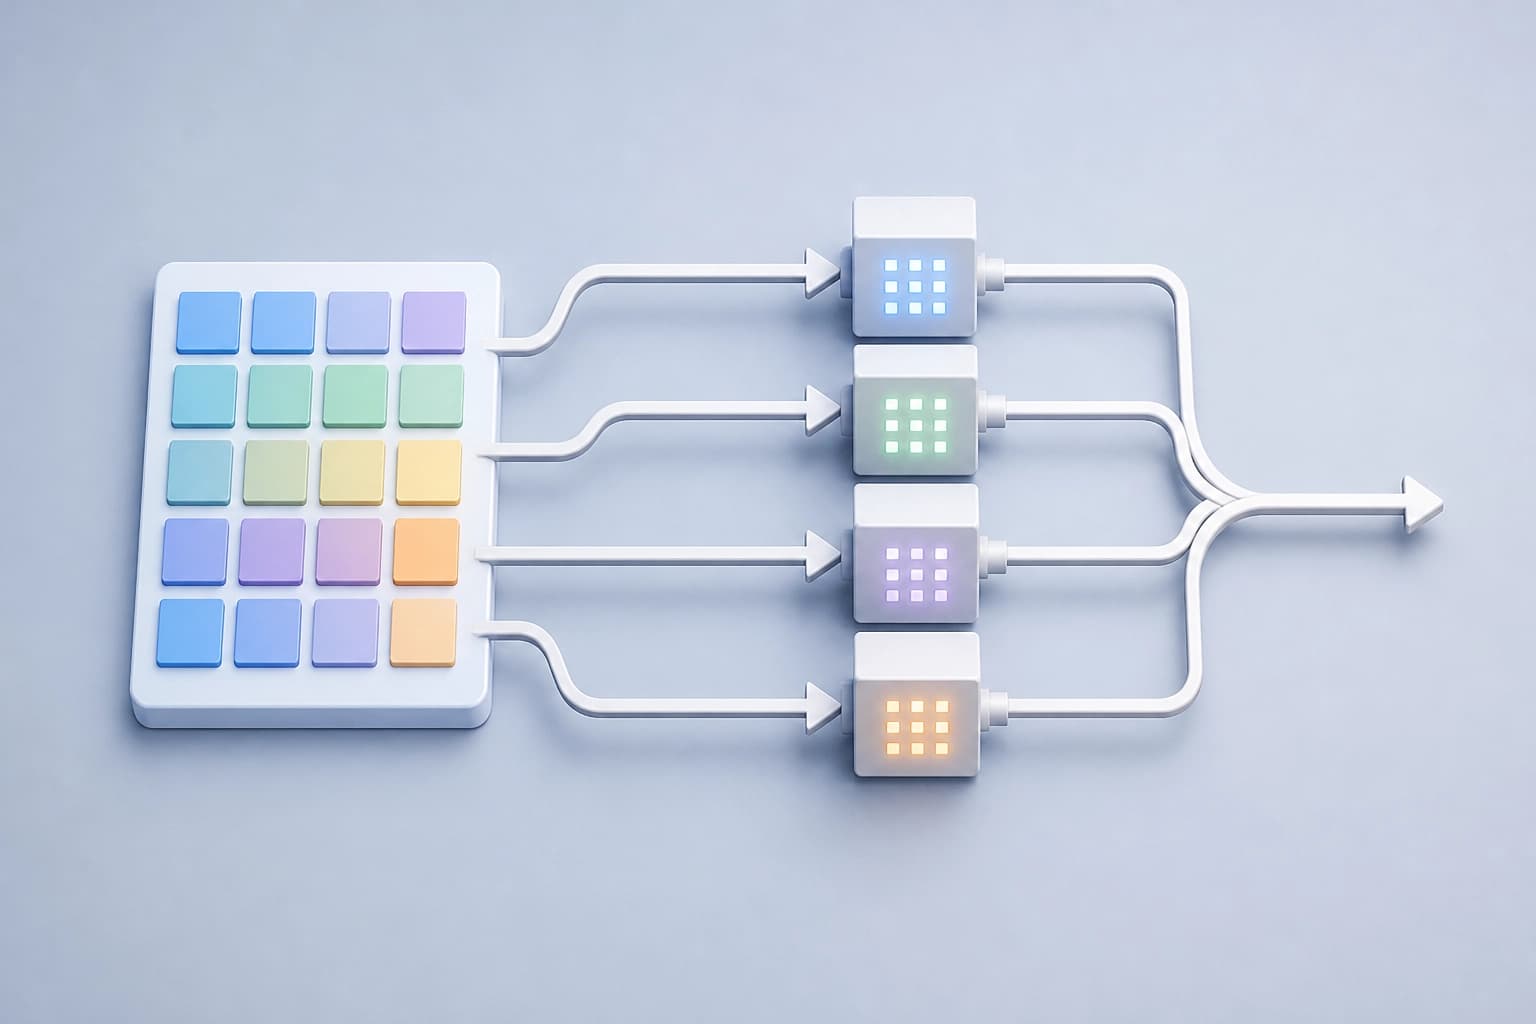
इस मोड के मुख्य तत्व:
- इनपुट — लेबलयुक्त समर्थन तालिका;
- लक्ष्य — अनदेखे अवलोकनों का पूर्वानुमान लगाना;
- अनुकूलन — किसी खास कार्य के लिए पैरामीटर अपडेट किए बिना;
- मोड — संदर्भ में सीखना।
व्यावहारिक कसौटी: कार्य में लेबलयुक्त समर्थन तालिका के आधार पर पूर्वानुमान लगाना संभव होना चाहिए। कार्य के लिए ग्रेडिएंट-आधारित अनुकूलन की आवश्यकता नहीं है।
आर्किटेक्चर: dual-axis transformer और विरल विशेषज्ञ
OrionMoE-Small-v1.0 का आधार dual-axis transformer आर्किटेक्चर है। मॉडल डेटा-वितरण को ध्यान में रखने वाले निरूपणों को विरल मिश्रित-विशेषज्ञ गणनाओं के साथ जोड़ता है। ये गणनाएँ डेटासेट पर निर्भर होती हैं। सक्रिय किए जाने वाले विशेषज्ञों का चयन अलग-अलग सेल के निरूपणों और पूरे डेटासेट के संदर्भ को ध्यान में रखता है।
मॉडल की संरचना:
- आर्किटेक्चर — dual-axis transformer;
- निरूपण — डेटा-वितरण को ध्यान में रखते हुए;
- गणनाएँ — डेटासेट पर निर्भर विरल मिश्रित-विशेषज्ञ गणनाएँ;
- विशेषज्ञों का चयन — सेल के निरूपणों और डेटासेट के संदर्भ के आधार पर;
- गणनाओं का वितरण — विषम टैबुलर कार्यों के बीच अनुकूली;
- गणना-पथ — अलग-अलग कार्यों के लिए साझा।
व्यावहारिक कसौटी: विषम टैबुलर कार्यों में गणनाओं का अनुकूली वितरण आवश्यक होता है। मॉडल अलग-अलग कार्यों के लिए एक साझा गणना-पथ बनाए रखता है।
प्रशिक्षण: सिंथेटिक वर्गीकरण कार्य
मॉडल का पूर्व-प्रशिक्षण केवल सिंथेटिक वर्गीकरण कार्यों पर किया गया। इन कार्यों का आधार एक संरचित कारणात्मक पूर्व वितरण है। बाद के कार्यों के लिए मॉडल ग्रेडिएंट-आधारित अनुकूलन के बिना पूर्वानुमान करता है। एनोटेशन में OrionMoE-Small-v1.0 नाम दिया गया है।
लेख के लेखक: Mohamed Bouadi, Nassim Bouarour, Aditya Tanna, Vinay Kumar Sankarapu। लेखकों ने लेख 14 अक्टूबर 2026 को प्रस्तुत किया। इसका नवीनतम संशोधन 18 अक्टूबर 2026 को प्रकाशित हुआ। लेख का संस्करण — v2।
प्रशिक्षण के बारे में ज्ञात बातें:
- डेटा — केवल सिंथेटिक वर्गीकरण कार्य;
- आधार — संरचित कारणात्मक पूर्व वितरण;
- बाद के कार्य — ग्रेडिएंट-आधारित अनुकूलन के बिना।
व्यावहारिक कसौटी: स्रोत में केवल सिंथेटिक वर्गीकरण कार्यों पर पूर्व-प्रशिक्षण का वर्णन है। अन्य प्रकार के कार्यों के बारे में तथ्यात्मक डेटा उपलब्ध नहीं कराया गया है।
परिणाम और उपयोग के मानदंड
OrionMoE-Small-v1.0 ने कई टैबुलर बेंचमार्क पर प्रतिस्पर्धी परिणाम दिखाए। इसकी तुलना इससे काफ़ी बड़े बेस मॉडल से की गई। विश्लेषण में कम संदर्भ और उच्च आयाम वाले डेटासेट पर विशेष रूप से मज़बूत परिणाम सामने आए। अतिरिक्त विश्लेषण में वर्ग-असंतुलन की स्थिति में अनुकूल सापेक्ष परिणाम दिखे।
| परिदृश्य | विश्लेषण में क्या सामने आया |
|---|---|
| इससे काफ़ी बड़े बेस मॉडल के साथ तुलना | प्रतिस्पर्धी परिणाम |
| कम संदर्भ और उच्च आयाम | विशेष रूप से मज़बूत परिणाम |
| वर्ग-असंतुलन | अनुकूल सापेक्ष परिणाम |
| विशेषताओं का संयोजन | विश्लेषण में इसका महत्त्व सामने आया |
व्यावहारिक कसौटी: कम संदर्भ और उच्च आयाम वे स्थितियाँ हैं जिनमें विशेष रूप से मज़बूत परिणाम मिले। वर्ग-असंतुलन और विशेषताओं का संयोजन विश्लेषण के अलग-अलग बिंदु हैं।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री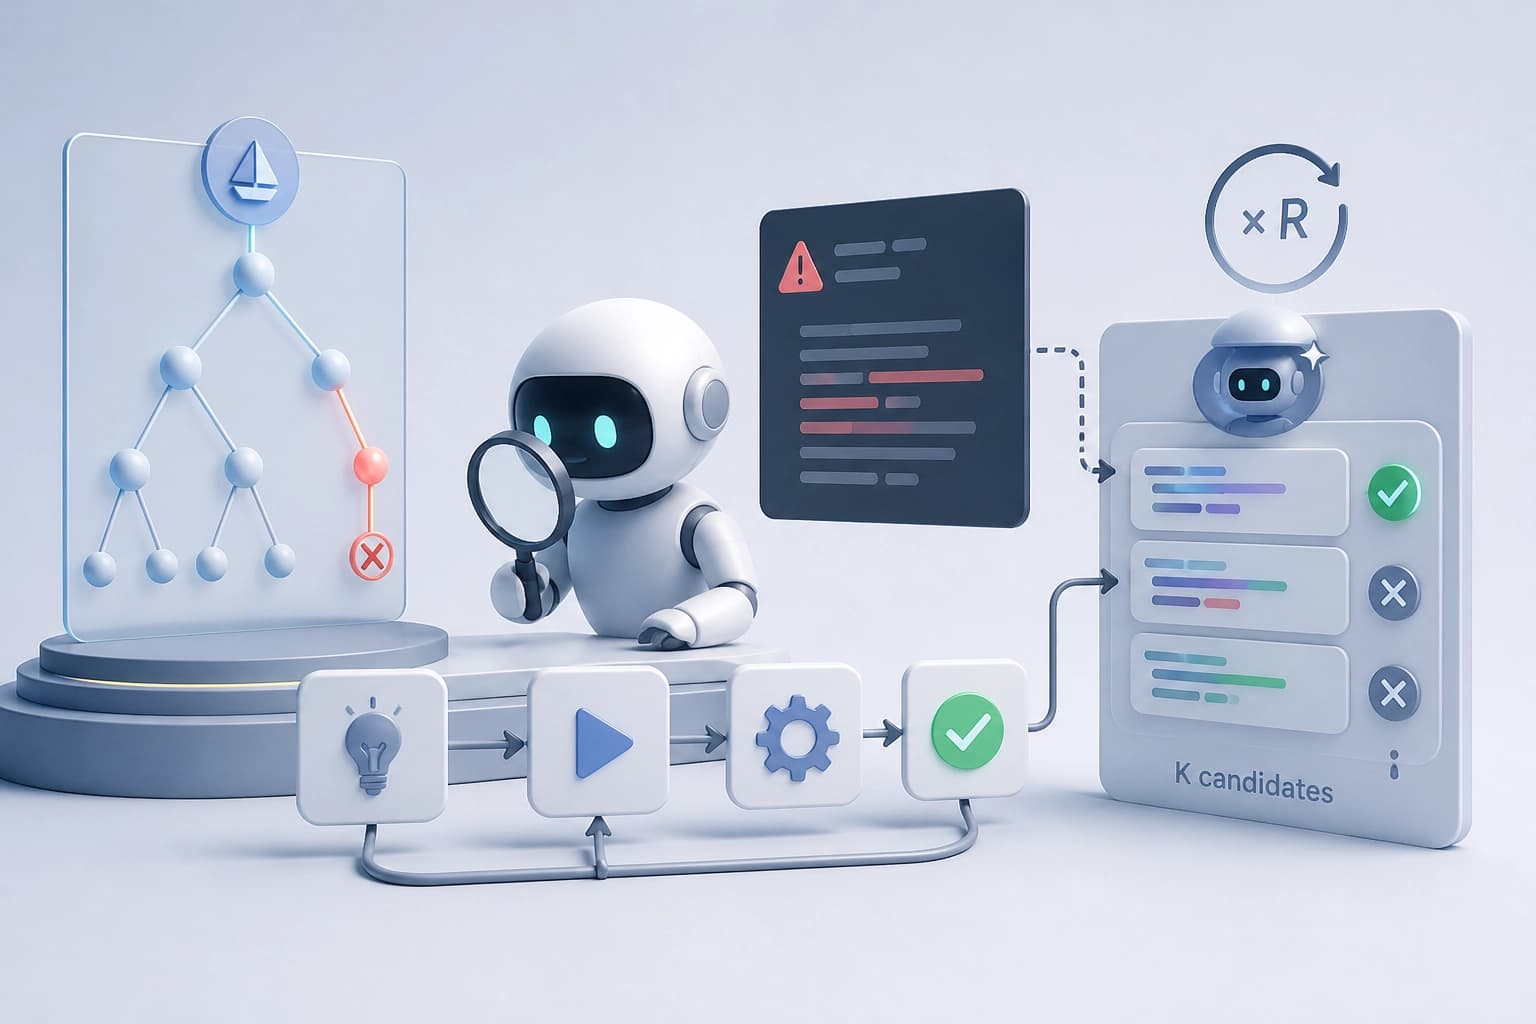
कंपाइलर डायग्नोस्टिक्स पर आधारित Lean 4 में रणनीतियों की सीमित मरम्मत
एक चरण-दर-चरण मॉड्यूल पेश किया गया है, जो अस्वीकृत रणनीति को छोड़ने के बजाय, सुधारक मॉडल को Lean की त्रुटि के आधार पर उसे अधिकतम R बार सुधारने का निर्देश देता है; K उम्मीदवारों के साथ इससे हल की गई समस्याओं का अनुपात बढ़ता है। LeanDojo और Lean Workbook पर किए गए प्रयोगों से पता चलता है कि यह बढ़ोतरी मुख्यतः निष्पादन की सतही विफलताओं को ठीक करने से आती है, जिसकी कीमत खोज में लगने वाला अधिक समय है।
16 नवम्बर 2026
Genesis Steering विधि: फ़ाइन-ट्यूनिंग के लिए उपयोग किए गए डेटा पर एक्टिवेशन स्टीयरिंग
यह विधि फ़ाइन-ट्यूनिंग डेटा में मौजूद कंट्रास्टिव उदाहरणों से नियंत्रण वेक्टर निकालती है और, उनके अनुपलब्ध होने पर, मेंबरशिप इन्फ़रेंस के ज़रिए संभावित प्रशिक्षण नमूने चुनकर एक प्रॉक्सी डेटासेट तैयार करती है। सैद्धांतिक भाग निर्णय सीमा की ओर इष्टतम विस्थापन और प्रॉक्सी डेटा के आधार पर अनुमान का वर्णन करता है; अनुभवजन्य रूप से, Tülu-3-8B के आंतरिक डेटा का प्रभाव बाहरी डेटासेट की तुलना में अधिक स्पष्ट है, जबकि Llama-3.1-8B-Instruct पर MIA-प्रॉक्सी की उपयोगिता दिशा-विस्थापनों के अनुपात से सीमित है।
16 नवम्बर 2026
अविश्वसनीय भविष्यवाणियों वाली प्रोफ़ाइलों के लिए कॉवेरिएट शिफ्ट की स्थानीय खोज
लेख एक नैदानिक पाइपलाइन का वर्णन करता है, जो पहले मॉडल के कम आत्मविश्वास वाले व्याख्यायोग्य रोगी समूहों की पहचान करती है और फिर इन समूहों के भीतर हानिकारक सहचर-परिवर्तन की मौजूदगी की जाँच करती है। तीन क्लिनिकल कार्यों और तीन कृत्रिम उपसमूह बदलावों के साथ MIMIC-IV पर किए गए प्रयोगों में, इस दृष्टिकोण ने उम्र-संबंधी बदलाव का पता लगाने में मदद की, जो समेकित मूल्यांकन में मुश्किल से दिखाई देता था।
15 नवम्बर 2026