
अविश्वसनीय भविष्यवाणियों वाली प्रोफ़ाइलों के लिए कॉवेरिएट शिफ्ट की स्थानीय खोज
लेख एक नैदानिक पाइपलाइन का वर्णन करता है, जो पहले मॉडल के कम आत्मविश्वास वाले व्याख्यायोग्य रोगी समूहों की पहचान करती है और फिर इन समूहों के भीतर हानिकारक सहचर-परिवर्तन की मौजूदगी की जाँच करती है। तीन क्लिनिकल कार्यों और तीन कृत्रिम उपसमूह बदलावों के साथ MIMIC-IV पर किए गए प्रयोगों में, इस दृष्टिकोण ने उम्र-संबंधी बदलाव का पता लगाने में मदद की, जो समेकित मूल्यांकन में मुश्किल से दिखाई देता था।
औसत प्रदर्शन यह नहीं बताता कि किसे नुकसान हुआ
क्लिनिकल पूर्वानुमान मॉडल लागू करने से पहले उनकी विश्वसनीयता का आकलन किया जाता है। सुरक्षित उपयोग के लिए यह आकलन ज़रूरी है। प्रशिक्षण और लागू करने के बीच डेटा वितरण में बदलाव के कारण त्रुटियाँ हो सकती हैं। इसका एक और कारण है—प्रदर्शन में असमानता। मॉडल कुछ रोगी उपसमूहों के लिए व्यवस्थित रूप से खराब प्रदर्शन करता है।
अधिकांश पोस्ट-हॉक निदान विधियाँ पूरी आबादी के स्तर पर विश्वसनीयता का आकलन करती हैं। वे लागू किए जाने वाले डेटा की तुलना प्रशिक्षण डेटा से करती हैं। वे मॉडल के औसत प्रदर्शन को भी देखती हैं। लेकिन इस प्रक्रिया में असमानता का आकलन नहीं हो पाता। इसके कारण कुछ रोगियों को अनुपातहीन रूप से अधिक नुकसान हो सकता है।
| मानदंड | आबादी-स्तर का निदान | प्रोफ़ाइल के आधार पर स्थानीय खोज |
|---|---|---|
| क्या आकलन करता है | लागू किए जाने वाले डेटा और प्रशिक्षण डेटा के बीच समानता तथा औसत प्रदर्शन | कम विश्वास वाली प्रोफ़ाइलें और प्रोफ़ाइल के भीतर कोवेरिएट शिफ्ट |
| क्या दिखाता है | शिफ्ट या गिरावट का समग्र संकेत | वे विशिष्ट प्रोफ़ाइलें जिनमें प्रदर्शन गिरा है |
| सीमा | असमानता का हिसाब नहीं रखता | व्यापक शिफ्ट से यह पता लगाने में कम मदद मिलती है कि किसे नुकसान हुआ |
| व्यावहारिक भूमिका | पृष्ठभूमि निगरानी | अविश्वसनीय पूर्वानुमानों की लक्षित जाँच |
मानदंड: अनुपातहीन गिरावट झेल रहे रोगियों को खोजने के लिए आबादी-स्तर का निदान पर्याप्त नहीं है। प्रोफ़ाइल-स्तर का आकलन आवश्यक है।
दो-चरणीय खोज कैसे काम करती है: प्रोफ़ाइलें और स्थानीय शिफ्ट
यह पाइपलाइन निदान को दो चरणों में बाँटती है। पहले चरण में MED3pa कम विश्वास वाली, व्याख्या योग्य रोगी प्रोफ़ाइलों की पहचान करता है।
दूसरे चरण में Detectron को हर प्रोफ़ाइल के भीतर लागू किया जाता है। यह जाँचता है कि क्या प्रदर्शन में गिरावट का संबंध ऐसे हानिकारक कोवेरिएट शिफ्ट से है जिसका पता लगाया जा सकता है। यह जाँच पूरी आबादी के स्तर पर नहीं, बल्कि प्रोफ़ाइल के भीतर होती है।
प्रक्रिया इन चरणों में आगे बढ़ती है:
- कम विश्वास वाली, व्याख्या योग्य रोगी प्रोफ़ाइलें बनाएँ।
- हर प्रोफ़ाइल के लिए जाँचें कि क्या प्रदर्शन में गिरावट का संबंध कोवेरिएट शिफ्ट से है।
- उन प्रोफ़ाइलों को अलग करें जिनमें गिरावट का संबंध ऐसे हानिकारक शिफ्ट से है जिसका पता लगाया जा सकता है।
- नतीजे की तुलना आबादी-स्तर के निदान से करें।
मानदंड: ऐसी प्रक्रिया चुनें जो पहले प्रोफ़ाइलों की पहचान करे और फिर प्रोफ़ाइल के भीतर शिफ्ट की जाँच करे। आबादी-स्तर की एकमात्र जाँच यह नहीं बता सकती कि समस्या कहाँ है।
आयु, लिंग और नस्ल के शिफ्ट से क्या पता चला
इस अध्ययन में पूर्वानुमान से जुड़े तीन क्लिनिकल कार्य शामिल हैं। MIMIC-IV में उपसमूहों के तीन कृत्रिम शिफ्ट जोड़े गए। नतीजे शिफ्ट के प्रकार के अनुसार अलग-अलग थे:
- आयु शिफ्ट: पूरी आबादी के स्तर पर दिखाई नहीं दिया। MED3pa और Detectron की पाइपलाइन ने इसे उन विशिष्ट रोगी प्रोफ़ाइलों में पहचाना जिनका प्रदर्शन गिरा था।
- लिंग और नस्ल के शिफ्ट: व्यापक रूप से दिखाई दिए। इनसे यह तय करने में कम मदद मिली कि किन रोगियों पर सबसे ज़्यादा असर पड़ा।
मानदंड: स्थानीय खोज उन शिफ्ट के लिए खास तौर पर उपयोगी है जो पूरी आबादी के स्तर पर दिखाई नहीं देते। व्यापक संकेत से अपने-आप यह पता नहीं चलता कि सबसे ज़्यादा नुकसान किसे हुआ।
अविश्वसनीय प्रोफ़ाइलों के लिए स्थानीय खोज कब उपयुक्त है
यह पाइपलाइन कम विश्वास वाली प्रोफ़ाइलों और उनके भीतर कोवेरिएट शिफ्ट की जाँच पर निर्भर करती है। इसके उपयोग के मानदंड:
- कार्य में उन विशिष्ट प्रोफ़ाइलों की पहचान करना ज़रूरी है जिनका प्रदर्शन गिरा है।
- आबादी-स्तर का निदान यह नहीं बताता कि गिरावट कहाँ हुई।
- प्रोफ़ाइल के भीतर कोवेरिएट शिफ्ट का पता लगाया जा सकता है।
- नतीजे को स्थानीय आकलन के रूप में समझा जाता है, पूरी आबादी के आकलन के रूप में नहीं।
- निष्कर्ष को कई कार्यों और शिफ्ट के आधार पर जाँचा जाता है।
यह अध्ययन MIMIC-IV में तीन क्लिनिकल कार्यों और तीन शिफ्ट तक सीमित है। लेख को SMASH 2026 में स्वीकार किया गया है। जाँच के बिना नतीजों को दूसरे डेटा पर लागू नहीं किया जा सकता।
चयन का मानदंड: अविश्वसनीय पूर्वानुमानों वाली प्रोफ़ाइलों के लिए दो-चरणीय निदान का उपयोग करें। आबादी-स्तर के आकलन को समग्र पृष्ठभूमि के रूप में रखें। निर्णय प्रोफ़ाइल के भीतर की गई स्थानीय जाँच के आधार पर लें।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
AI एजेंट और एंटरप्राइज़ सॉफ़्टवेयर: 2026 में पहुँच और निगरानी की सीमाओं पर पुनर्विचार
यह लेख बताता है कि स्वायत्त AI एजेंट कॉर्पोरेट IT और सूचना सुरक्षा प्रक्रियाओं में कैसे शामिल हो रहे हैं और इसके लिए एक्सेस अधिकारों, पहचान सत्यापन और नियंत्रण नीतियों में बदलाव क्यों ज़रूरी है। पाठकों को 2026 में ऐसी प्रणालियों के जोखिम प्रबंधन को आकार देने वाले टूल और प्रथाओं की संतुलित तस्वीर मिलेगी।
15 नवम्बर 2026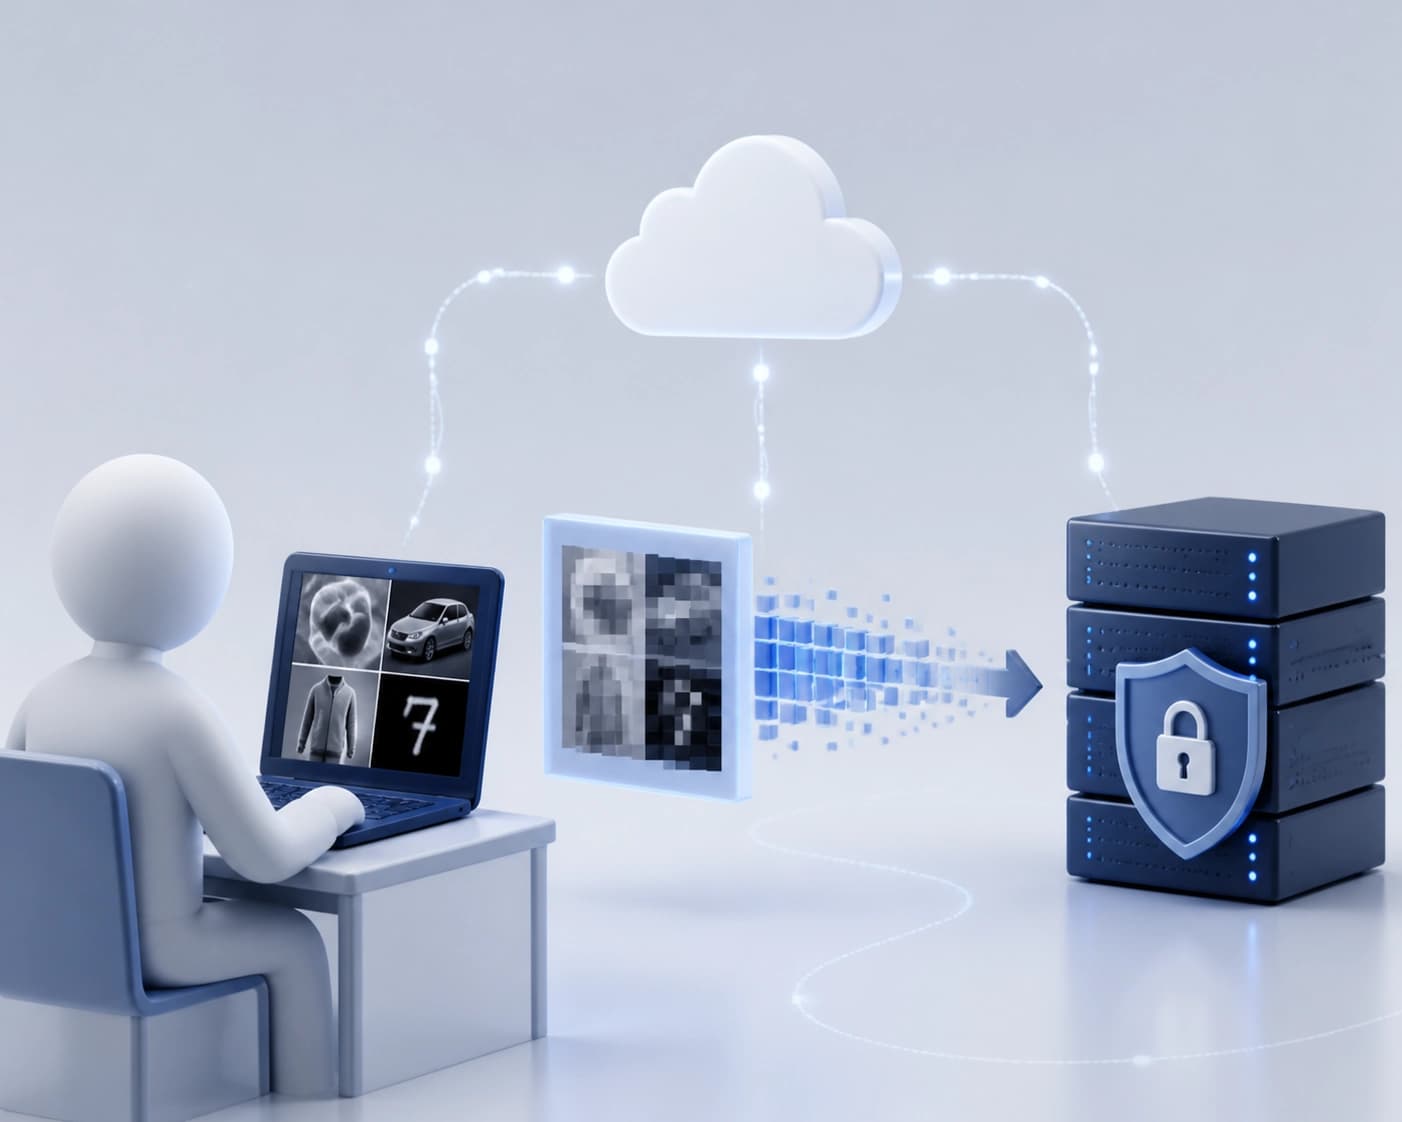
FedPix: फ़ेडरेटेड लर्निंग में डेटा लीक कम करने के लिए क्लाइंट से संपीड़ित छवियों का स्थानांतरण
यह लेख इस बात की पड़ताल करता है कि क्लाइंट को सर्वर पर कौन-सी जानकारी भेजने की अनुमति दी जानी चाहिए, और मॉडल वज़न या मध्यवर्ती निरूपणों के बजाय छोटे, दृश्य रूप से जाँचे जा सकने वाले चित्रों का प्रसारण प्रशिक्षित करने का प्रस्ताव देता है। BloodMNIST, CIFAR-10, FashionMNIST और MNIST पर यह तरीका पुनर्निर्माण में कम PSNR दिखाता है और 65,63–99,18% सटीकता के साथ क्लाइंट का समय 96,0% तक घटाता है।
15 नवम्बर 2026
MaRK: पूर्व-प्रशिक्षित SSMs में पुनरावर्ती पैरामीटरों का संदर्भगत मॉड्यूलेशन
एक ऐसा तरीका प्रस्तावित किया गया है, जो निम्न-रैंक पैरामीटर परिवर्तनों के ज़रिए फ्रोज़न स्टेट स्पेस मॉडल के रिकरंट ऑपरेटर को संदर्भ के अनुसार अनुकूलित करता है और जनरेशन के हर चरण में «इनपुट—आउटपुट» कर्नेल को प्रभावित करता है। एडेप्टर की तीन ज्यामितियों की तुलना से पता चलता है कि वैलिडेशन त्रुटि के मामले में चेबीशेव बहुपद बेहतर हैं, जबकि सीमित पैरामीटरकरण स्थिरता की विश्लेषणात्मक जाँच की अनुमति देता है।
14 नवम्बर 2026