
मॉलिक्यूलर वेक्टर एक इन्फ्रास्ट्रक्चर के रूप में
कंप्यूटेशनल केमिस्ट्री में, मॉलिक्यूल का एम्बेडिंग कब का एक तकनीकी ब्यौरा भर नहीं रहा। यह एक पुनःप्रयोग योग्य इन्फ्रास्ट्रक्चर है: एक ही वेक्टर प्रतिनिधित्व यौगिक के गुणों की भविष्यवाणी, वर्चुअल स्क्रीनिंग, और समान अणुओं की खोज—तीनों में काम आता है। एक बार गणना कीजिए—दस परिदृश्यों में लागू कीजिए, लाइब्रेरी की रैंकिंग से लेकर प्रयोगशाला के लिए उम्मीदवारों के चयन तक।
एक ही प्रतिनिधित्व की गतिरोध-स्थिति
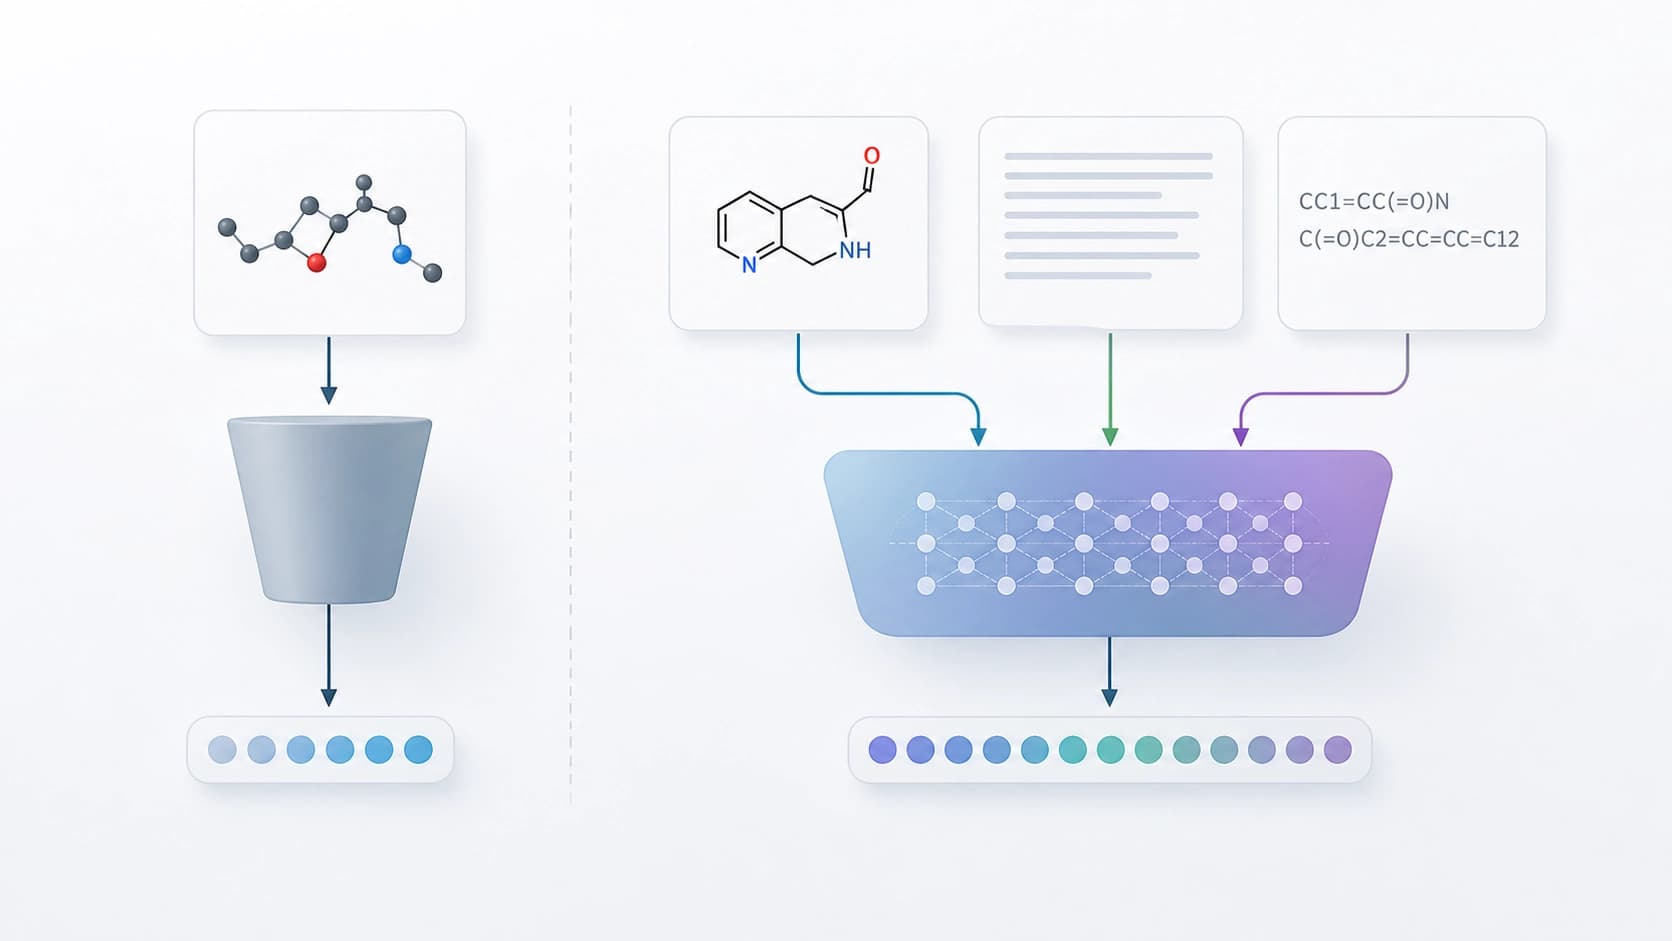
लगभग सभी मॉलिक्यूलर एनकोडर एक ही ढाँचे पर बने हैं: एक ही मोडैलिटी चुनी जाती है—परमाणुओं का ग्राफ़, SMILES स्ट्रिंग, भौतिक-रासायनिक डिस्क्रिप्टरों का समूह, या 3D-कन्फ़ॉर्मेशन—और मॉडल को सख़्ती से उसी पर प्रशिक्षित किया जाता है। आउटपुट पर मिलने वाला वेक्टर बिना शर्त का होता है। उसके पास कोई ऐसा इंटरफ़ेस नहीं होता जिसके ज़रिए अनुरोध को और स्पष्ट किया जा सके: "क्रियाविधि के आधार पर समानांतर चाहिए, कार्बन कंकाल के आधार पर नहीं" या "समान यौगिक, लेकिन घुलनशीलता को ध्यान में रखते हुए।"
इससे एक अप्रिय प्रभाव निकलता है। एक ही अणु को अलग-अलग मॉडल अलग-अलग तरह से देखते हैं, और उनके प्रतिनिधित्वों की सीधी तुलना नहीं की जा सकती—क्योंकि स्थान समन्वित नहीं हैं। और रसायनशास्त्री को इस स्थिति में यह याद रखना पड़ता है कि कौन-सा एनकोडर किस काम के लिए उपयुक्त है, बजाय इसके कि वह सीधे शब्दों में अपना काम बता सके।
लेखकों ने जो प्रश्न उठाया
Xinjian Zhao, Xiangru Jian, Yaoyao Xu, Xiaozhuang Song, Wei Pang, Lei Bai और Tianshu Yu का काम (arXiv:2608.23646, 24 अगस्त 2026; ICML 2026 के ढाँचे में FM4LS वर्कशॉप में प्रस्तुत, non-archival) ठीक इसी असंतोष से शुरू होता है। शोधकर्ता यह प्रश्न पूछते हैं: आख़िर मॉलिक्यूल के हर प्रतिनिधित्व के लिए अलग एनकोडर बनाने की ज़रूरत ही क्या है, जब मल्टीमॉडल LLM पहले से ही छवियों, टेक्स्ट और सांकेतिक अभिलेखों के साथ स्वाभाविक रूप से काम कर सकते हैं?
तर्क सीधा है। अगर मॉडल संरचनात्मक सूत्र की तस्वीर को "देख" ही लेता है, विवरण पढ़ लेता है और SMILES को समझ लेता है, तो उसे सलाहकार-सहायक नहीं, बल्कि वेक्टर जनरेटर बनाया जा सकता है। और वे वेक्टर भी शर्त-सापेक्ष—जो न केवल अणु पर निर्भर करते हैं, बल्कि इस पर भी कि उसके बारे में प्राकृतिक भाषा में क्या पूछा जा रहा है।
फ़्रेमवर्क कैसे बना है
MolEmb एक हल्का-फुल्का ओवरले है, कोई नया बड़ा मॉडल नहीं। यह पहले से मौजूद MLLM को इस तरह अनुकूलित करता है कि मॉलिक्यूलर प्रोफ़ाइल और उनके टेक्स्ट विवरण एक ही साझा एम्बेडिंग स्थान में आ जाएँ। मुख्य तत्व है द्विदिशात्मक कॉन्ट्रास्टिव उद्देश्य: यह "अणु—टेक्स्ट" जोड़ों को एक-दूसरे के पास खींचता है और साथ ही बेमेल जोड़ों को दूर धकेलता है।
यह जितना लगता है उससे ज़्यादा क्यों मायने रखता है
यहाँ कॉन्ट्रास्टिव लर्निंग एक साथ दो समस्याएँ हल करती है। पहला, यह एक साझा निर्देशांक प्रणाली बनाती है: अणु का वेक्टर और उसके विवरण का वेक्टर तुलनीय हो जाते हैं। दूसरा, यह दोनों दिशाओं में क्रॉस-मोडल खोज देती है—अणु से टेक्स्ट खोजिए, टेक्स्ट से अणु खोजिए, और वह भी एक ही स्थान के भीतर, मोडैलिटियों के बीच किसी मध्यस्थ अनुवादक के बिना।
दावा किया गया परिणाम "सभी बेंचमार्क तोड़ दिए" से ज़्यादा विनम्र है, और इसी वजह से ज़्यादा विश्वसनीय भी: प्राप्त प्रतिनिधित्व मॉलिक्यूलर गुणों की भविष्यवाणी में प्रतिस्पर्धी हैं और साथ ही मोडैलिटियों के बीच खोज का समर्थन करते हैं। यानी भाषाई इंटरफ़ेस पारंपरिक कार्यों के ह्रास की कीमत पर नहीं खरीदा गया।
भाषा एक नियंत्रण-लीवर के रूप में
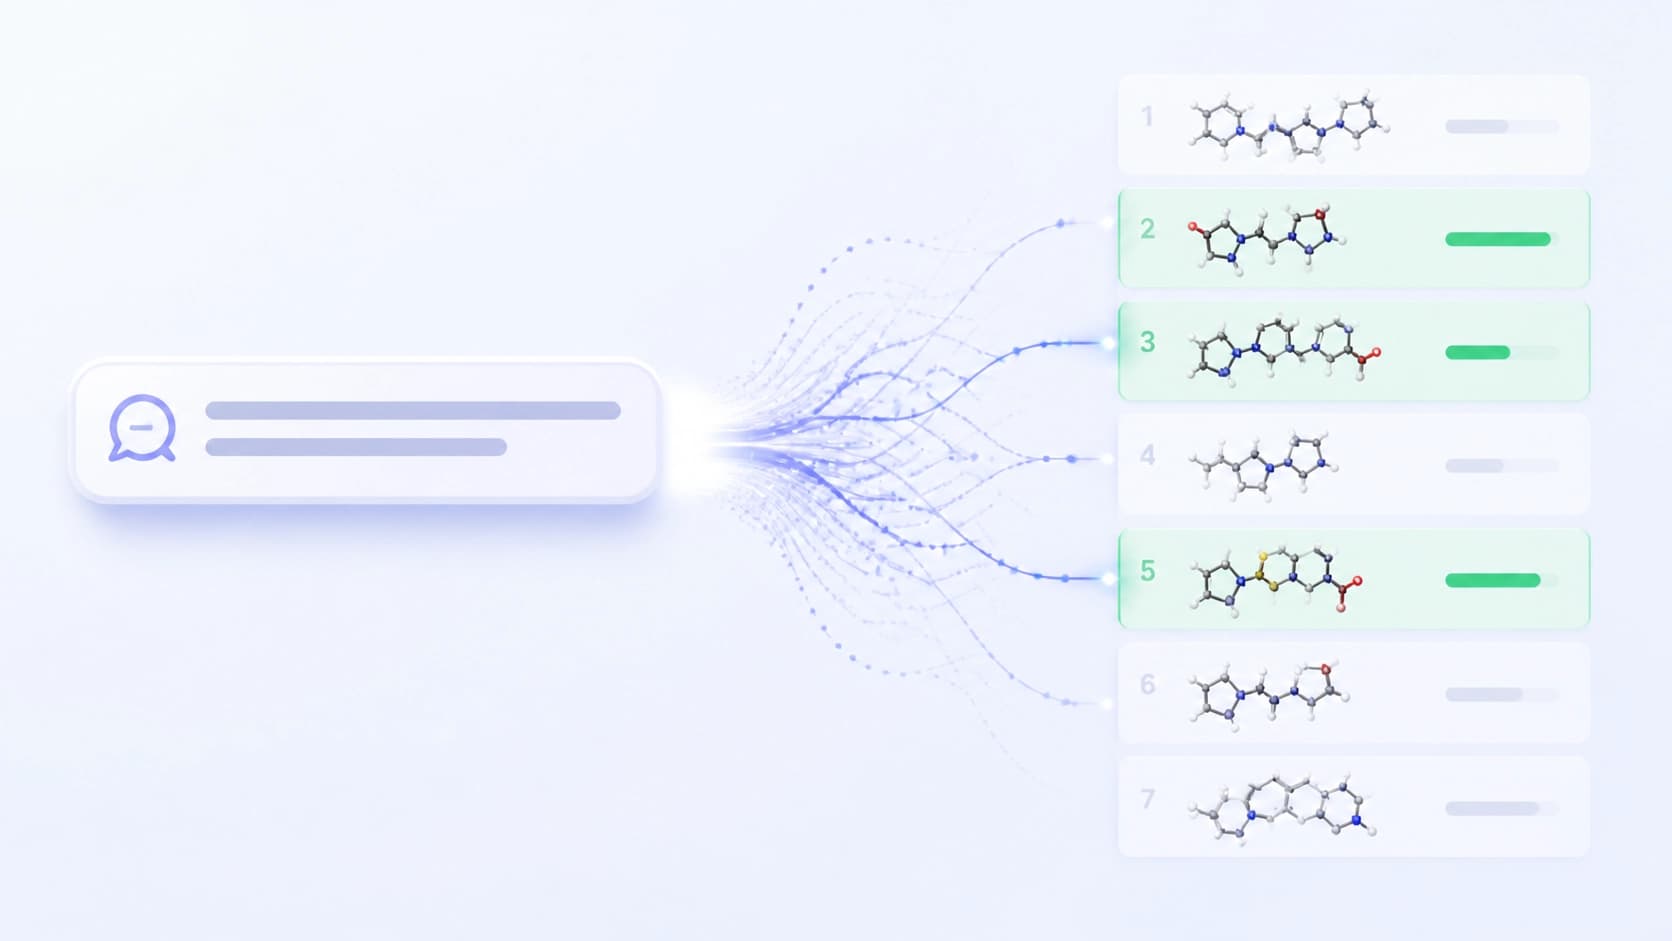
पारंपरिक एनकोडरों से मुख्य अंतर शर्त-सापेक्षता में है। विशेषीकृत मॉडल किसी अणु के लिए एक निश्चित वेक्टर देता है। यह फ़्रेमवर्क शब्दों में शर्त बताने और उस शर्त की ओर झुका हुआ प्रतिनिधित्व पाने की सुविधा देता है। एक ही अणु को अलग-अलग तरह से प्रस्तुत किया जा सकता है, इस पर निर्भर करते हुए कि आपकी दिलचस्पी विषाक्तता में है, घुलनशीलता में, या किसी विशिष्ट यौगिक-वर्ग के निकटता में।
संदर्भ पर निर्भर मॉलिक्यूलर खोज
काम का एक अलग हिस्सा है नैदानिक बेंचमार्क MolCAR। यह संदर्भ-सापेक्ष खोज की जाँच के लिए बनाया गया है, यानी ऐसी स्थितियों की, जहाँ सही उत्तर अनुरोध के शब्दों के अनुसार बदल जाता है। यह समान संरचनाओं की पारंपरिक खोज से मूल रूप से कठिन है: वहाँ मानक एक ही होता है, यहाँ वह कार्य की प्रस्तुति पर निर्भर करता है।
सबसे दिलचस्प निष्कर्ष
शायद लेखकों का सबसे मूल्यवान अवलोकन लगभग रोज़मर्रा की बात जैसा लगता है: संदर्भ-सापेक्ष मॉलिक्यूलर एम्बेडिंग सबसे पहले सुपरविज़न डेटा का गुण है, कोई आर्किटेक्चरल तरकीब नहीं। दूसरे शब्दों में, मॉडल संदर्भों में फ़र्क़ करना इसलिए नहीं सीखता कि उसमें कोई चालाक मॉड्यूल लगाया गया, बल्कि इसलिए कि उसे ऐसे जोड़ों पर सिखाया गया जहाँ संदर्भ वाक़ई अलग-अलग हैं।
निष्कर्ष एक साथ ज़मीन पर लाता है और उपयोगी भी है। यह ध्यान को आर्किटेक्चर की दौड़ से हटाकर प्रशिक्षण डेटा की गुणवत्ता और संरचना पर ले जाता है: अगर डेटासेट में अणुओं के विवरण एक जैसे हैं, तो कोई भी मल्टीमॉडैलिटी मॉडल को अनुरोध की बारीकियों के प्रति संवेदनशील नहीं बना सकती।
व्यवहार में यह क्या बदलता है
अगर ऐसा दृष्टिकोण बड़े पैमाने पर लागू हो सके, तो लाभ ऐसा दिखेगा:
- एनकोडरों की चिड़ियाघर के बजाय एकीकृत इन्फ्रास्ट्रक्चर। एक ही मॉडल गुण, खोज और क्रॉस-मोडल अनुरोध—सब संभाल लेता है।
- मॉडल चुनने के बजाय शब्दों में अनुरोध। उपयोगकर्ता को यह जानने की ज़रूरत नहीं कि उसके मामले के लिए कौन-सा एनकोडर बेहतर है।
- संगत स्थान। अणुओं और टेक्स्टों के वेक्टर साथ रहते हैं, यानी उनकी तुलना और संयोजन किया जा सकता है।
- तैयार MLLM का पुनःप्रयोग। फ़्रेमवर्क मौजूदा मॉडल को अनुकूलित करता है, शून्य से प्रशिक्षित नहीं करता।
सीमाएँ और खुले प्रश्न
काम को non-archival चिह्नित किया गया है, यानी यह तैयार उत्पाद से ज़्यादा एक दिशा है। कई प्रश्न बने हुए हैं: यह दृष्टिकोण परखे गए डेटासेटों के बाहर कितना टिकाऊ है, दुर्लभ यौगिक-वर्गों पर यह कैसा व्यवहार करता है, कहीं भाषाई हिस्सा रासायनिक हिस्से पर हावी तो नहीं होने लगता, और कहीं यह वेक्टर को भौतिक रूप से अर्थपूर्ण प्रतिनिधित्व के बजाय टेक्स्ट का पुनर्कथन नहीं बना देता।
फिर भी मुख्य बात स्पष्ट रूप से कही गई है। मल्टीमॉडल LLM केवल रासायनिक सहायक और केवल उत्तर जनरेटर नहीं हैं। वे मॉलिक्यूलर एम्बेडिंग के एक सामान्य तंत्र की भूमिका का दावा करते हैं: विस्तारणीय, शब्दों से नियंत्रित, और नए कार्यों के लिए आगे प्रशिक्षण के लिए खुला।


