
संक्षेप में: दर्द असल में कहाँ है
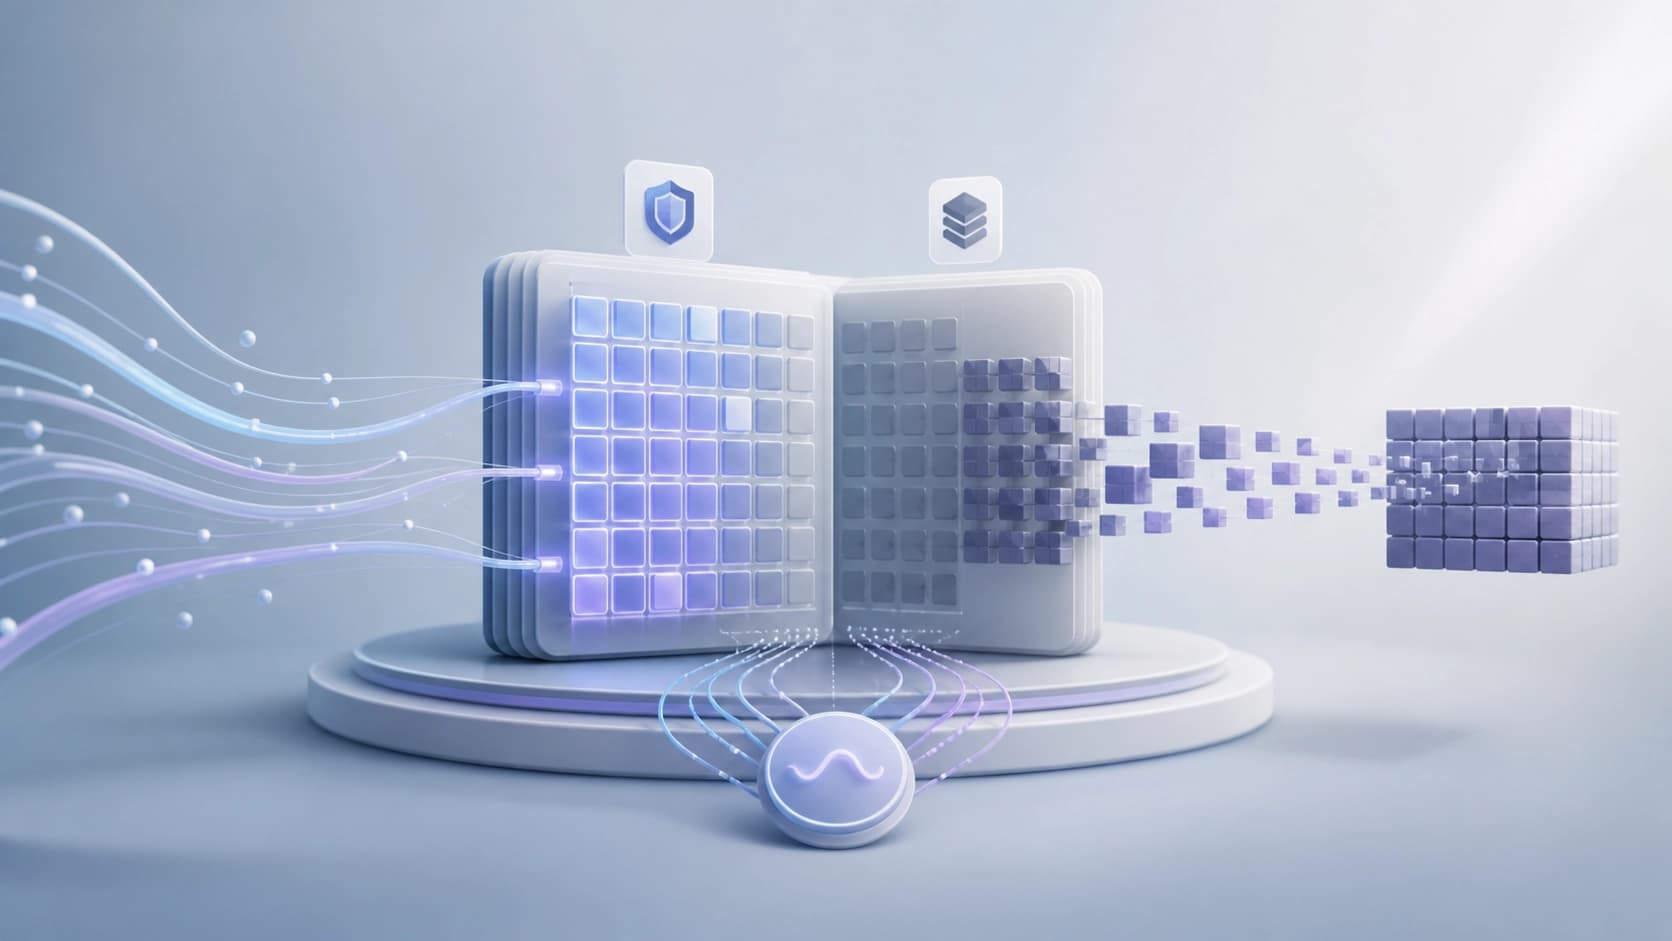
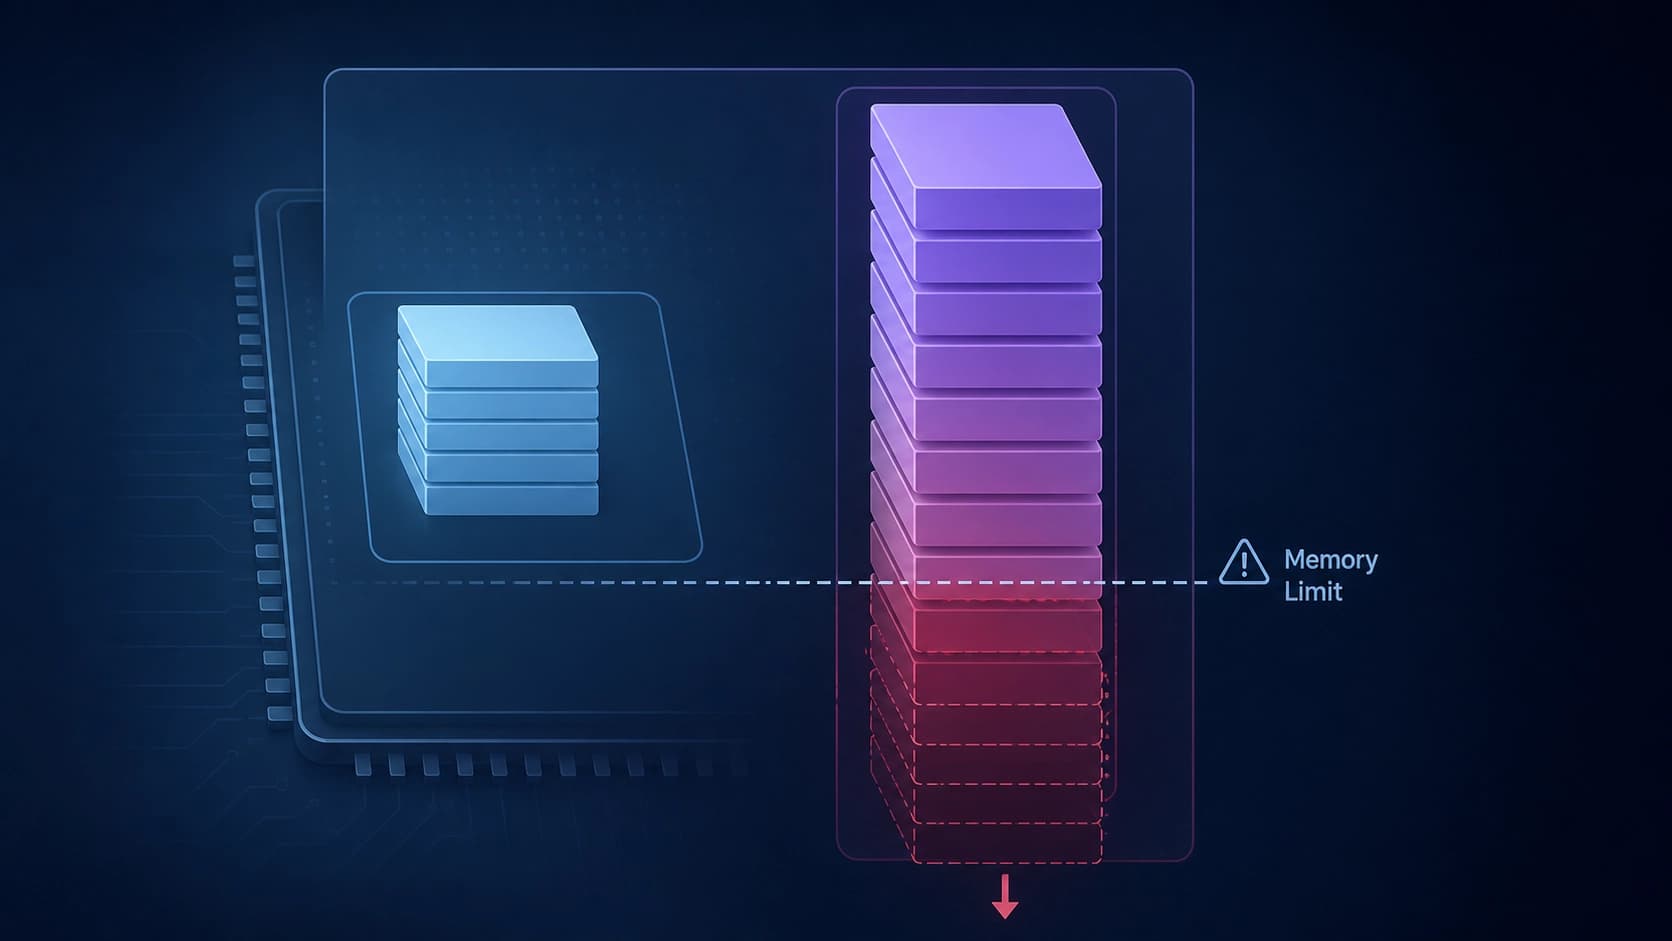
जब एक लंबे-संदर्भ वाला मॉडल किसी अनुरोध को संभालता है, तो मुख्य खर्च वेट्स पर नहीं, बल्कि KV-कैश पर जाता है — पहले से पढ़े गए सभी टोकन के लिए सहेजी गई कुंजियाँ और मान। दस्तावेज़ या संवाद जितना लंबा होगा, उतने ही अधिक टेंसर मेमोरी में रखने पड़ेंगे और जनरेशन के हर चरण में उतना ही अधिक डेटा दोबारा पढ़ना पड़ेगा। यहीं से वह आम दुविधा पैदा होती है: या तो संदर्भ को छोटा कर दिया जाए, या फिर मेमोरी और इन्फ़रेंस की गति की कीमत चुकाई जाए।
मौजूदा समाधान आम तौर पर दो चरम स्थितियों में से एक चुनते हैं। या तो पूरी स्थिति को ही संपीड़ित कर देते हैं, जिससे वह ताज़ा जानकारी खोने का जोखिम रहता है जो अगले उत्तर के लिए ठीक उसी समय चाहिए होती है, या फिर सब कुछ मूल परिशुद्धता में ही रखते हैं और एक्सेलेरेटर की क्षमता पर अटक जाते हैं।
नीचे जिस काम की चर्चा है, वह ठीक इसी दुविधा में हस्तक्षेप करने की कोशिश करता है।
लेखक क्या पेश करते हैं
पेपर «Minima-KV: Retention-Preserving KV Cache Compression with Mixed-Format Paged Attention» 24 अगस्त 2026 को arXiv पर 2608.23834 संख्या के साथ जमा किया गया, श्रेणी cs.AI, 13 पृष्ठ और 3 चित्र, DOI 10.48550/arXiv.2608.23834। लेखक हैं Sergii Kozyrev और Davyd Maiboroda, Minima AI, Inc. से। एक दिलचस्प ब्यौरा: प्रीप्रिंट पृष्ठ पर PDF लिंक ब्लॉक में कैप्शन पहले लेखक को «और दो अन्य» के साथ दर्शाता है, हालाँकि ग्रंथसूची विवरण में केवल दो ही सूचीबद्ध हैं। छोटी बात है, लेकिन यह याद दिलाती है कि प्रीप्रिंट के मेटाडेटा की जाँच करते रहना चाहिए।
Minima-KV का प्रस्ताव यह है — KV-कैश के पृष्ठों का एक पदानुक्रम, जहाँ अलग-अलग पृष्ठ अलग-अलग संख्यात्मक प्रारूपों में संग्रहित होते हैं। शीर्षक में मुख्य शब्द है retention-preserving, यानी «प्रतिधारण-संरक्षी»: ताज़ा अनुरोधों की स्थिति कहीं बाहर नहीं धकेली जाती।
FP8 में एंकर, TQ3 में संग्रह
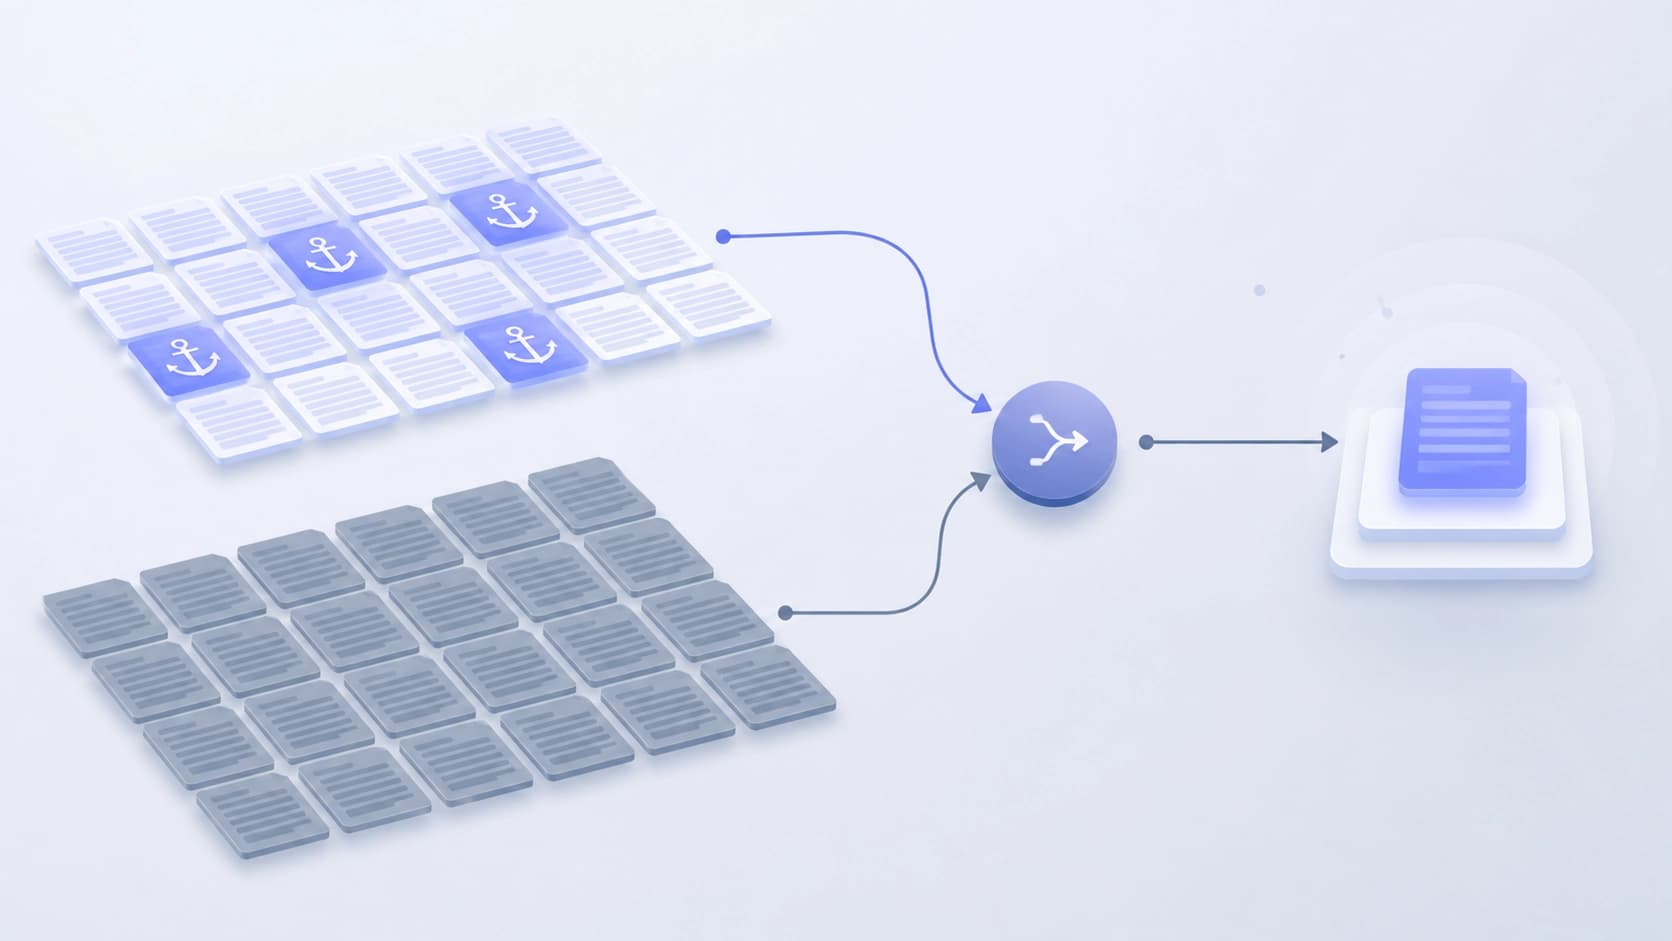
विभाजन का तर्क सरल है। जो पृष्ठ हाल ही में उपयोग हुए और संरक्षित (anchor) के रूप में चिह्नित हैं, वे FP8 में ही रहते हैं। पुराने पृष्ठ, जो एंकर श्रेणी में नहीं आए, packed TQ3 में बदल दिए जाते हैं — एक अधिक सघन, पैक किया हुआ प्रारूप। साथ ही, लाइव अनुरोध के हर पृष्ठ को अब भी सीधे एड्रेस किया जा सकता है: एड्रेस स्पेस से कुछ भी बाहर नहीं फेंका जाता और न ही किसी अनुमानित प्रतिलिपि से बदला जाता है।
आंशिक परिणाम कैसे जोड़े जाते हैं
सबसे दिलचस्प हिस्सा है अंकगणित। हर प्रारूप के लिए अलग कर्नेल अपनी आंशिक अटेंशन स्थितियों की गणना करते हैं, और फिर उन्हें वैश्विक रूप से सामान्यीकृत online-softmax merge के ज़रिए जोड़ा जाता है। सरल शब्दों में: गणना से पहले सभी पृष्ठों को एक ही प्रकार में बदलने के बजाय, सिस्टम हर समूह का योगदान उसी के प्रारूप में गिनता है और सामान्यीकृत परिणामों को सही ढंग से जोड़ता है।
इसी वजह से डिकोडिंग सीधे विषम कैश पर चलती है, बिना तथाकथित सघन छाया (dense shadow) के — यानी कैश की वह पूरी प्रतिलिपि जो एक ही प्रारूप में होती और जो मेमोरी की पूरी बचत को बेकार कर देती।
मापन क्या दिखाते हैं
मेमोरी और संपीड़न
मापन उन प्रोफ़ाइलों पर किए गए जो एक ही NVIDIA RTX PRO 6000 Blackwell एक्सेलेरेटर पर मॉडल Qwen3.6-27B की विशिष्ट कॉन्फ़िगरेशन से जुड़ी थीं, जिसमें 96 GB मेमोरी है। नतीजा रहा 18.3 KiB अटेंशन KV प्रति लाइव टोकन। यह BF16 के मुकाबले 3.50x संपीड़न है और FP8 के मुकाबले 1.75x।
दूसरा आँकड़ा पहली नज़र में जितना लगता है उससे अधिक महत्वपूर्ण है। FP8 से तुलना दिखाती है कि लाभ केवल आधी परिशुद्धता से अधिक किफ़ायती प्रारूपों पर जाने से नहीं, बल्कि ठीक हाइब्रिड भंडारण योजना से मिलता है।
लंबे संदर्भ पर गुणवत्ता
मटेरियलाइज़िंग प्रोफ़ाइल — वह जिसमें हाइब्रिड पृष्ठ वास्तव में टेंसर में खोले जाते हैं — 16K पर RULER needle-in-a-haystack कार्यों में अपने सघन नियंत्रण से मेल खा गई। यानी घास के ढेर में सुई खोजने में कोई अंतर नहीं पाया गया।
आगे समझौते शुरू होते हैं। LongBench v2 के 503 प्रश्नों के सेट पर डेल्टा ऋणात्मक निकले: 16K पर -0.80 प्रतिशत अंक, 32K पर -0.60 और 64K पर -0.40। वक्र के आकार पर ध्यान दें — नुकसान संदर्भ की लंबाई के साथ रैखिक रूप से नहीं बढ़ते, बल्कि हल्के से उतार-चढ़ाव करते हैं। लेखक इसका कोई स्पष्टीकरण नहीं देते, लेकिन व्याख्या करते समय यह तथ्य ध्यान में रखना चाहिए: प्रतिशत के अंशों का अंतर आसानी से मापन के शोर से भ्रमित हो सकता है।
कैनरी जाँच
एक अलग परीक्षण — single-pair canary, जिसमें 59,008 टोकन वाले अनुरोधों के साथ दो सीधी डिकोडिंग की तुलना की गई। परिणाम: सक्रिय KV 3.625 गुना सिकुड़ गया, थ्रूपुट नियंत्रण के मुकाबले 0.9821x रहा, पूर्ण अटेंशन की सभी 16 परतें सघन मोड पर fallback के बिना रूट हुईं, और कोई भी सघन छाया संग्रहित नहीं की गई।
थ्रूपुट एक से ज़रा कम — यह असल में एक ईमानदार सौदा है: घटती मेमोरी के बदले लगभग दो प्रतिशत गति।
निष्कर्ष और आपत्तियाँ
लेखकों का घोषित निष्कर्ष सतर्क है: परिणाम लाइव अनुरोधों के पृष्ठों को बाहर धकेले बिना मिश्रित प्रारूपों में लंबे-संदर्भ वाली स्थिति को संपीड़ित करने का एक व्यावहारिक रास्ता दिखाते हैं। यही वह चीज़ है जिसकी कमी पिछले दृष्टिकोणों में थी — ऐसा संपीड़न जो पुराने डेटा के लिए ताज़ा डेटा का बलिदान न करे।
पढ़ते समय किन बातों का ध्यान रखें:
- परीक्षण प्रोफ़ाइल कॉन्फ़िगरेशन से बँधी हैं। बात एक विशिष्ट मॉडल और एक विशिष्ट एक्सेलेरेटर की है; आँकड़ों की अन्य आर्किटेक्चर पर पोर्टेबिलिटी नहीं दिखाई गई है।
- कैनरी जाँच संकीर्ण है। अनुरोधों की एक जोड़ी, सीधी डिकोडिंग का एक परिदृश्य — यह कार्यक्षमता का उदाहरण है, लोड का सांख्यिकीय विश्लेषण नहीं।
- LongBench v2 पर गिरावट शून्य नहीं है। प्रतिशत अंक के अंश — कम है, लेकिन जिन कार्यों में हर इकाई परिशुद्धता मायने रखती है, वहाँ यह अपना मापन करने का कारण बन जाता है।
- प्रोडक्शन परिस्थितियों में विलंबता का कोई डेटा नहीं है। कैनरी परीक्षण में थ्रूपुट, विवरण के अनुसार, पूरी तरह 16 परतों से होकर बिना reserve-पथ के जाता है — दिलचस्प है कि सबसे खराब स्थिति में रूटिंग कैसा व्यवहार करेगी, जब एंकर पृष्ठ सामान्य से अधिक हो जाएँ।
इस काम का व्यावहारिक महत्व संपीड़न के रिकॉर्ड आँकड़ों में नहीं, बल्कि किसी और चीज़ में है: यह दिखाता है कि विषम कैश को सीधे सेवित किया जा सकता है, हर चरण के लिए उसकी पूरी प्रतिलिपि जोड़े बिना। अगर यह दृष्टिकोण अन्य मॉडलों पर भी लागू होता है, तो लंबे-संदर्भ वाले परिदृश्यों के पास हार्डवेयर स्केलिंग के अतिरिक्त एक और लीवर आ जाता है।


