
समस्या: एजेंट ट्रेस एक लॉग है, व्यवहार का मॉडल नहीं
एक बहु-चरणीय LLM एजेंट अपने पीछे एक लंबा निशान छोड़ता है: टूल कॉल, मध्यवर्ती तर्क, सुधार, पुनः प्रयास। इसे आँखों से पढ़ना लगभग निरर्थक है — सैकड़ों पंक्तियों का टेक्स्ट, जहाँ उपयोगी संकेत पूरे आयतन में बिखरा हुआ है। उस डेवलपर के लिए जो एजेंट को प्रोडक्शन में तैनात कर रहा है, ऐसा लॉग एक ब्लैक बॉक्स बन जाता है: न यह समझ आता है कि रन ठीक कहाँ गलत दिशा में गया, न यह कि सिस्टम के लिए सामान्य अवस्थाएँ कौन-सी हैं।
यही विषय arXiv:2608.23670 (cs.AI) «Automata from Agent Traces: Failure and Next-Step Prediction» का है — इसके लेखक Seonglae Cho, Franklin Cardenoso Fernandez, Umar Mohammed, Zekun Wu, Kleyton Da Costa, Ilham Wicaksono और Adriano Koshiyama प्रस्ताव देते हैं कि ट्रेस को टेक्स्ट के रूप में नहीं, बल्कि अवस्थाओं के बीच संक्रमणों के डेटा के रूप में देखा जाए। तर्क सरल है: यदि एजेंट का व्यवहार हर रन में दोहराता है, तो बाहरी अराजकता के पीछे एक संरचना है, और उसे पुनर्निर्मित किया जा सकता है।
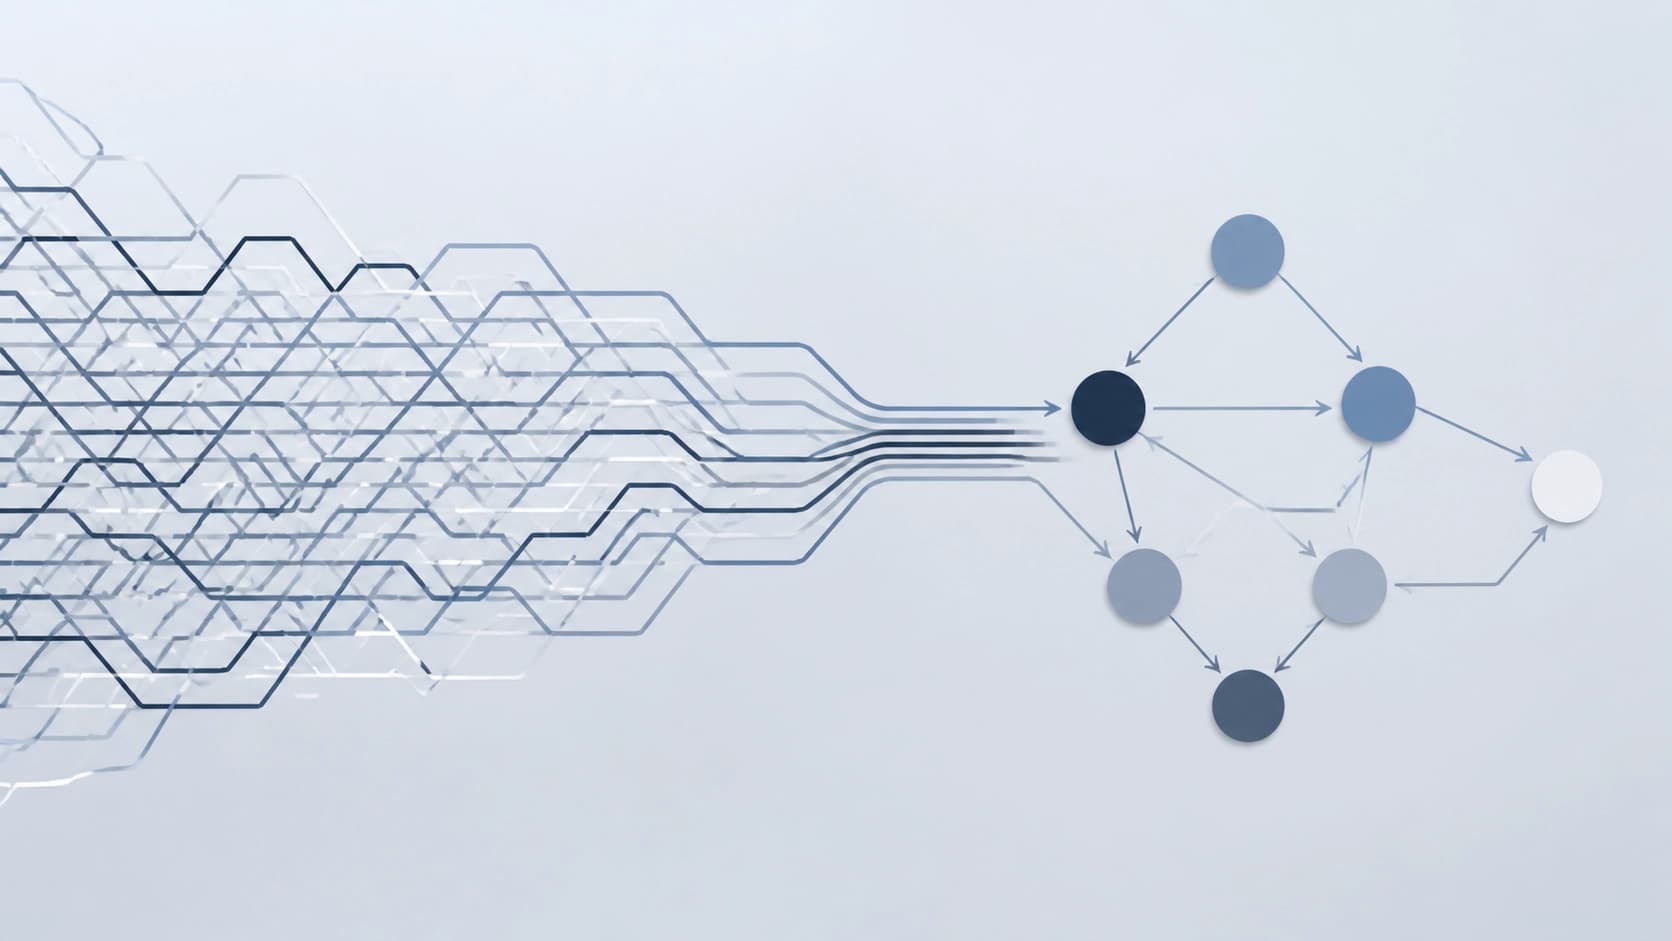
अलग से यह उल्लेख करना उचित है कि पुराने दृष्टिकोणों में क्या कमी थी। विश्लेषण आमतौर पर एक बार में एक ट्रेस पर किया जाता था या केवल सफल रनों पर निर्भर रहता था। दोनों ही मामलों में समग्र तस्वीर खो जाती है — वह टोपोलॉजी जो अगली क्रिया की भविष्यवाणी और विफलता की भविष्यवाणी को आपस में जोड़ती है। और यही टोपोलॉजी सुरक्षा ऑडिट के लिए भी चाहिए और रीयल-टाइम मॉनिटरिंग के लिए भी।
पूरे कॉर्पस के लिए एक ऑटोमेटन
विधि का विचार: ट्रेस के पूरे सेट को लेकर उसे एक ही संक्षिप्त परिमित अवस्था मशीन (FSM) में समेट देना। हर रन के लिए एक निर्णय वृक्ष नहीं, वेक्टर स्पेस में कहीं एम्बेडिंग नहीं, बल्कि अवस्थाओं और संक्रमणों वाला एक साधारण ग्राफ — वही संरचनात्मक आधार जो एजेंट के व्यवहार को यदि पूर्वानुमेय नहीं, तो कम से कम वर्णनीय तो बनाता है।
बारह सार्वजनिक डेटासेट पर परिणाम आशाजनक दिखते हैं:
- ऑटोमेटन छोटे बनते हैं — 7 से 43 अवस्थाओं तक, यानी उन्हें वास्तव में बनाया और कॉल पर चर्चा किया जा सकता है;
- होल्ड-आउट डेटा पर वे 0.997 से कम नहीं fitness के साथ ट्रेस को पुनरुत्पादित करते हैं — लगभग आदर्श मेल;
- एक ही डेटासेट के अलग-अलग स्प्लिट पर बनाई गई टोपोलॉजी लगभग समान निकलती है;
- स्वयं संयोजन मिलीसेकंड में हो जाता है, घंटों के प्रशिक्षण में नहीं।
अंतिम बिंदु जितना लगता है उससे अधिक महत्वपूर्ण है। जो विधि तुरंत बन जाती है, उसे प्रॉम्प्ट या कॉन्फ़िगरेशन के हर संशोधन के बाद फिर से बनाया जा सकता है — और तुरंत देखा जा सकता है कि सिस्टम का व्यवहार बदला या नहीं।
यह केवल सुंदर विज़ुअलाइज़ेशन क्यों नहीं है
यहाँ संक्षिप्तता स्वयं उद्देश्य नहीं है। जब आपके पास हज़ारों पंक्तियों के टेक्स्ट के बजाय 20 अवस्थाएँ हों, तो एजेंट के कार्य-मोड पर विचार करने की संभावना बनती है: यह रहा चक्र «प्रयास किया — त्रुटि मिली — दोहराया», यह रही शाखा «कार्य स्पष्टीकरण प्रश्नों में चला गया», यह रही दुर्लभ अवस्था जिससे लगभग कोई निकास नहीं है। आगे इन मोड के साथ इंजीनियरिंग की दृष्टि से काम किया जा सकता है — उदाहरण के लिए, ऐसे लक्षण बनाना जो प्रत्येक अवस्था के आधार पर गणना किए जाते हैं।
अगले चरण की भविष्यवाणी: अवस्था स्मृति से अधिक महत्वपूर्ण
एजेंट की अगली क्रिया की भविष्यवाणी के लिए लेखक FSM अवस्था के संदर्भ का उपयोग करते हैं। और यह दृष्टिकोण हर उस डेटासेट पर Agent Workflow Memory को पीछे छोड़ देता है जहाँ लेबलिंग वास्तविक निष्पादन क्रम से मेल खाती है। दूसरे शब्दों में, यह ज्ञान कि «एजेंट इस समय किस मोड में है» पिछले कार्य-एपिसोड की संचित स्मृति से अधिक उपयोगी सिद्ध होता है।
यहाँ एक दिलचस्प बारीकी है। अवस्था संदर्भ केवल नोड का नंबर नहीं है, बल्कि इस बात का संक्षिप्त विवरण है कि अब तक क्या हुआ और आगे किस संभावना से क्या होगा। यह संभावित निरंतरताओं का एक प्रकार का नक्शा बन जाता है, जो टेक्स्ट की सिमैंटिक्स पर नहीं, बल्कि संक्रमणों के आँकड़ों पर आधारित है। व्यवहार में इसका अर्थ है कि अगले चरण के भविष्यवक्ता को सस्ते में प्रशिक्षित किया जा सकता है: उसे मॉडल की छिपी अवस्थाओं तक पहुँच की आवश्यकता नहीं, संरचना पर्याप्त है।
विफलता की भविष्यवाणी और आंशिक ट्रेस पर मॉनिटरिंग
कार्य का दूसरा आधा भाग निदान के बारे में है। ऑटोमेटन की अलग-अलग अवस्थाओं के आधार पर गणना किए गए लक्षण होल्ड-आउट डेटा पर 0.94 तक AUROC देते हैं। यानी एक मॉडल, जो LLM के आंतरिक भागों के बारे में कुछ नहीं जानता, व्यवहारिक विशेषताओं के आधार पर उन रनों में अंतर करता है जो विफलता में समाप्त होंगे और उनमें जो अंत तक पहुँचेंगे।
यहाँ सबसे व्यावहारिक चीज़ है ऑनलाइन मॉनिटर। यह अपूर्ण ट्रेस को देखता है और अंत की प्रतीक्षा किए बिना विफल रनों को सफल रनों से ऊपर रैंक करता है। यह इसके लिए पर्याप्त है कि एजेंट के पूरी तरह गलत दिशा में जाने से बहुत पहले प्रारंभिक रोक सक्रिय की जा सके: टोकन, समय बचाया जाए और, जो अधिक महत्वपूर्ण है, उसे नुकसान पहुँचाने से रोका जाए। उन एजेंटों के लिए जो डेटाबेस में लिखते हैं, भुगतान API कॉल करते हैं या इन्फ्रास्ट्रक्चर प्रबंधित करते हैं, बीच में निष्पादन रोक पाने की यह क्षमता विलासिता नहीं, आवश्यकता है।
मुख्य निष्कर्ष: व्यवहार को हार्नेस तय करता है, मॉडल नहीं
शायद लेख का सबसे उत्तेजक प्रस्ताव यह है: एजेंट की व्यवहारिक टोपोलॉजी काफी हद तक भाषा मॉडल द्वारा नहीं, बल्कि deployment harness — उस हार्नेस द्वारा निर्धारित होती है जिसमें मॉडल चलाया जाता है। प्रॉम्प्ट टेम्पलेट, टूल का सेट, त्रुटि प्रबंधन के नियम, चरण सीमाएँ — यही संक्रमण ग्राफ को आकार देते हैं।
इससे कई निष्कर्ष निकलते हैं। पहला, उसी हार्नेस के साथ मॉडल को दूसरे से बदलने पर व्यवहार की संरचना मूल रूप से नहीं बदल सकती — और इसलिए एक मॉडल पर बनाए गए ऑटोमेटन को दूसरे पर भी जाँचना चाहिए। दूसरा, एजेंट को सुधारना अक्सर वेट के अपग्रेड के बजाय harness में बदलाव के माध्यम से अधिक प्रभावी होता है। तीसरा, एक model-agnostic संरचनात्मक प्रिमिटिव सामने आता है: वही दृष्टिकोण सुरक्षा ऑडिट और रनटाइम-मॉनिटरिंग दोनों के लिए उपयुक्त है, चाहे आप किसी का भी API कॉल कर रहे हों।
क्या ध्यान में रखना चाहिए
यह दृष्टिकोण सावधानी को समाप्त नहीं करता। बारह डेटासेट अभी भी एक सीमित नमूना है, और fitness 0.997 यह बताता है कि ऑटोमेटन पहले से एकत्र किए गए ट्रेस का कितना अच्छा वर्णन करता है, न कि यह कि वह किसी अपरिचित वातावरण में सिस्टम के व्यवहार की भविष्यवाणी करेगा। विफलता की भविष्यवाणी के लिए उच्च AUROC भी विशिष्ट कार्यों पर प्राप्त किया गया है: नए डोमेन में लक्षणों की पुनर्गणना करनी पड़ेगी।
और फिर भी दिशा उचित दिखती है। कॉन्टेक्स्ट विंडो को अनंत रूप से बढ़ाते रहने और यह आशा करने के बजाय कि मॉडल «स्वयं संभाल लेगा», एक बार अपने हार्नेस के व्यवहार का संक्षिप्त मॉडल बनाया जा सकता है — और फिर उसे एक योजना की तरह उपयोग किया जा सकता है: देखें कि एजेंट कहाँ अटकता है, कौन-सी अवस्थाएँ विफलता की ओर ले जाती हैं, और कॉन्फ़िगरेशन ठीक करने पर क्या बदलेगा। ऑटोमेटन LLM से अधिक बुद्धिमान नहीं है, लेकिन वह अधिक ईमानदार है: उसे पूरी तरह दिमाग में समेटा जा सकता है, और डिबगिंग में यही आधी सफलता है।


