एजेंटिक RAG एक दुविधा पर क्यों अटकता है
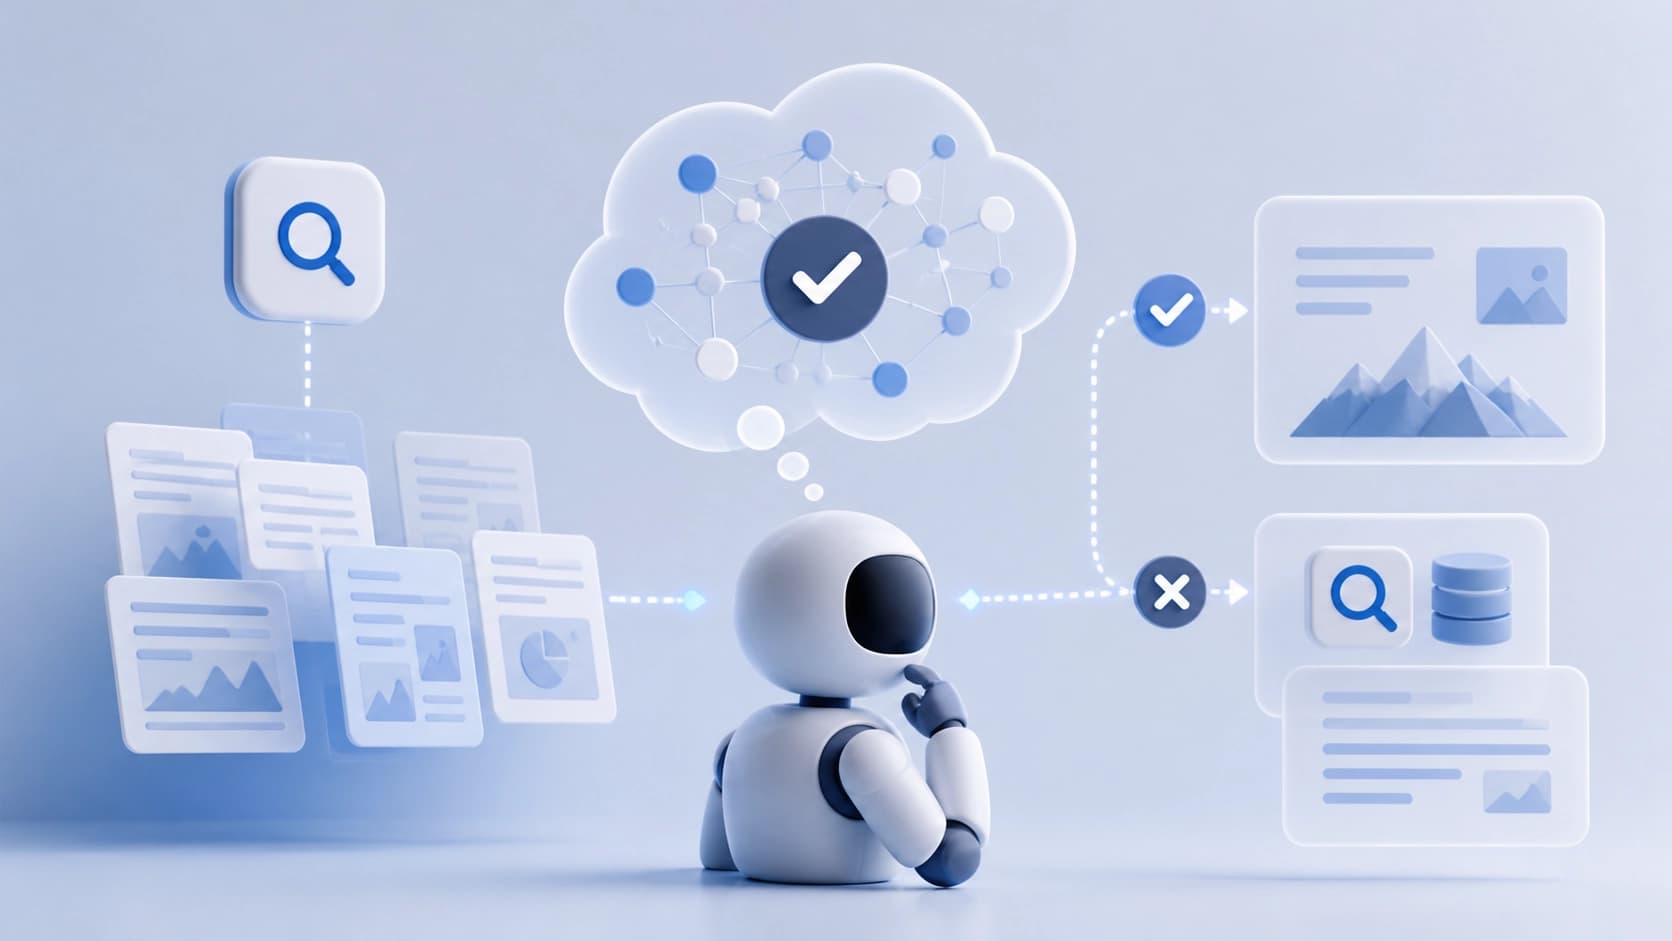
एजेंटिक RAG एक चक्र की तरह काम करता है: मॉडल प्रश्न पढ़ता है, तय करता है कि खोज का एक और अनुरोध चाहिए या नहीं, परिणाम प्राप्त करता है और फिर चुनता है — आगे खोजना है या उत्तर देना है। हर अतिरिक्त पुनरावृत्ति में पैसा और समय लगता है, और हर छूटी हुई पुनरावृत्ति अधूरे उत्तर का जोखिम बनाती है। नतीजा यह है कि एजेंट का मुख्य कौशल दस्तावेज़ निकालना नहीं, बल्कि सही समय पर "प्रमाण पर्याप्त हैं" कह पाना है।
क्लासिकल रीइन्फोर्समेंट लर्निंग ऐसे व्यवहार को बाहर से आँकती है: उत्तर संदर्भ से मेल खाया — प्लस, नहीं खाया — माइनस। इस बात की कोई पूछताछ नहीं होती कि मॉडल स्वयं एकत्रित तथ्यों की पूर्णता के बारे में क्या सोचता है। यहीं से दो सममित बीमारियाँ जन्म लेती हैं: नीति या तो तब भी खोदती रहती है जब भीतर सब स्पष्ट हो चुका होता है, या फिर खोज रोक देती है जबकि डेटा स्पष्ट रूप से कम है। बाहरी इनाम इन स्थितियों में फ़र्क़ नहीं करता — नतीजा एक ही होता है, पर व्यवहार अलग।
समस्या-निरूपण में बदलाव
MetaRAG शोधकर्ता केवल क्रिया पर नहीं, बल्कि इस पर भी ध्यान देने का सुझाव देते हैं कि वह क्रिया एजेंट की प्रमाण-पर्याप्तता के बारे में आंतरिक धारणा से कितनी मेल खाती है। इस निरूपण को वे विश्वास-क्रिया संरेखण — belief-action alignment — कहते हैं। विचार सरल है: खोज के निर्णय की गुणवत्ता उत्तर के ऊपर एक अलग मीट्रिक नहीं, बल्कि इस बात का संरेखण है कि मॉडल "सोचता" क्या है और करता क्या है।
MetaRAG कैसे बना है
यह फ़्रेमवर्क तीन भागों से बना है: क्रिया से पहले स्पष्ट सत्यापन, आंतरिक विश्वास का प्रोब, और एक विशेष इनाम जो एक को दूसरे से जोड़ता है।
क्रिया से पहले सत्यापन
पहला घटक है Verify-first Action Generation। अगला कदम तुरंत जारी करने के बजाय, नीति पहले उसे एक स्पष्ट सत्यापन प्रक्रिया से गुज़ारती है: क्या यह क्रिया खोज की वर्तमान स्थिति के अनुकूल है। मंशा यह है कि आवेगपूर्ण निर्णयों को प्रक्षेपवक्र में शामिल होने से पहले ही छान लिया जाए। मूलतः यह जनरेशन में अंतर्निहित एक "स्टॉप-फ़्रेम" है, जिसकी कमी तेज़ एजेंटों में आमतौर पर खलती है।
आंतरिक विश्वास का प्रोब
दूसरा घटक है Internal Belief Probing। उसी संदर्भ से, जो नीति देखती है (प्रश्न सहित क्रियाओं और अवलोकनों का इतिहास), उसकी अपनी राय अलग से पढ़ी जाती है: क्या अभी ही उत्तर दिया जा सकता है। महत्वपूर्ण यह है कि यह कोई बाहरी निर्णायक मॉडल या मानव एनोटेशन नहीं है — संकेत उसी नीति से लिया जाता है, बस एक अलग तरीके से पूछकर।
गार्डरेल सहित संरेखण इनाम
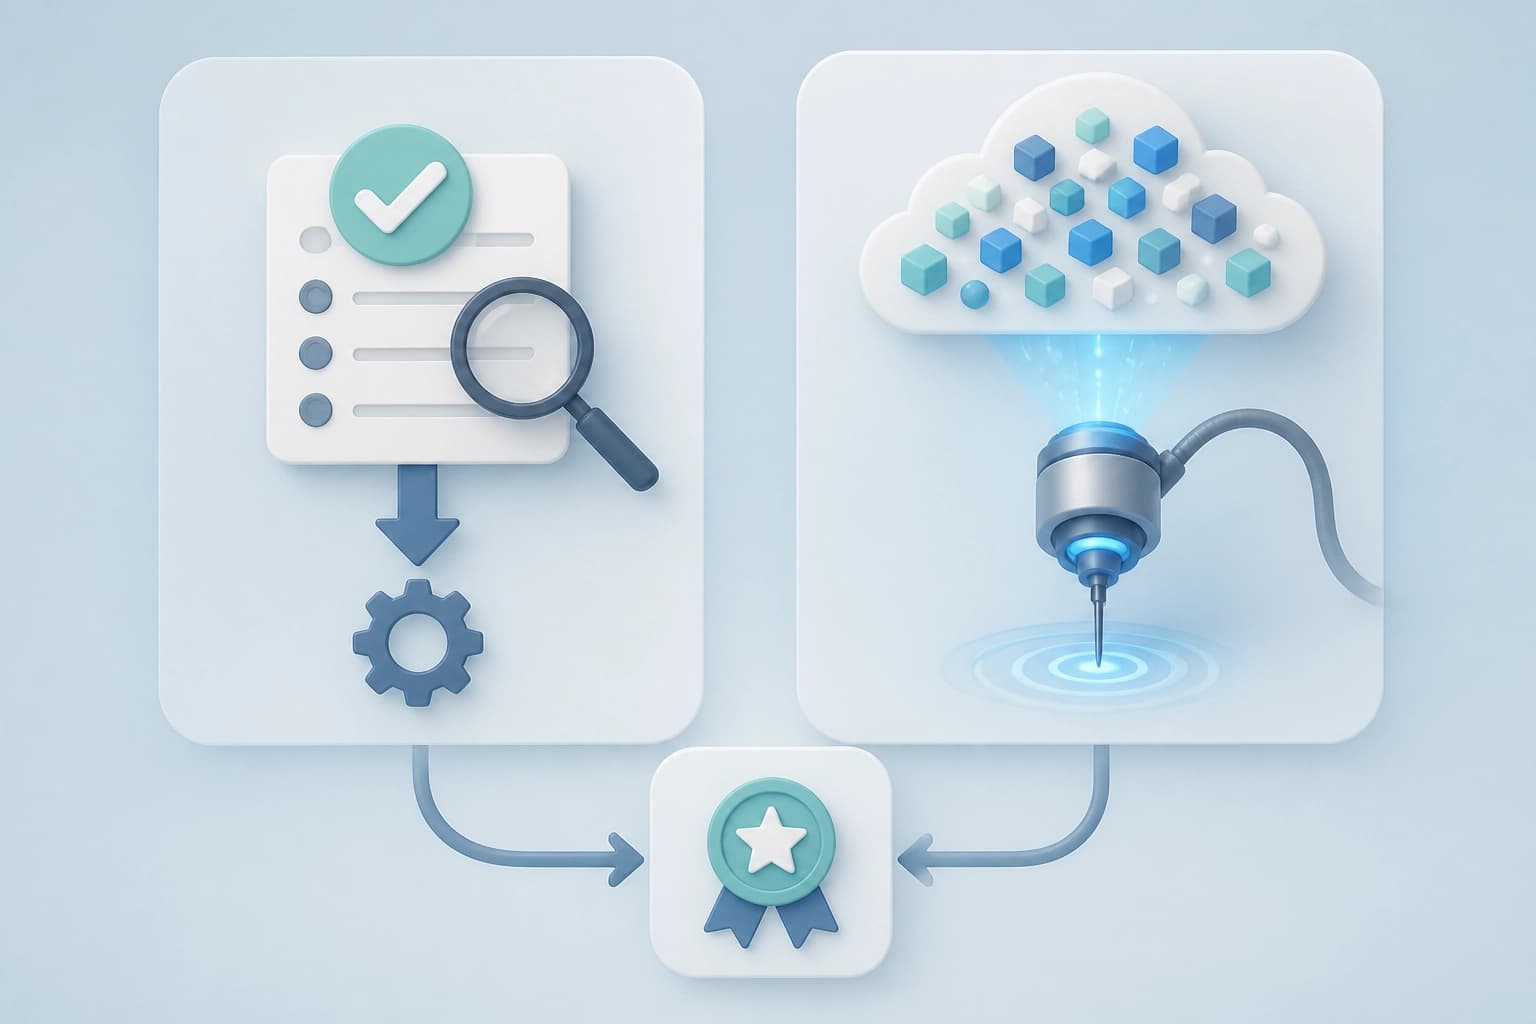
इन दो संकेतों से consistency reward निकाला जाता है: एजेंट को तब प्रोत्साहन मिलता है जब उसकी क्रिया प्रमाण-पर्याप्तता के आंतरिक आकलन से मेल खाती है। यहाँ एक स्पष्ट जाल है — "आत्मविश्वास से गलत" व्यवहार को इनाम दिया जाने लग सकता है, यदि मॉडल सुसंगत ढंग से और लगातार गलती करे। शोधकर्ता इसे एक गेट से बंद करते हैं: संरेखण का इनाम तभी गिना जाता है जब उत्तर सही निकला हो। दूसरे शब्दों में, संरेखण स्वयं में लक्ष्य नहीं, बल्कि शुद्धता का गुणक है।
व्यवहारकर्ताओं के लिए एक अलग और महत्वपूर्ण ब्यौरा: विश्वास का प्रोब केवल प्रशिक्षण चरण में रहता है। इन्फ़रेंस में इसे नहीं बुलाया जाता, इसलिए हर अनुरोध पर अतिरिक्त गणना नहीं होती — ओवरहेड शून्य रहता है।
प्रयोगों ने क्या दिखाया
यह कार्य प्रश्न-उत्तर के सात सार्वजनिक बेंचमार्कों पर परखा गया है। दावा किया गया परिणाम यह है — एजेंटिक RAG के लिए मज़बूत RL-आधारभूत तरीकों की तुलना में शुद्धता और दक्षता के बीच समझौते में स्थायी सुधार। यानी लाभ केवल अधिक सटीक उत्तर देने में नहीं, बल्कि इस बात में है कि इसके लिए अनंत खोज की कीमत न चुकानी पड़े।
आगे शोधकर्ताओं ने जाँचा कि यह प्रभाव कितना स्थानांतरित होता है: गहन शोध (deep research) परिदृश्य पर, विभिन्न ऑप्टिमाइज़रों पर और विभिन्न आधार मॉडलों पर। उनके आँकड़ों के अनुसार, इन सभी विन्यासों में यह विधि अपना लाभ बनाए रखती है। यह ठीक उसी प्रकार की जाँच है जिसकी अक्सर कमी रहती है: एक मॉडल और एक डेटासेट पर सुधार को हाइपरपैरामीटर की भाग्यशाली ट्यूनिंग समझ लेना आसान है।
व्यवहार में इसका क्या अर्थ है
एजेंटिक सर्च सिस्टम बनाने वालों के लिए MetaRAG एक ऐसी दिशा सुझाता है जो दिखने में जितनी महँगी लगती है, उससे कम खर्चीली है। यदि आपके पास नीति का प्रशिक्षण पहले से है, तो आंतरिक विश्वास का संकेत जोड़ने के लिए नए एनोटेटरों की ज़रूरत नहीं: वही संदर्भ, जो नीति वैसे भी देखती है, संकेत के स्रोत के रूप में इस्तेमाल किया जा सकता है। शुद्धता का गेट यहाँ अनिवार्य है — इसके बिना एजेंट सुंदर ढंग से और आत्मविश्वास से गलती करना सीख सकता है।
दूसरा निष्कर्ष समग्र रूप से इनाम के डिज़ाइन से जुड़ा है। बाहरी मीट्रिकें इस प्रश्न का उत्तर देती हैं कि "काम बना या नहीं", पर यह लगभग कुछ नहीं बतातीं कि "एजेंट उस क्षण में उपयुक्त था या नहीं"। इन दोनों चीज़ों में फ़र्क़ करना ही इस पेपर का मुख्य विचार है: विश्वास और क्रिया के बीच संरेखण एक स्वतंत्र, अलग से अनुकूलन योग्य वस्तु है, न कि शुद्धता बढ़ने का कोई दुष्प्रभाव।
फिर भी, सीमाएँ ध्यान में रखनी चाहिए: प्रयोग QA बेंचमार्कों और गहन शोध परिदृश्यों तक सीमित हैं, और यह दृष्टिकोण स्वयं RL-प्रशिक्षण के ऊपर बना है, यानी उन सिस्टमों पर "आउट ऑफ़ द बॉक्स" लागू नहीं होता जहाँ नीति का प्रशिक्षण ही नहीं होता। ऐसे मामलों के लिए विचार स्वयं अधिक उपयोगी है — क्रिया को निष्पादन से पहले स्पष्ट रूप से जाँचना और अलग से आँकना कि निर्णय डेटा की पर्याप्तता की आंतरिक भावना से मेल खाता है या नहीं।
पूरा पाठ arXiv:2608.24214 (v1, 25 अगस्त 2026, अनुभाग cs.AI) के रूप में उपलब्ध है — यह कार्य EMNLP 2026 सम्मेलन के मुख्य कार्यक्रम में स्वीकृत हुआ है।