स्केलर गुणनफल एक अड़चन के रूप में
लगभग सभी आधुनिक अटेंशन आर्किटेक्चर एक ही तरह से बने होते हैं: क्वेरी और की का मिलान स्केलर गुणनफल (या उसके सामान्यीकृत संस्करण) के ज़रिए किया जाता है, परिणाम को वेट में बदला जाता है, और आउटपुट को वैल्यूज़ के भारित योग के रूप में जोड़ा जाता है। यह तरीका सार्वभौमिक है, लेकिन इसकी एक कीमत है — ऐसी योजना में फ़ीचर स्पेस की ज्यामिति कठोरता से तय होती है: समानता "सीधी रेखा" में मापी जाती है, इस बात का ध्यान रखे बिना कि स्पेस में अलग-अलग दिशाओं का महत्व और पैमाना अलग-अलग हो सकता है।
यही इस सीमा को ध्यान में रखते हुए arXiv:2608.24462 «Mahalanobis-Based Multi-Head Attention for Complex State Propagation» (लेखक — Xiaohe Li; श्रेणी cs.AI) पर काम किया गया है। इसमें सामान्य गुणनफल के बजाय महालनोबिस दूरी पर आधारित RBF-कर्नेल का उपयोग किया गया है। सरल शब्दों में, अनुक्रम के तत्वों के बीच समानता "सीधे" नहीं, बल्कि डेटा की सहप्रसरण संरचना को ध्यान में रखते हुए आँकी जाती है — मानो तुलना से पहले स्पेस को थोड़ा खींचकर और घुमाकर इस तरह ढाल दिया गया हो कि सहसंबद्ध दिशाएँ स्वतंत्र न मानी जाएँ।
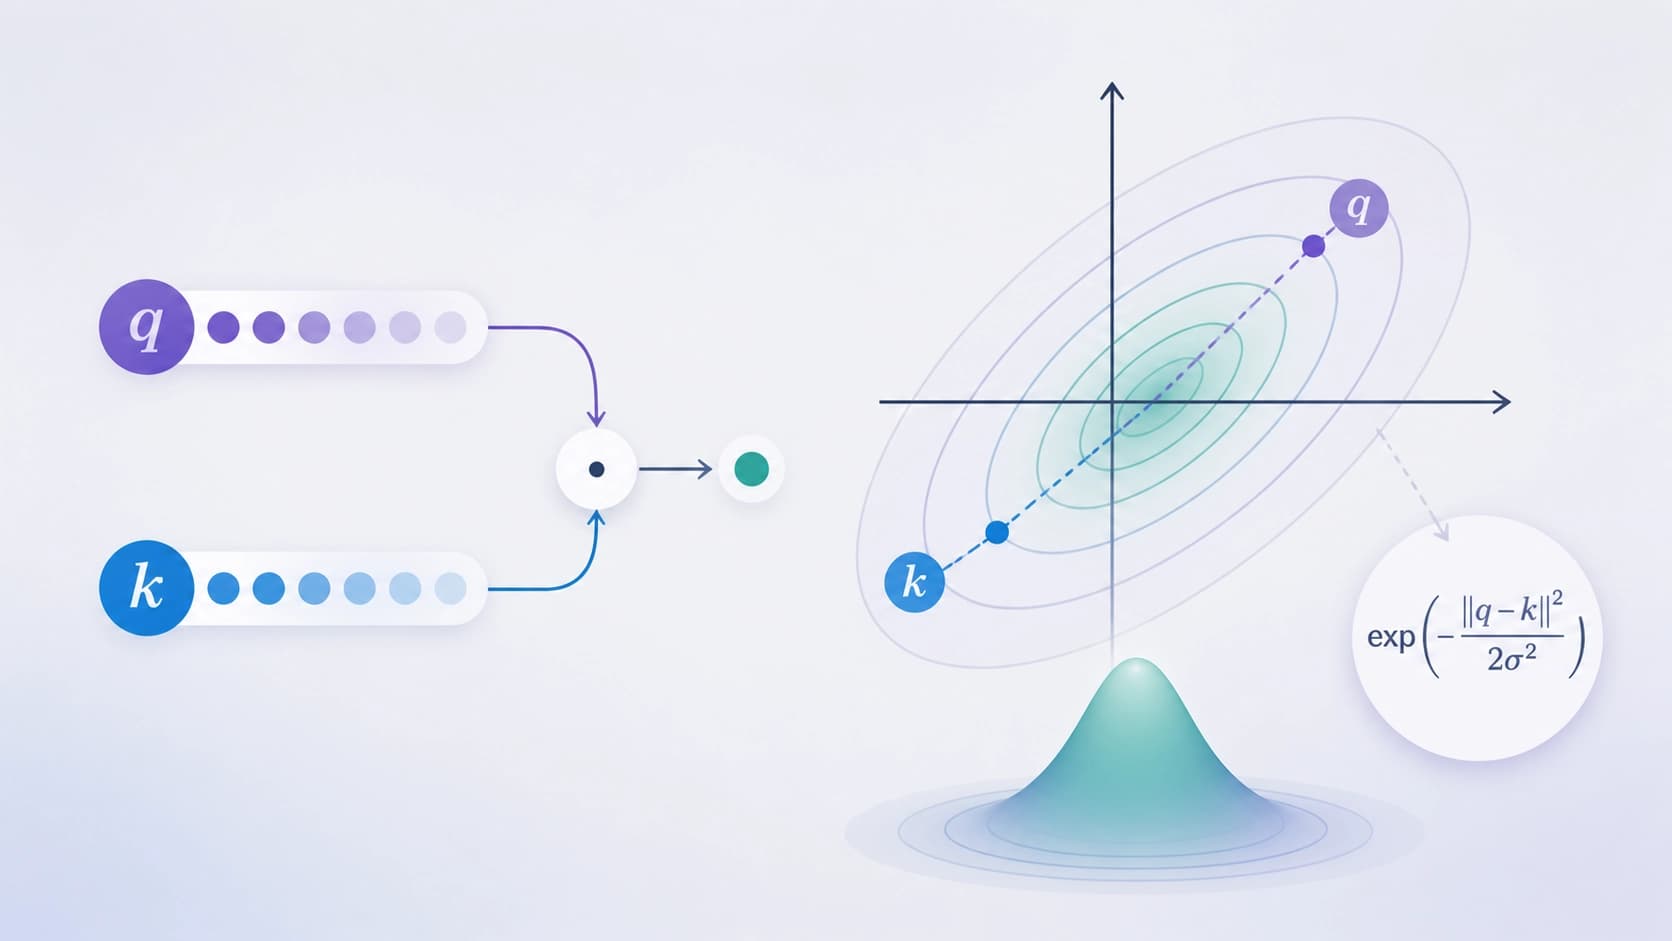
महालनोबिस दूरी क्या देती है
अनंत-आयामी स्पेस में अटेंशन, बिना पैरामीटर बढ़ाए
लेखक का मुख्य दावा यह है: महालनोबिस दूरी पर आधारित RBF-कर्नेल अटेंशन की गणना इस तरह करने देता है मानो वह अनंत-आयामी फ़ीचर स्पेस में हो, लेकिन साथ ही सीखे जाने वाले पैरामीटरों की संख्या नहीं बढ़ती। यह कोई जादू नहीं, बल्कि इसका परिणाम है कि कर्नेल स्वयं एक अरैखिक मैपिंग तय करता है — फ़ीचर खोलने के लिए अलग लेयर की ज़रूरत नहीं पड़ती। व्यवहार में इसका मतलब है मेमोरी और ऑप्टिमाइज़ेशन पर कम माँगें, जो विशाल मॉडलों के युग में लगभग उकसाने वाला लगता है।
धनात्मक निश्चितता और Tree Attention
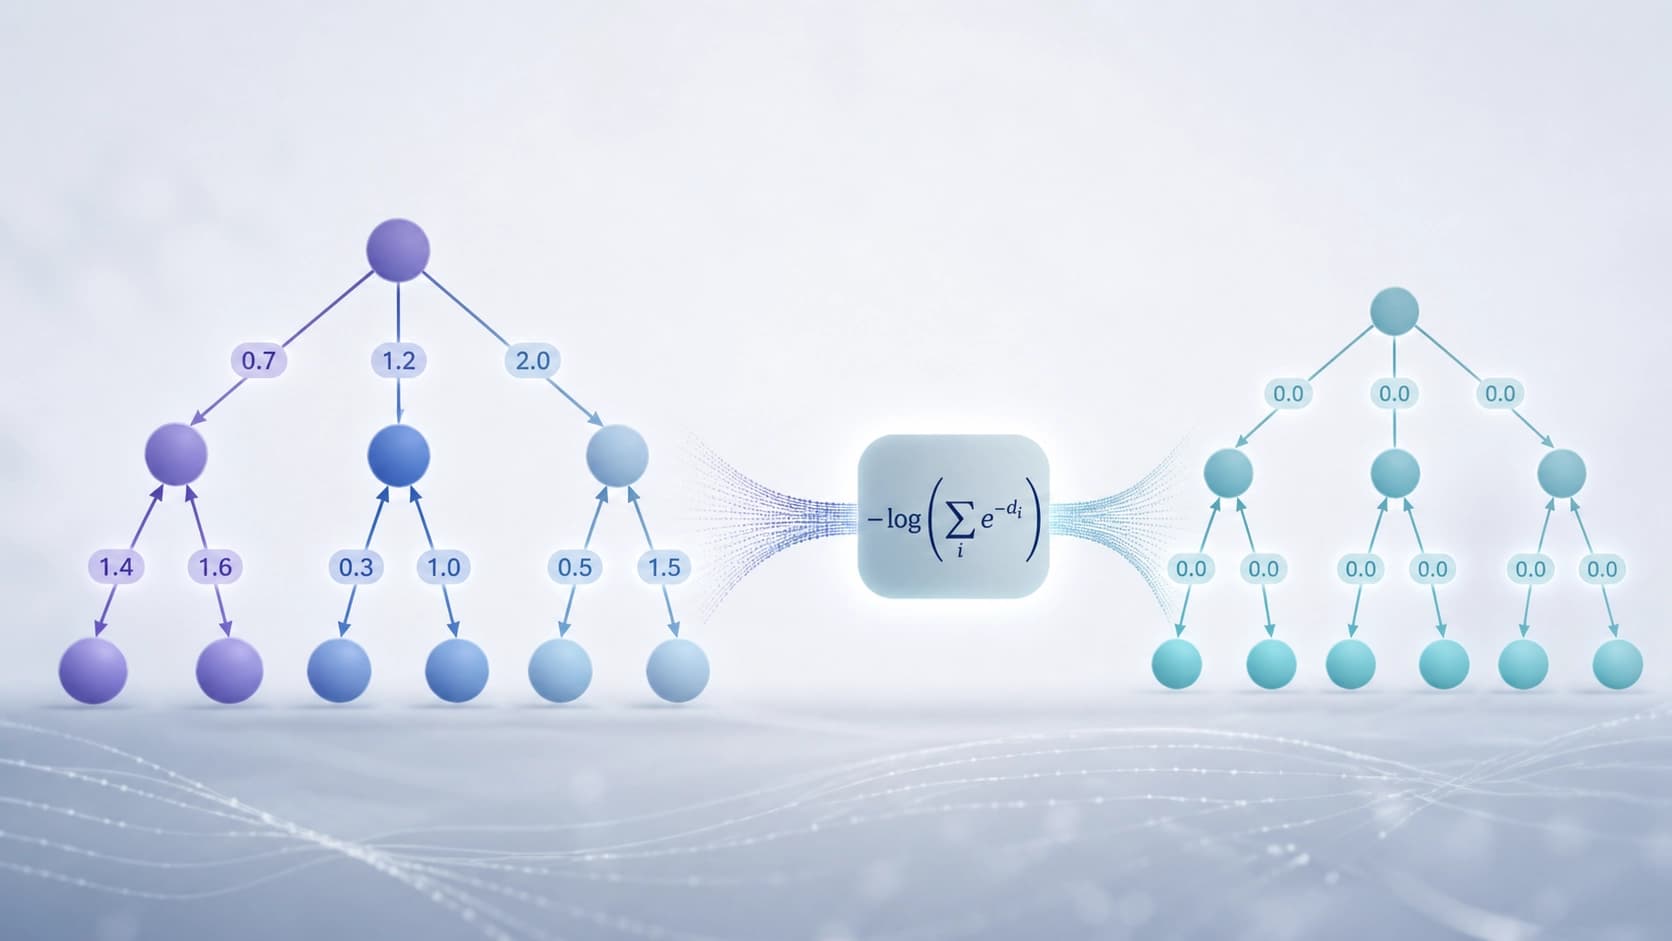
विचार की दूसरी परत महालनोबिस दूरी के एक गणितीय गुण पर टिकी है: यह धनात्मक निश्चित (positive definite) होती है। इसी से सीधे वह चीज़ बनाई जा सकती है जिसे लेख में Tree Attention कहा गया है — अटेंशन स्कोर "कच्ची" समानताओं से नहीं, बल्कि पेड़ पर संचित दूरियों से बनाए जाते हैं। ऐसे संचय संख्यात्मक रूप से भटक न जाएँ, इसके लिए LogSumExp के ज़रिए सुधार लागू किया जाता है: दूरी में से किनारों पर घातांकों के योग का लघुगणक घटाया जाता है। मूल रूप से यह पेड़ में अलग-अलग पथों के योगदानों को उनका सापेक्ष भार खोए बिना सुसंगत बनाने का तरीका है।
जो पाठक बारीकियों से परिचित नहीं है, उसके लिए एक उपयोगी उपमा यह है: "समानताओं" को बेतरतीब ढंग से जोड़ने के बजाय, मॉडल संरचना में गहराई तक बढ़ते हुए उन्हें सावधानी से सामान्यीकृत करता है। यह अंतर्ज्ञान से अधिक बहीखाते जैसा है — लेकिन यही सावधानी लंबी निर्भरता शृंखलाओं पर तर्क को स्थिर बनाए रखने देती है।
Attention meshing: हेड्स एक-दूसरे से बात करने लगते हैं
आम तौर पर मल्टी-हेड अटेंशन लगभग स्वतंत्र विशेषज्ञों के समूह की तरह होता है: हर हेड अपना हिसाब करता है, और मिश्रण केवल आउटपुट पर, एक रैखिक प्रोजेक्शन से होता है। MHA-CSP में महालनोबिस दूरी मैट्रिक्स का पुनः उपयोग किया जाता है — इनके आधार पर "attention meshing" तंत्र बनाया जाता है, जो अलग-अलग हेड्स के कर्नेल को सीधे परस्पर क्रिया करने पर मजबूर करता है। लेखक दोहरा लाभ बताता है: सटीकता भी बेहतर, और प्रशिक्षण भी अधिक कुशल, क्योंकि वही गणनात्मक काम दोहराया नहीं जाता।
प्रयोग: 119K पैरामीटर बड़े बेसलाइन मॉडलों के मुकाबले
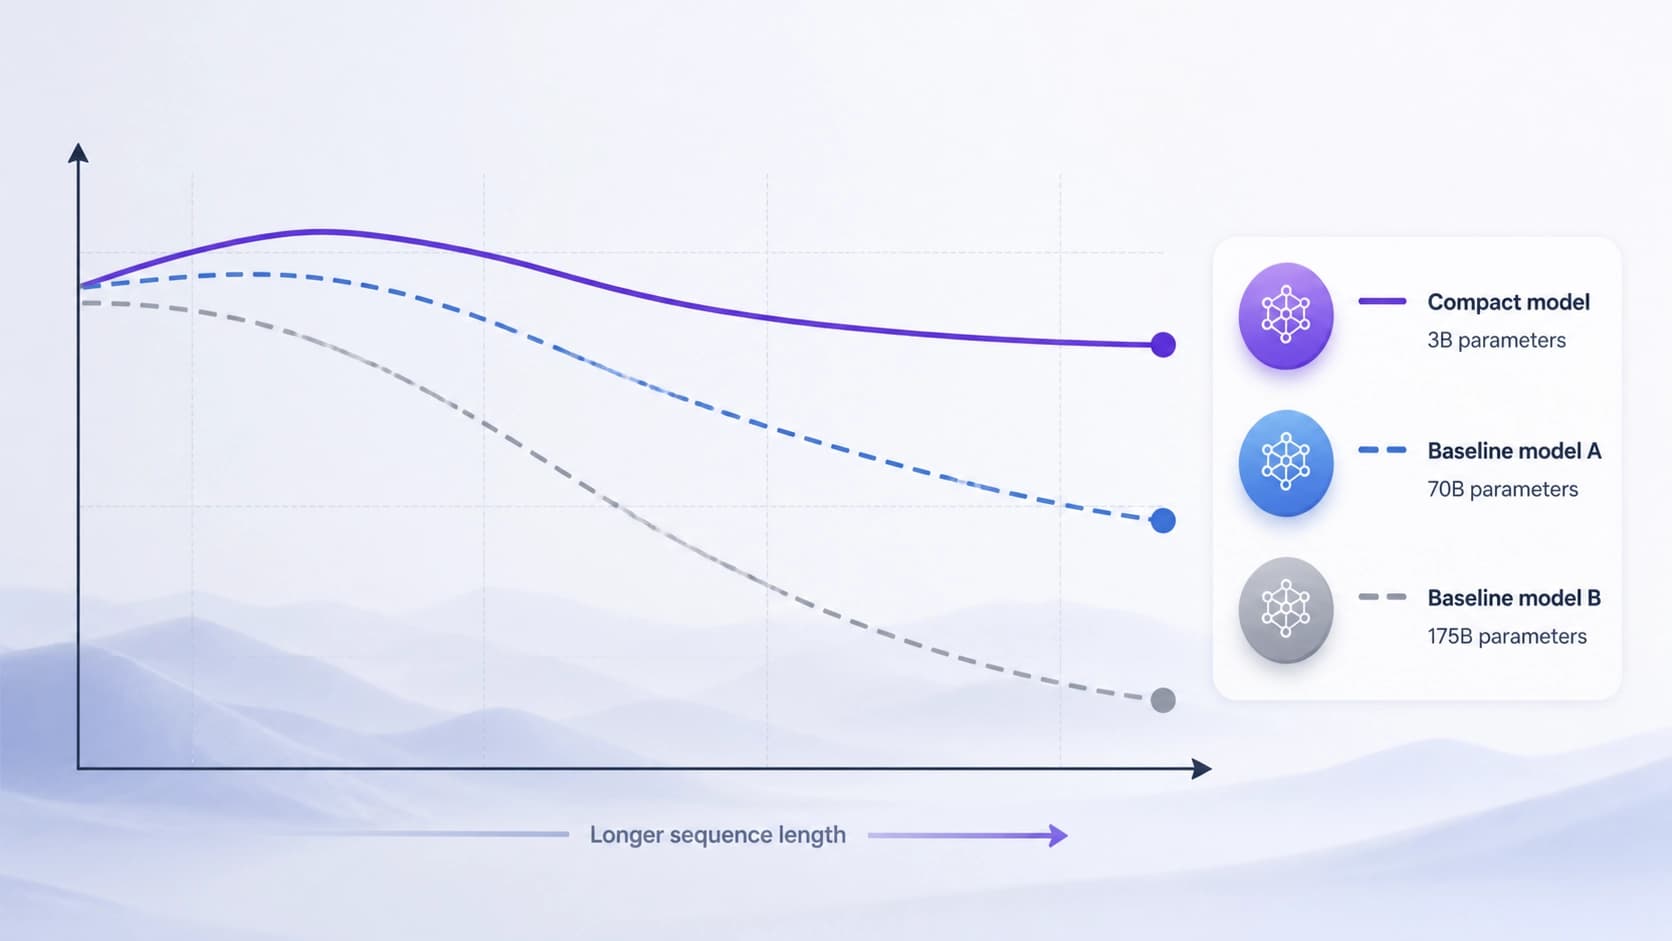
काम का सबसे चर्चित हिस्सा तुलना है। केवल 119 हज़ार पैरामीटरों वाले MHA-CSP की तुलना बेसलाइन ट्रांसफ़ॉर्मरों और ग्राफ़ कन्वोल्यूशनल नेटवर्कों से की जाती है, जिन्हें समान परिस्थितियों में शून्य से प्रशिक्षित किया गया। कार्य है — लंबे अनुक्रमों पर अवस्थाओं का अनुसरण। साथ ही teacher forcing केवल अंतिम छिपी अवस्था पर लागू किया गया, यानी मॉडल को हर चरण पर संकेत नहीं मिला, जैसा अक्सर प्रशिक्षण में किया जाता है।
लेखक के दावे के अनुसार, MHA-CSP लगातार प्रतिस्पर्धियों से आगे निकलता है। बेसलाइन मॉडल या तो सघन अटेंशन (ट्रांसफ़ॉर्मर) पर निर्भर करते हैं, या ग्राफ़ पर सूचना के प्रसार (GCN) पर, जबकि MHA-CSP दूरियों के संश्लेषित सुधार और backbone CSP से विरासत में मिली किफ़ायती सूचना यात्रा के ज़रिए संरचित तर्क हासिल करता है।
यह रेखांकित करना ज़रूरी है: बात यह नहीं है कि छोटा मॉडल हर चीज़ में बड़े मॉडलों को "पकड़ लेता" है। बात एक विशिष्ट वर्ग के कार्यों की है — आंतरिक प्रतीकात्मक संरचना वाले लंबे अनुक्रम, जहाँ केवल संदर्भ याद रखना नहीं, बल्कि उसकी अवस्था बनाए रखना महत्वपूर्ण है। यहीं दूरियों की ज्यामिति और वृक्ष-आधारित सामान्यीकरण काम करने लगते हैं।
व्यवहार में यह क्या बदलता है
काम का मुख्य निष्कर्ष इस प्रकार है: जटिल-मानीय अवस्था प्रसार (complex-valued state propagation) और संयुक्त मल्टी-हेड सुधार का संयोजन प्रतीकात्मक संरचनाओं को पकड़ने के लिए एक कारगर उपकरण साबित होता है। और संरचित तर्क के कार्यों के लिए दक्षता और गुणवत्ता के बीच एक नया समझौता तय करता है।
व्यापक रूप से देखें तो इसमें हाल के वर्षों की एक प्रवृत्ति दिखती है: पैरामीटर बढ़ाने के बजाय शोधकर्ता अधिक उपयुक्त आगमनात्मक पूर्वाग्रह खोजते हैं — यानी आर्किटेक्चर में डेटा की प्रकृति के बारे में सही अनुमान पहले से डाल देते हैं। स्केलर गुणनफल सुविधाजनक था, लेकिन काफ़ी मोटा अनुमान। उसे सहप्रसरण मीट्रिक वाले कर्नेल से बदलना एक कोशिश है मॉडल से यह कहने की: "स्पेस में सभी दिशाएँ समान नहीं हैं, इसे शुरू से ही ध्यान में रखो।"
एक सतर्क बाहरी दृष्टि
पाइपलाइनों को फिर से लिखने में जल्दबाज़ी न करने के कारण हैं। पहला, परिणाम अवस्था-अनुसरण के एक विशिष्ट कार्य-समूह पर प्राप्त हुए हैं; उन्हें टेक्स्ट जनरेशन, मल्टीमॉडैलिटी या संवाद परिदृश्यों पर बिना अलग जाँच के लागू नहीं किया जाना चाहिए — सारांश में ऐसे प्रयोग नहीं हैं। दूसरा, एकमात्र लेखक और प्रीप्रिंट का पहला संस्करण (v1, 25 अगस्त 2026 को प्रस्तुत) यह दर्शाते हैं कि हमने अभी तक स्वतंत्र पुनरावृत्ति नहीं देखी: 377 KB की फ़ाइल PDF, HTML और TeX स्रोतों में उपलब्ध है, लेकिन पुनरुत्पादन एक अलग कहानी है।
फिर भी दिशा उपजाऊ लगती है। स्केलर गुणनफल से दूर जाना, दूरियों की ज्यामिति के साथ सीधे काम करना, हेड्स के बीच गणनाओं का पुनः उपयोग — ये ठीक वही चालें हैं जो अभिव्यक्ति का त्याग किए बिना मॉडल की लागत घटाती हैं। अगर परिणाम अन्य डोमेनों पर भी पुष्ट होते हैं, तो "छोटे, लेकिन सही ढंग से बने" नेटवर्कों के पास एक और ठोस तर्क होगा।