पूर्ण फाइन-ट्यूनिंग अब एक समझदार विकल्प नहीं रही
इलेक्ट्रोएन्सेफैलोग्राफी के लिए फाउंडेशनल मॉडल बिना लेबल के प्रशिक्षित किए जाते हैं — कॉन्ट्रास्टिव कार्यों पर या सिग्नल के मास्क किए गए हिस्सों को फिर से बनाने पर। तर्क यह है: मॉडल लय, आर्टिफैक्ट और अवस्थाओं के बीच संक्रमण के सामान्य पैटर्न सीख लेता है, और फिर उसे एपिलेप्टिक डिस्चार्ज की पहचान जैसे किसी संकीर्ण कार्य के लिए आगे प्रशिक्षित किया जाता है। सिद्धांत में यह ऐसे प्रतिनिधित्व देता है जो क्लीनिकों और उपकरणों के बीच स्थानांतरित हो जाते हैं। व्यवहार में सब कुछ अधिक जटिल है: रिकॉर्डिंग के क्लिनिकल अभिलेख एक-दूसरे से बहुत अलग होते हैं, और स्थानांतरण की गुणवत्ता स्पष्ट रूप से गिर जाती है।
दूसरी समस्या — अर्थशास्त्र। क्लासिक फाइन-ट्यूनिंग सभी वेट अपडेट करती है, यानी हर नए कार्य के लिए गंभीर कंप्यूटेशनल संसाधनों की आवश्यकता होती है। GPU-क्लस्टर के बिना किसी विभाग में ऐसा परिदृश्य चल ही नहीं सकता। यहीं से वह प्रश्न उठता है जिस पर arXiv:2608.24727 का काम आधारित है: क्या पैरामीटरों के एक छोटे हिस्से से काम चलाया जा सकता है और फिर भी गुणवत्ता न खोई जाए?
नौ प्रतिशत: वास्तव में क्या ट्यून किया जाता है
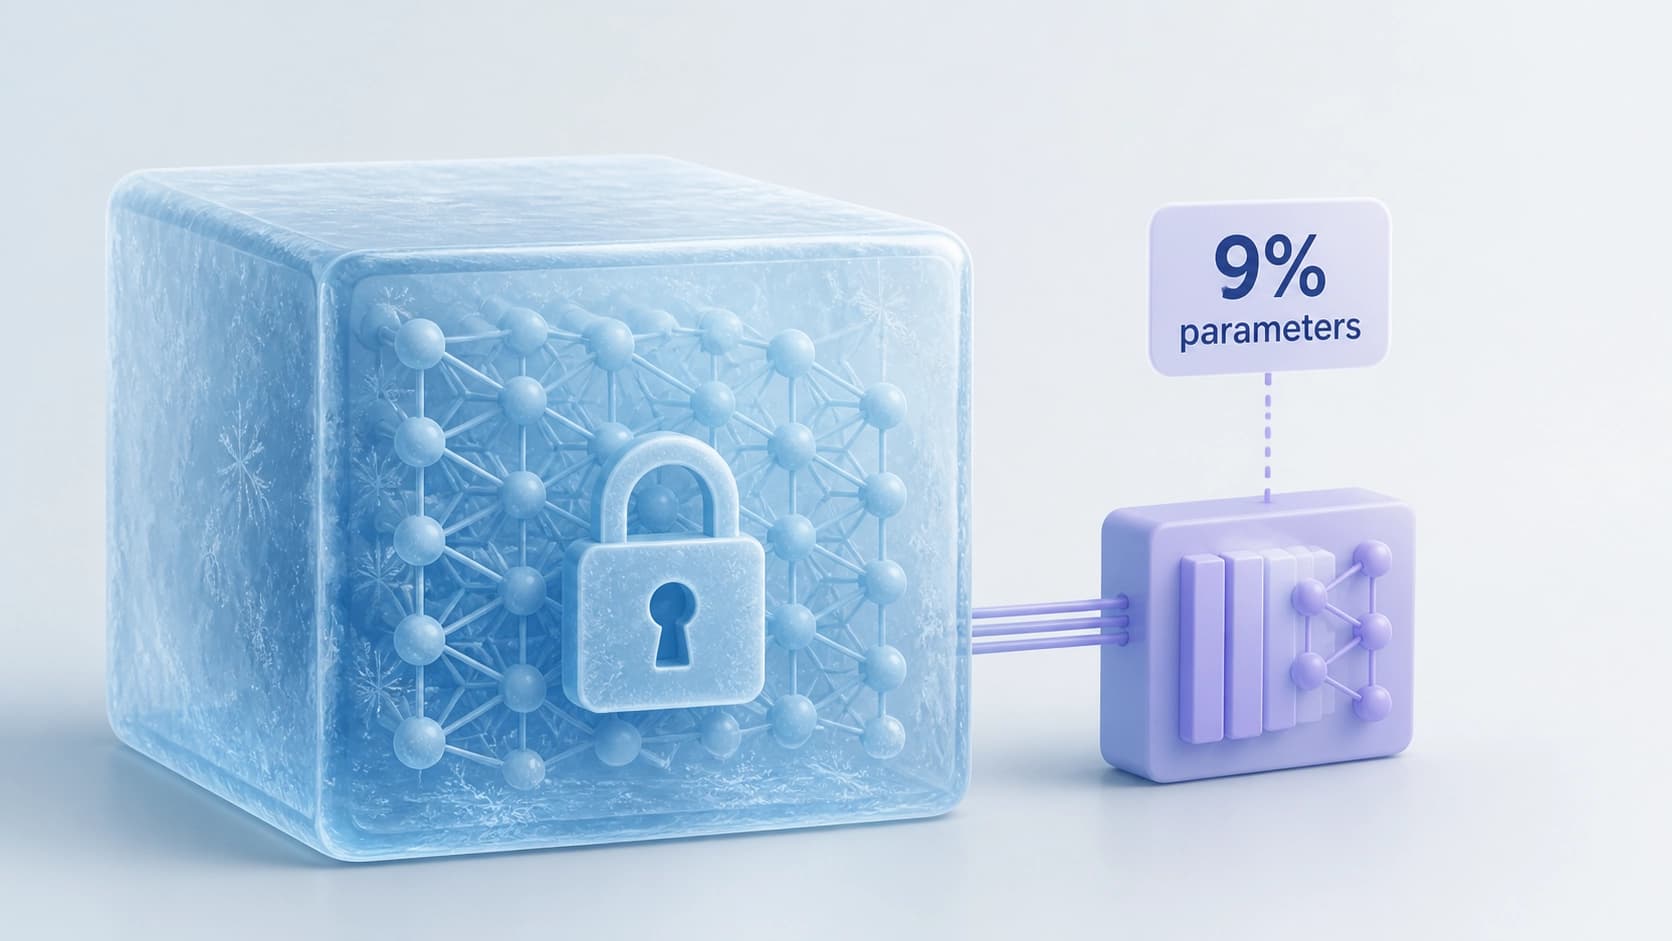
प्रीप्रिंट के लेखक — Meghal Dani और Stefanie Liebe हैं। वे ऐसे मोड की जाँच करते हैं जिसमें लगभग 9% वेट प्रशिक्षित रहते हैं, और मॉडल का बाकी हिस्सा फ्रीज़ कर दिया जाता है। अनुकूलन स्व-प्रशिक्षण की तरह होता है: मॉडल को केवल क्लास लेबल के अनुरूप ढाला नहीं जाता, बल्कि आंतरिक प्रतिनिधित्व को लक्ष्य कार्य के अनुसार संरेखित किया जाता है। पाठ 25 अगस्त 2026 को प्रकाशित हुआ (संस्करण v1), इसे cs.LG और cs.AI अनुभागों में रखा गया है, DOI — 10.48550/arXiv.2608.24727। कोड प्रतिकृति के लिए खुला है।
मतलब यह नहीं कि एक "कटा-छाँटा" मॉडल बना है। यह उपयोग का एक अलग तरीका है: भारी पूर्व-प्रशिक्षित एनकोडर अपरिवर्तित रहता है, और हर नए कार्य के लिए एक कॉम्पैक्ट ओवरले ट्यून किया जाता है। क्लिनिक के लिए यह विभाजन मूलभूत है — महँगा पूर्व-प्रशिक्षण एक बार किया जाता है, सस्ता अनुकूलन जितनी बार चाहें दोहराया जाता है।
अलग-अलग पूर्व-प्रशिक्षण लक्ष्यों वाले दो मॉडल
ताकि परिणाम किसी एक सफल आर्किटेक्चर पर निर्भर न हो, प्रयोग में दो SOTA मॉडल शामिल हैं: कॉन्ट्रास्टिव लक्ष्य वाला BIOT और मास्क किए गए हिस्सों को फिर से बनाने पर प्रशिक्षित CBraMod। अगर यह तरीका दोनों मामलों में काम करता है, तो बात संयोग की नहीं, बल्कि दृष्टिकोण के एक गुण की है।
तीन क्लिनिकल सेट और दो परीक्षण मोड
मूल्यांकन TUAB (विसंगतियों का पता लगाना), TUEV (घटनाओं का वर्गीकरण) और CHB-MIT (दौरों का पता लगाना) पर किया जाता है। मापन दो बार किए जाते हैं — in-distribution और out-of-distribution, यानी जाँच केवल "अपने" डेटा पर ही नहीं, बल्कि स्थानांतरित वितरण पर भी होती है।
परिणामों ने क्या दिखाया
- लीनियर प्रोबिंग की तुलना में स्व-प्रशिक्षण अनुकूलन लगातार बढ़त देता है — AUCPR में 20 गुना तक। यह "थोड़ा बेहतर" नहीं, बल्कि परिमाण के क्रम का अंतर है, और यह खास तौर पर वहाँ दिखता है जहाँ दुर्लभ वर्ग समग्र accuracy से अधिक महत्वपूर्ण होता है।
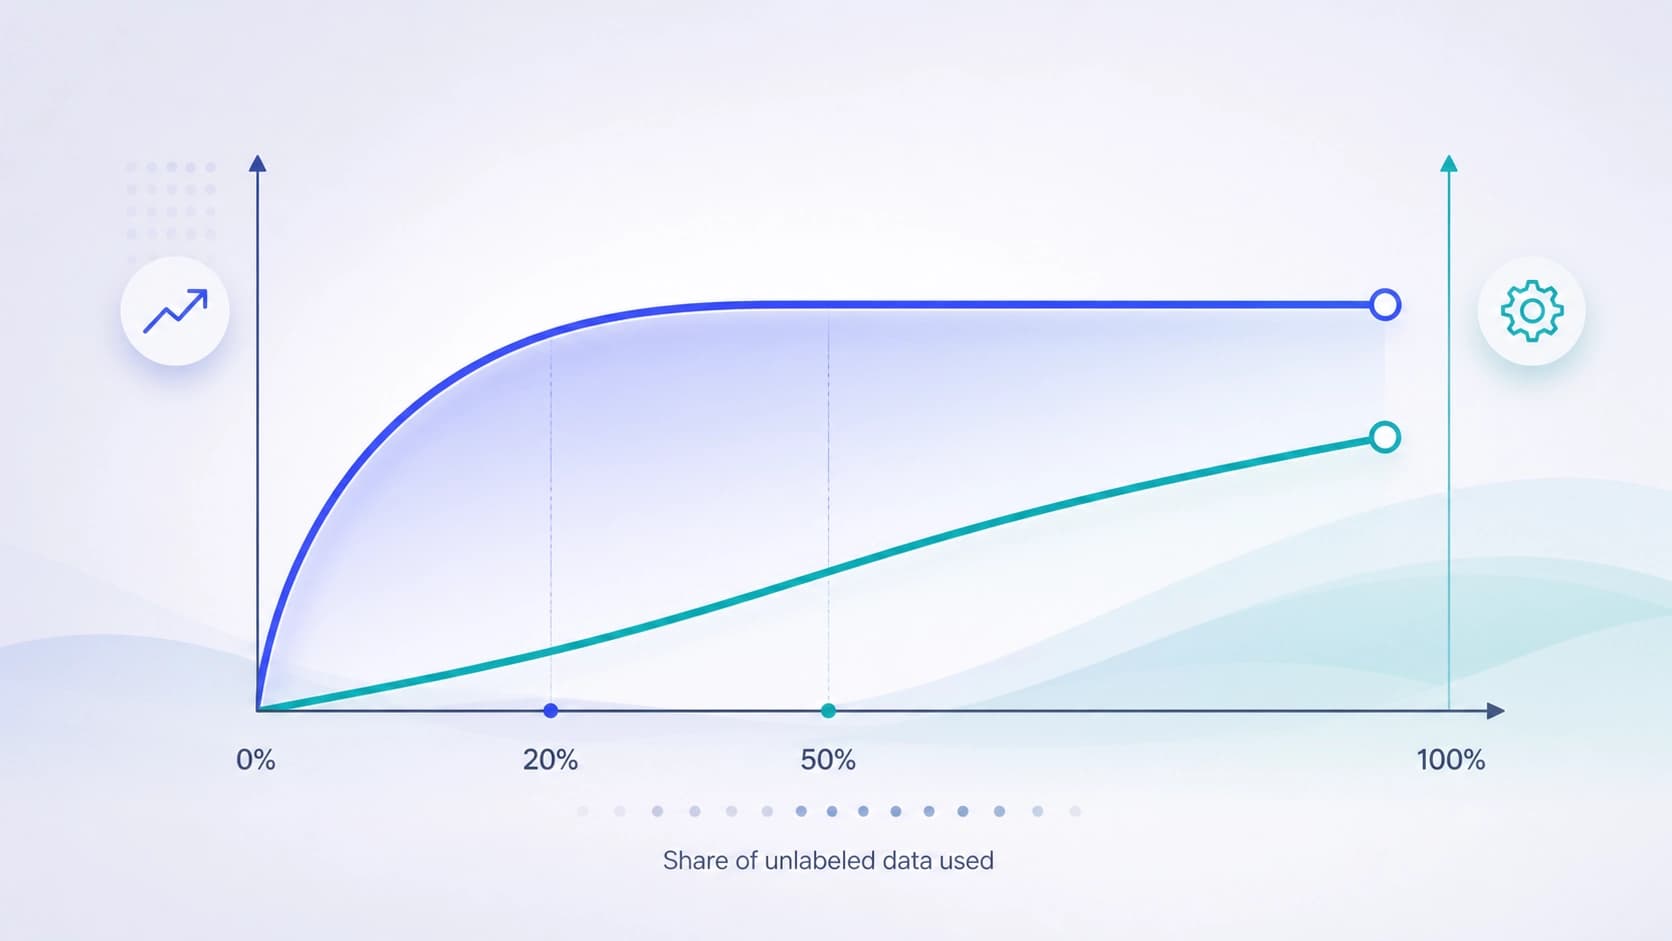
- तय कंप्यूटेशनल बजट पर शिखर उपलब्ध बिना-लेबल रिकॉर्डिंग के केवल 20–50% पर ही पहुँच जाता है। बाकी कॉर्पस अब कोई बढ़त नहीं जोड़ता।
- अगर सिग्नल विंडो की कुल संख्या तय हो, तो परिणाम इस पर निर्भर नहीं करता कि उसमें कितने मरीज़ शामिल हुए। यानी काम "लोगों की विशिष्टता" नहीं, बल्कि टुकड़ों की समय-आधारित विविधता करती है: रिकॉर्डिंग के भीतर अलग-अलग अवस्थाएँ, मोड और आर्टिफैक्ट।
आखिरी बिंदु डेटा संग्रह के सामान्य तर्क को उलट देता है। सहज रूप से लगता है कि जितने अधिक अलग-अलग मरीज़, उतना ही भरोसेमंद। यहाँ यह निकलता है कि विंडो की संख्या पर कड़ी सीमा होने पर कम लोगों से डेटा जुटाया जा सकता है — ज़रूरी बस यह है कि समय के साथ उनके सिग्नल की विविधता पर नज़र रखी जाए।
यह क्लिनिक के लिए समीकरण क्यों बदल देता है
अब तक EEG फाउंडेशनल मॉडलों को अपनाने में अड़चन प्रतिनिधित्व की गुणवत्ता नहीं, बल्कि बजट थी: मॉडल से लाभ पाने के लिए पूर्ण फाइन-ट्यूनिंग और एक बड़े लेबल किए गए कॉर्पस का खर्च उठाना पड़ता था। यह काम दिखाता है कि इस बाधा को एक साथ दो तरफ़ से कम किया जा सकता है — गणना और डेटा, दोनों में। सौ प्रतिशत और पूरी मात्रा के बजाय नौ प्रतिशत वेट और आधा बिना-लेबल अभिलेख।
अस्पताल के लिए इसका मतलब एक अधिक व्यावहारिक परिदृश्य है: मॉडल केंद्रीकृत रूप से पूर्व-प्रशिक्षित होता है, और मौके पर किसी विशिष्ट कार्य के लिए मामूली हार्डवेयर पर ट्यून किया जाता है। इस पर निर्भरता कम कि किसने अधिक रिकॉर्डिंग जुटाईं, और अतिरिक्त घंटों के सिग्नल को संग्रहीत और संसाधित करने का खर्च भी कम।
ध्यान में रखने योग्य बातें
इस परिणाम को "नौ प्रतिशत हमेशा काफी होता है" की तरह नहीं पढ़ना चाहिए। यह किसी विशिष्ट प्रयोग का विशिष्ट मोड है, न कि किसी भी आर्किटेक्चर और किसी भी डेटासेट के लिए सार्वभौमिक नुस्खा। लेखक स्वयं स्पष्ट करते हैं: EEG मॉडलों का सामान्यीकरण सीमित बना हुआ है, खासकर विषम क्लिनिकल कॉर्पस पर। पैरामीटर-कुशल अनुकूलन स्थानांतरण की समस्या को खत्म नहीं करता — यह केवल उसमें प्रवेश की कीमत घटाता है।
व्यावहारिक निष्कर्ष जितना लगता है उससे सरल है: बातचीत "क्या EEG के लिए फाउंडेशनल मॉडलों से जुड़ना चाहिए ही या नहीं" से हटकर "उन्हें विभाग में कैसे तैनात किया जाए" पर आ जाती है। और यह अब केवल मशीन लर्निंग का नहीं, बल्कि इंजीनियरिंग और प्रक्रिया संगठन का प्रश्न है।