
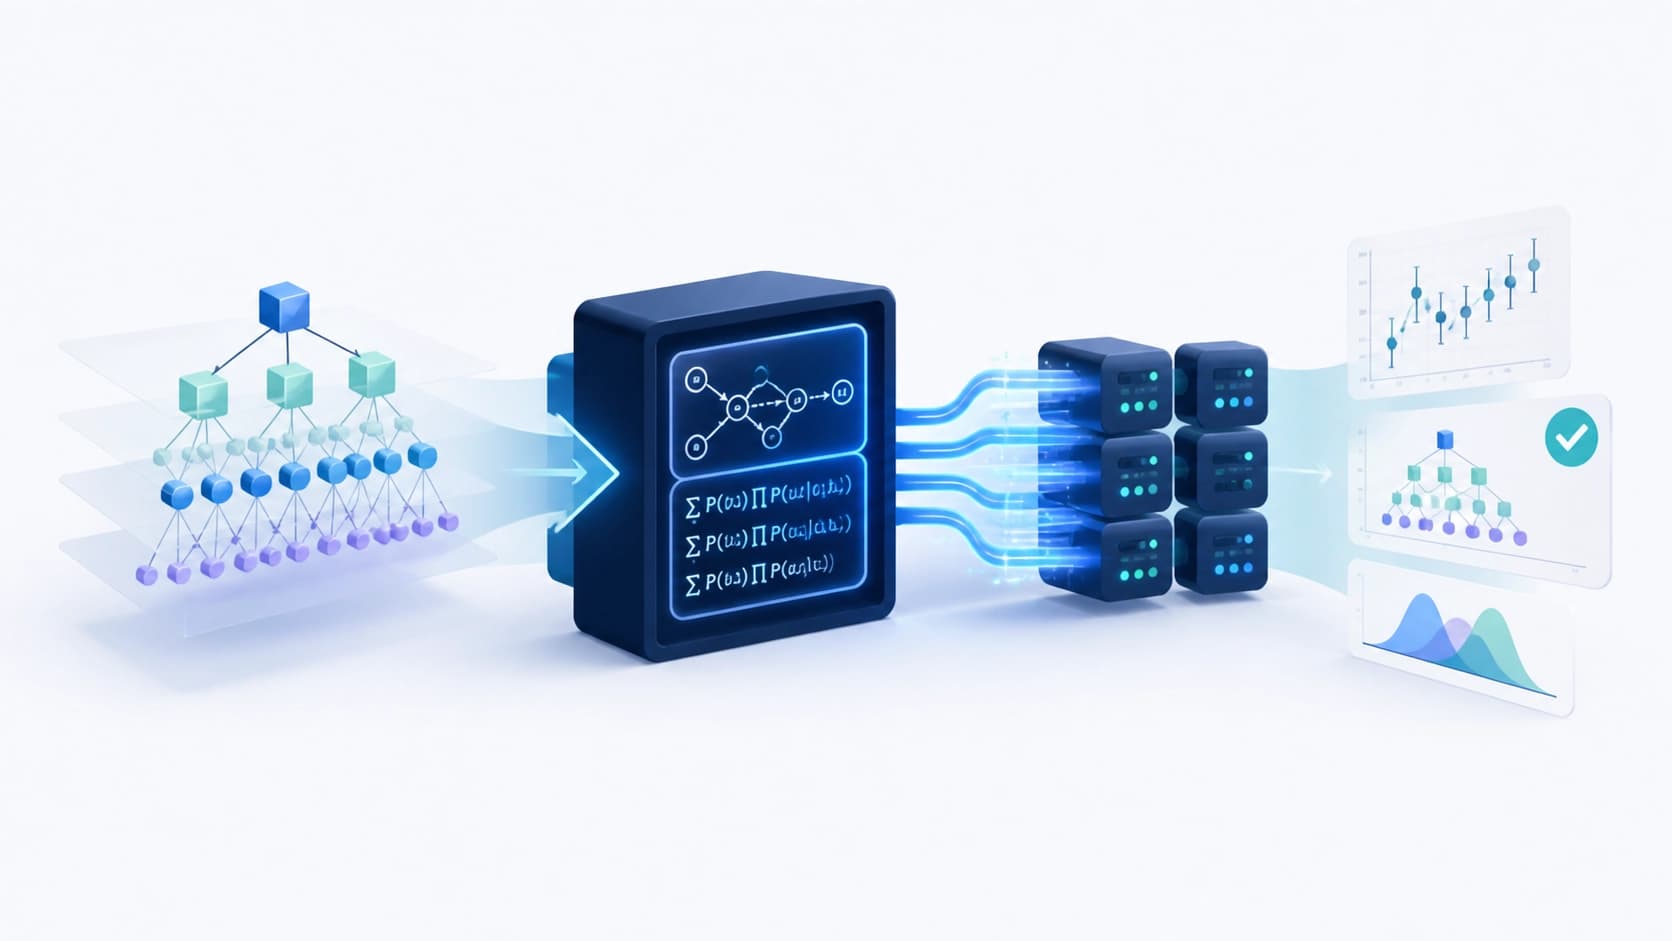
नेस्टेड डेटा और कारण-अनुमान की पुरानी समस्या
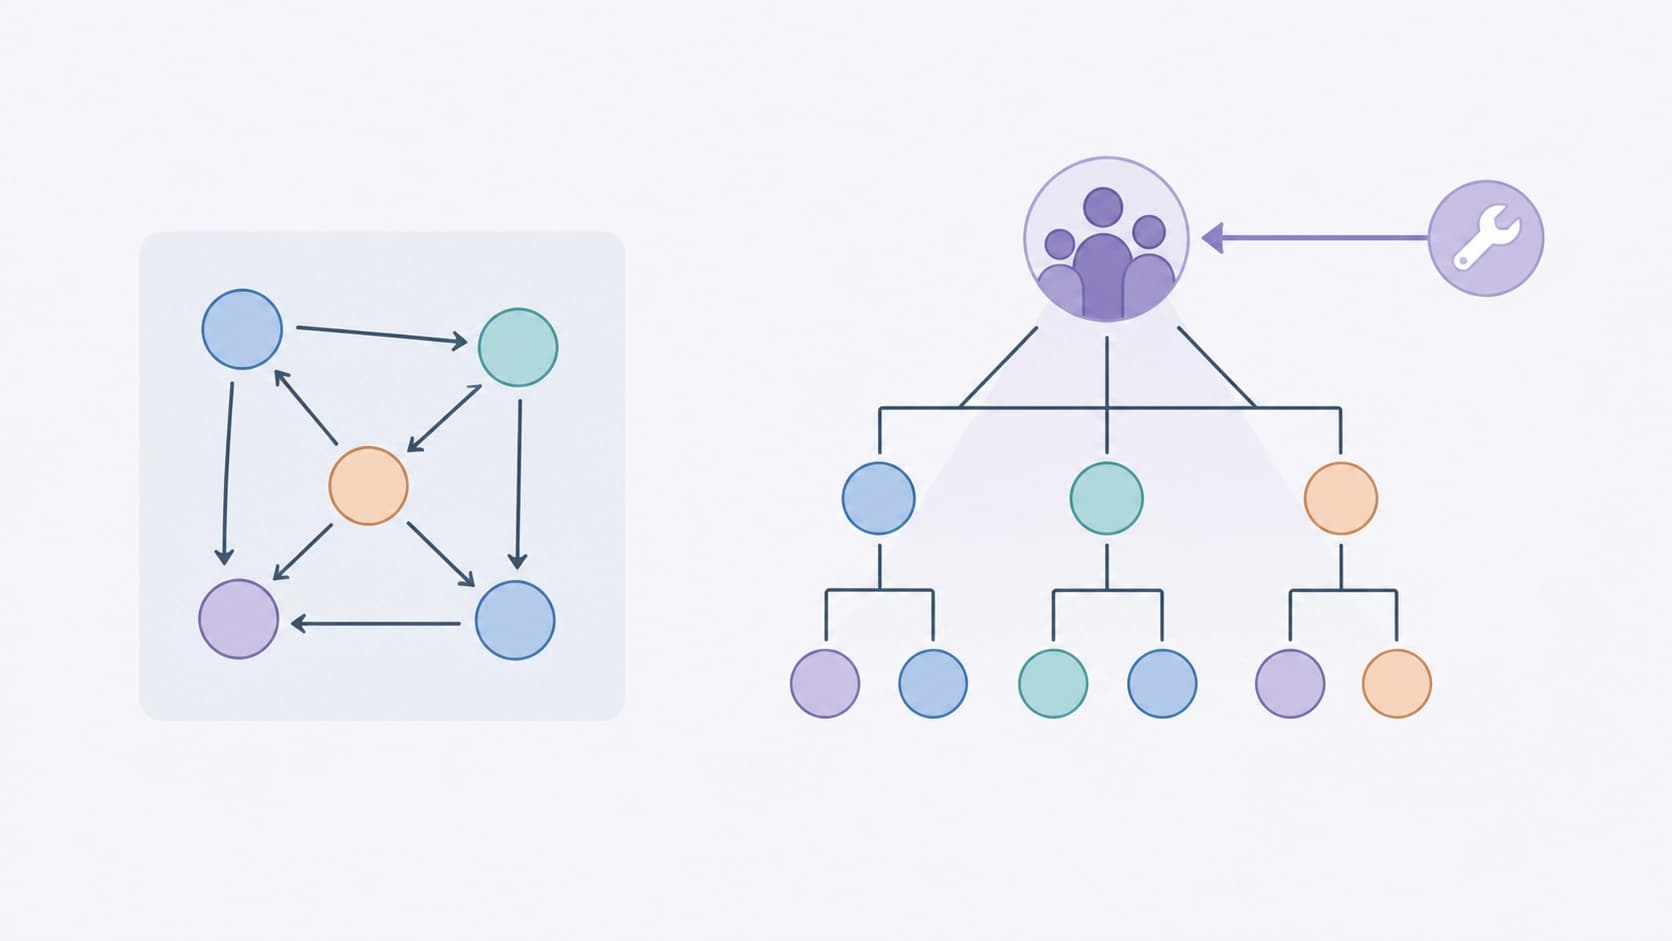
पारंपरिक कारण-अनुमान विधियाँ तब अच्छी तरह काम करती हैं जब अवलोकन एक-दूसरे से स्वतंत्र हों। लेकिन जैसे ही डेटा में पदानुक्रम आ जाता है — कक्षाओं के भीतर छात्र, क्लीनिकों के भीतर मरीज़, विभागों के भीतर कर्मचारी — सरल योजना धोखा देने लगती है। साझा समूह वस्तुओं के बीच एक सहसंबंध बना देता है, जिसे मॉडल गलती से संकेत मान लेता है, और ऊपरी स्तर पर होने वाले हस्तक्षेप (जैसे पूरी कक्षा में परिस्थितियों का बदलना) को "जोड़ने" की जगह ही नहीं मिलती।
यही इस नए arXiv प्रीप्रिंट arXiv:2608.24500 का विषय है, जो stat.ML अनुभाग में है — "Scalable and Versatile Identification for Hierarchical Structural Causal Models: A New Look at Project STAR"। यह काम 25 अगस्त 2026 को प्रकाशित हुआ, इसे नौ लेखकों के समूह ने तैयार किया — Janis Aiad, Aghiles Drali, Aymen El Ouadrhiri, Anass Ettahiri, Yasser Oufqir, Simon Patry, David Cortes, Marianne Clausel और Emilie Devijver। PDF, HTML संस्करण और TeX स्रोत उपलब्ध हैं; विषय-क्षेत्र मशीन लर्निंग और कृत्रिम बुद्धिमत्ता है।
यह सामग्री किसी एक और मॉडल के कारण नहीं, बल्कि एक पूर्ण, पुनरुत्पादनीय पाइपलाइन बनाने की कोशिश के कारण दिलचस्प है: ग्राफ के औपचारिक निरूपण से लेकर उस ठोस संख्या तक, जिसे किसी शोध-पत्र या ग्राहक के सामने रिपोर्ट में प्रस्तुत किया जा सके।
लेखक क्या प्रस्तावित करते हैं
यहाँ बात पदानुक्रमित संरचनात्मक कारण मॉडल (HSCM) के लिए एक पाइपलाइन की है। यह खुला है और इसे मापनीय (scalable) रूप में डिज़ाइन किया गया है: एक ही तर्क को छोटे शैक्षिक उदाहरण और बड़ी संख्या में समूहों वाले डेटा, दोनों को संभालना चाहिए।
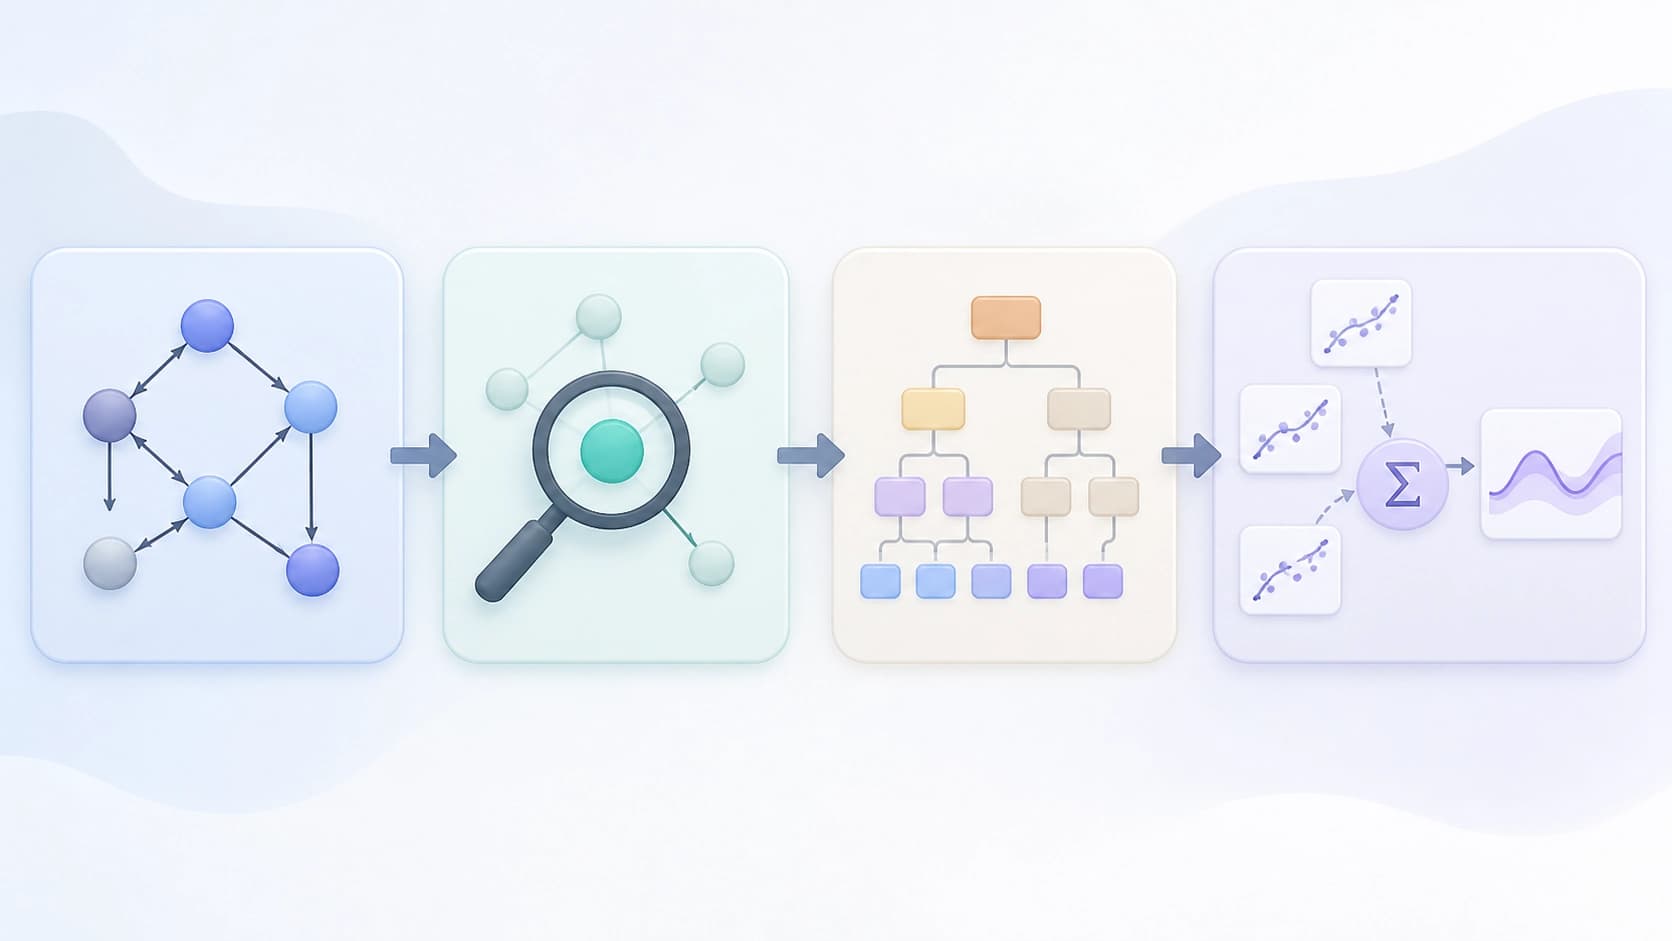
यह संरचना चार परतों से बनती है:
- ग्राफ रूपांतरण — स्तरों के बीच निर्भरताओं का वर्णन करने वाली संरचना की तैयारी;
- pyAgrum लाइब्रेरी में do-calculus के माध्यम से प्रतीकात्मक पहचान — मशीन स्वयं निर्धारित करती है कि उपलब्ध डेटा से कौन-से प्रभाव निकाले जा सकते हैं, और उसके अनुरूप व्यंजक देती है;
- इस व्यंजक का HSCM के बंद सूत्रों में रूपांतरण — प्रतीकात्मक परिणाम पदानुक्रमित मॉडल के ढाँचे में गणना-योग्य रूप में बदल जाता है;
- पहले से फिट किए गए स्थानीय प्रायिकता मॉडलों पर संख्यात्मक अनुमान।
यहाँ तर्क मूल रूप से दो-चरणीय है। पहले यह पता लगाया जाता है कि प्रभाव सिद्धांत रूप में पहचानने योग्य है या नहीं — यह गणित का प्रश्न है, डेटा का नहीं। और उसके बाद ही सांख्यिकी काम में आती है: अनुमान, त्रुटि, स्थिरता।
मापनीयता की कुंजी के रूप में अमूर्त वाक्यात्मक वृक्ष
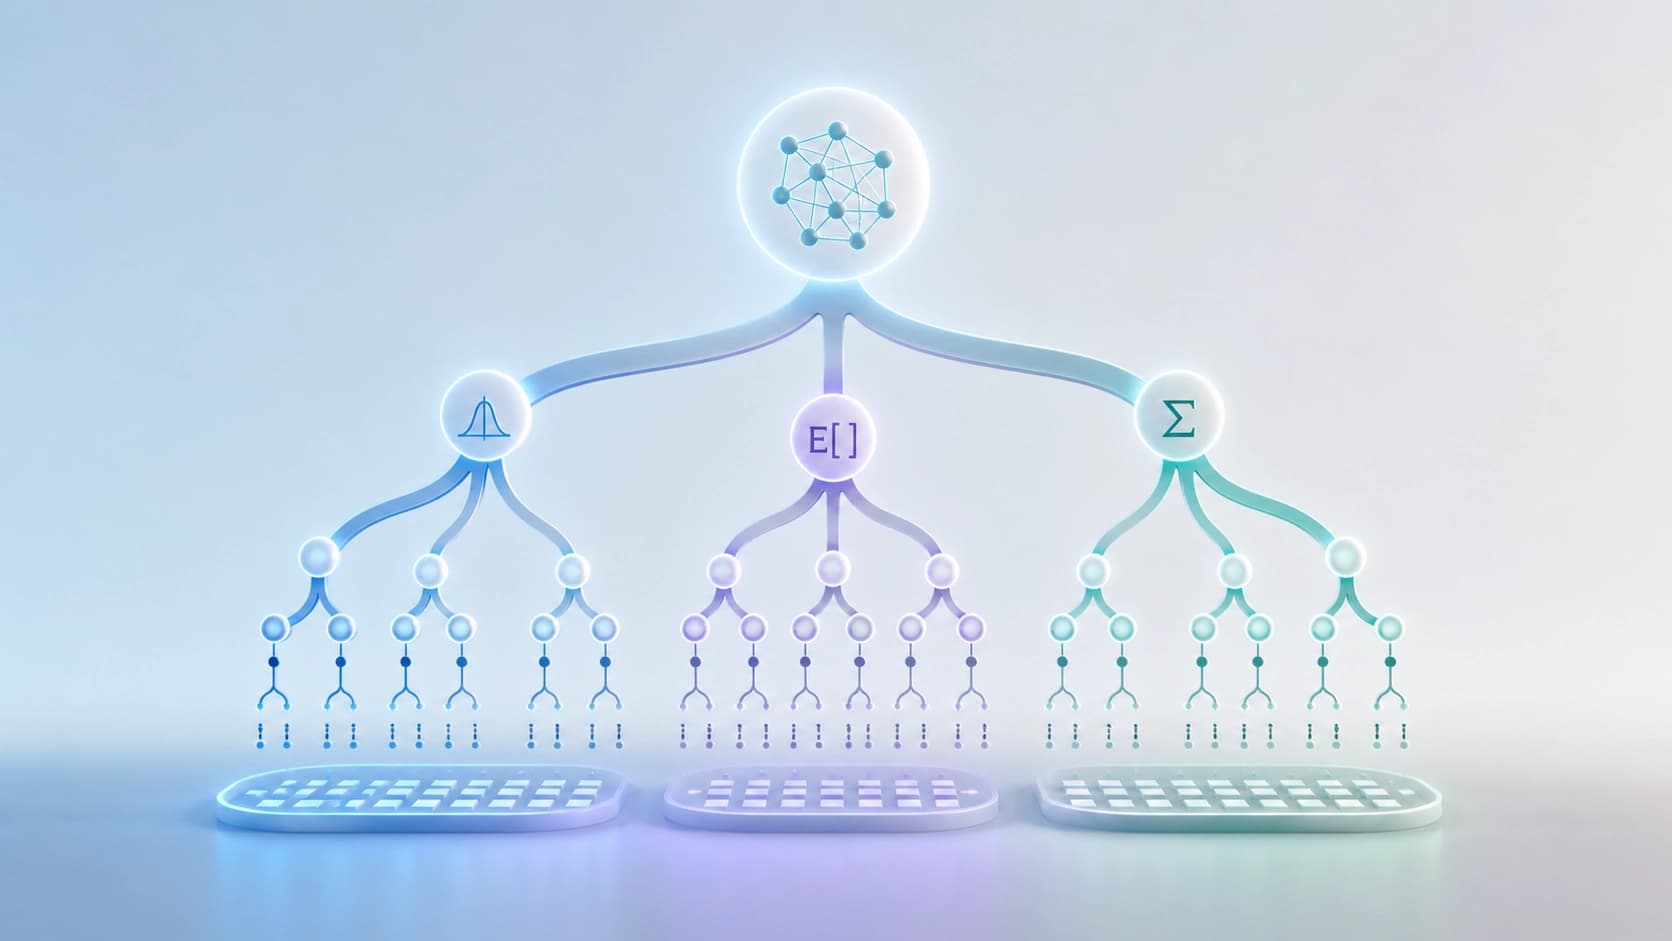
इस काम की मुख्य तकनीकी खोज एक अनुकूलित अमूर्त वाक्यात्मक वृक्ष (AST) है। pyAgrum से प्राप्त पहचाना गया सूत्र सीधे "जैसा है वैसा" परिकलित नहीं किया जाता: इसे एक वृक्ष में विघटित किया जाता है, और इस वृक्ष की पत्तियाँ तीन प्रकार के स्वतंत्र उप-कार्य बन जाती हैं — घनत्व की गणना, गणितीय अपेक्षा की गणना, और सीमांतकरण।
यह क्यों महत्वपूर्ण है? प्राप्त उप-कार्यों को समानांतर रूप से परिकलित किया जा सकता है और मध्यवर्ती परिणामों को कैश किया जा सकता है। एक भारी-भरकम व्यंजक के बजाय, जहाँ शुरुआती चरण की एक गलती आगे सब कुछ बिगाड़ देती है, स्वतंत्र टुकड़ों का एक समूह मिलता है, जिनमें से प्रत्येक की अलग से जाँच की जा सकती है। मूल रूप से, लेखक गणनात्मक क्षमता की समस्या को गणनाओं के संगठन की समस्या में बदल देते हैं।
Project STAR पर परीक्षण
एक सार्थक उदाहरण के रूप में STAR (Student-Teacher Achievement Ratio) प्रयोग लिया गया है, जो 1985 में अमेरिका के टेनेसी राज्य में किया गया था। यह एक मानक पदानुक्रमित डेटासेट है: इसे कक्षा के आकार का शैक्षणिक प्रदर्शन पर प्रभाव आँकने के लिए बनाया गया था, और इसमें अवलोकन कक्षाओं के भीतर नेस्टेड हैं। ऐसी संरचना HSCM के लिए आदर्श परीक्षण-क्षेत्र है, क्योंकि यहाँ हस्तक्षेप स्वाभाविक रूप से कक्षा के स्तर पर होता है, किसी अलग बच्चे के स्तर पर नहीं।
वास्तविक डेटा पर जाने से पहले, लेखक पाइपलाइन की जाँच HSCM के मानक प्रेरक-उदाहरणों और बेंचमार्क परिदृश्यों पर करते हैं, जहाँ सही उत्तर पहले से ज्ञात होता है। यह एक समझदार क्रम है: पहले यह सुनिश्चित करना कि विधि वहाँ सही उत्तर देती है जहाँ उत्तर ज्ञात है, और उसके बाद ही उस डेटा पर लागू करना जहाँ जाँचने का कोई साधन नहीं है। अंतिम अनुप्रयोग — STAR के ढाँचे में किंडरगार्टन में गणित के परिणाम।
परिणामों ने क्या दिखाया
निष्कर्ष विचारोत्तेजक निकले, और उनका मूल्य इसी में है।
पहला, पदानुक्रम की उपेक्षा करने वाले सपाट आधारभूत मॉडल साहचर्य तो पुनःप्राप्त कर लेते हैं — लेकिन कक्षा के स्तर पर हस्तक्षेप को कूटबद्ध करने में असमर्थ होते हैं। "छोटी कक्षा — अधिक अंक" का सहसंबंध और कक्षा घटाने का कारणात्मक प्रभाव — दो अलग बातें हैं, और पहला दूसरे का विकल्प नहीं बन सकता।
दूसरा, केवल प्रतीकात्मक पहचान पर्याप्त नहीं है। भले ही सूत्र सही ढंग से निकाला गया हो, व्यावहारिक पदानुक्रमित अनुमान के लिए एक कार्यशील संख्यात्मक परत आवश्यक है।
इससे तीसरा तर्क निकलता है: मापनीय अनुमान और संख्यात्मक स्थिरता की जाँचें विधि के लिए कोई परिशिष्ट नहीं, बल्कि उसका केंद्रीय हिस्सा हैं। एक सुंदर व्यंजक, जिसे परिकलित न किया जा सके या जो डेटा में मामूली बदलाव से ही बिखर जाए, कोई वैज्ञानिक मूल्य नहीं रखता। इसीलिए पाइपलाइन में गणनाओं के विघटन और स्थिरता-नियंत्रण पर इतना ध्यान दिया गया है।
STAR से आगे इसकी आवश्यकता क्यों है
पदानुक्रमित डेटा जितना लगता है उससे कहीं अधिक बार मिलता है। शिक्षा, चिकित्सा, क्लस्टरिंग वाले A/B परीक्षण, क्षेत्रवार जनमत सर्वेक्षण, बैचवार औद्योगिक मापन — हर जगह नेस्टिंग होती है, और हर जगह सरलता के लिए उसकी उपेक्षा करने का प्रलोभन होता है।
इस काम का मूल्य यह है कि यह कोई अलग तरकीब नहीं, बल्कि एक पुनरुत्पादनीय प्रक्रिया प्रस्तुत करता है। खुला कोड, pyAgrum के माध्यम से स्वचालित पहचान, परिकलनीय सूत्रों में औपचारिक संक्रमण, स्वतंत्र उप-कार्य — ये सब मिलकर प्रवेश-सीमा घटा देते हैं: शोधकर्ता को ग्राफ की हर नई संरचना के लिए स्वयं सूत्र निकालने की आवश्यकता नहीं रहती।
सीमाएँ और व्यावहारिक विवेक
यह ध्यान रखना चाहिए कि हमारे सामने एक प्रीप्रिंट है, समीक्षित प्रकाशन नहीं: arXiv:2608.24500 संस्करण v1 में, DOI 10.48550/arXiv.2608.24500। मानक प्रेरक-उदाहरणों और एक डेटासेट पर परिणाम — एक अच्छी जाँच है, पर सार्वभौमिक प्रमाण नहीं।
इसके अलावा, कोई भी कारण-अनुमान ग्राफ की संरचना के बारे में मान्यताओं पर टिका होता है। पाइपलाइन गणनाओं को स्वचालित और अधिक पारदर्शी बनाती है, लेकिन इस प्रश्न को समाप्त नहीं करती कि "क्या हमने दुनिया का वर्णन ही सही ढंग से किया है"। यदि ग्राफ गलत है, तो सावधानी से परिकलित प्रभाव भी सावधानी से परिकलित भ्रम ही रहेगा।
इसीलिए लेख का मुख्य व्यावहारिक निष्कर्ष बहुत ज़मीनी लगता है: अनुमान के बिना पहचान निरर्थक है, स्थिरता के बिना अनुमान जोखिमभरा है, और नेस्टेड डेटा के लिए मॉडल में एक अलग स्तर आवश्यक है, अन्यथा समूह-स्तरीय हस्तक्षेपों को जोड़ने के लिए कुछ भी नहीं बचता।


