
भीड़ की बुद्धिमत्ता एकरूपता से टकराती है
जब भविष्य के बारे में कुछ भविष्यवाणी करनी हो — बाज़ार का व्यवहार, किसी घटना का परिणाम, किसी तकनीक का भाग्य — तो एक सरल विचार मन में आता है: जितने अधिक मॉडलों से पूछेंगे, उत्तर उतना ही विश्वसनीय होगा। तर्क काफ़ी मज़बूत लगता है: अलग-अलग सिस्टम अलग-अलग तरह से गलतियाँ करते हैं, यानी औसत निकालने से यादृच्छिक चूकें दूर हो जाएँगी।
लेकिन इस योजना में एक छिपी हुई समस्या है। अगर "भीड़" के सभी सदस्य एक जैसे तरीके से सोचते हैं, तो उनके मत स्वतंत्र प्रमाण नहीं, बल्कि एक ही राय की नकल करके बढ़ाई गई प्रतियाँ हैं। दस लगभग एक जैसे उत्तर एक उत्तर की तुलना में कोई जानकारी नहीं जोड़ते; वे केवल आत्मविश्वास का एहसास पैदा करते हैं और इन्फ़रेंस का बिल बढ़ाते हैं।
यही समस्या "Diverse by Reasoning: Harnessing the Wisdom of LLM Crowds for Future Prediction" नामक शोध-पत्र का केंद्र है — इसे निरुपम चेटलापल्ली, यिमिन लियाओ, मिन-चुन चेन और केके चेन ने तैयार किया है। प्रीप्रिंट arXiv:2608.24001 25 अगस्त 2026 को आया, अगले ही दिन एक संशोधित संस्करण प्रकाशित हुआ, और यह लेख स्वयं IEEE BigData 2026 में प्रस्तुत किया गया है।
सिर्फ़ "और अधिक मॉडल" समस्या का समाधान नहीं है
लेखकों का मुख्य अवलोकन यह है: अलग-अलग बड़े भाषा मॉडल अत्यधिक समान व्यवहार कर सकते हैं। वे तुलनीय डेटा पर प्रशिक्षित होते हैं, समान शब्दावली और सोच के सामान्य तरीकों की ओर झुकते हैं। नतीजतन, प्रतिभागियों की सूची को यांत्रिक रूप से बढ़ाना वह विविधता नहीं देता जिसके लिए यह सब शुरू किया गया था।
यहाँ दो अवधारणाओं को अलग करना ज़रूरी है। मात्रा — यह कि हम कितने मॉडलों से पूछते हैं। विविधता — यह कि वे कितने अलग-अलग तरीकों से निष्कर्षों तक पहुँचते हैं। दूसरी बात पहली से अपने आप नहीं निकलती: आप बीस प्रतिभागी जुटा सकते हैं और एक ही विचार की बीस विविधताएँ पा सकते हैं।
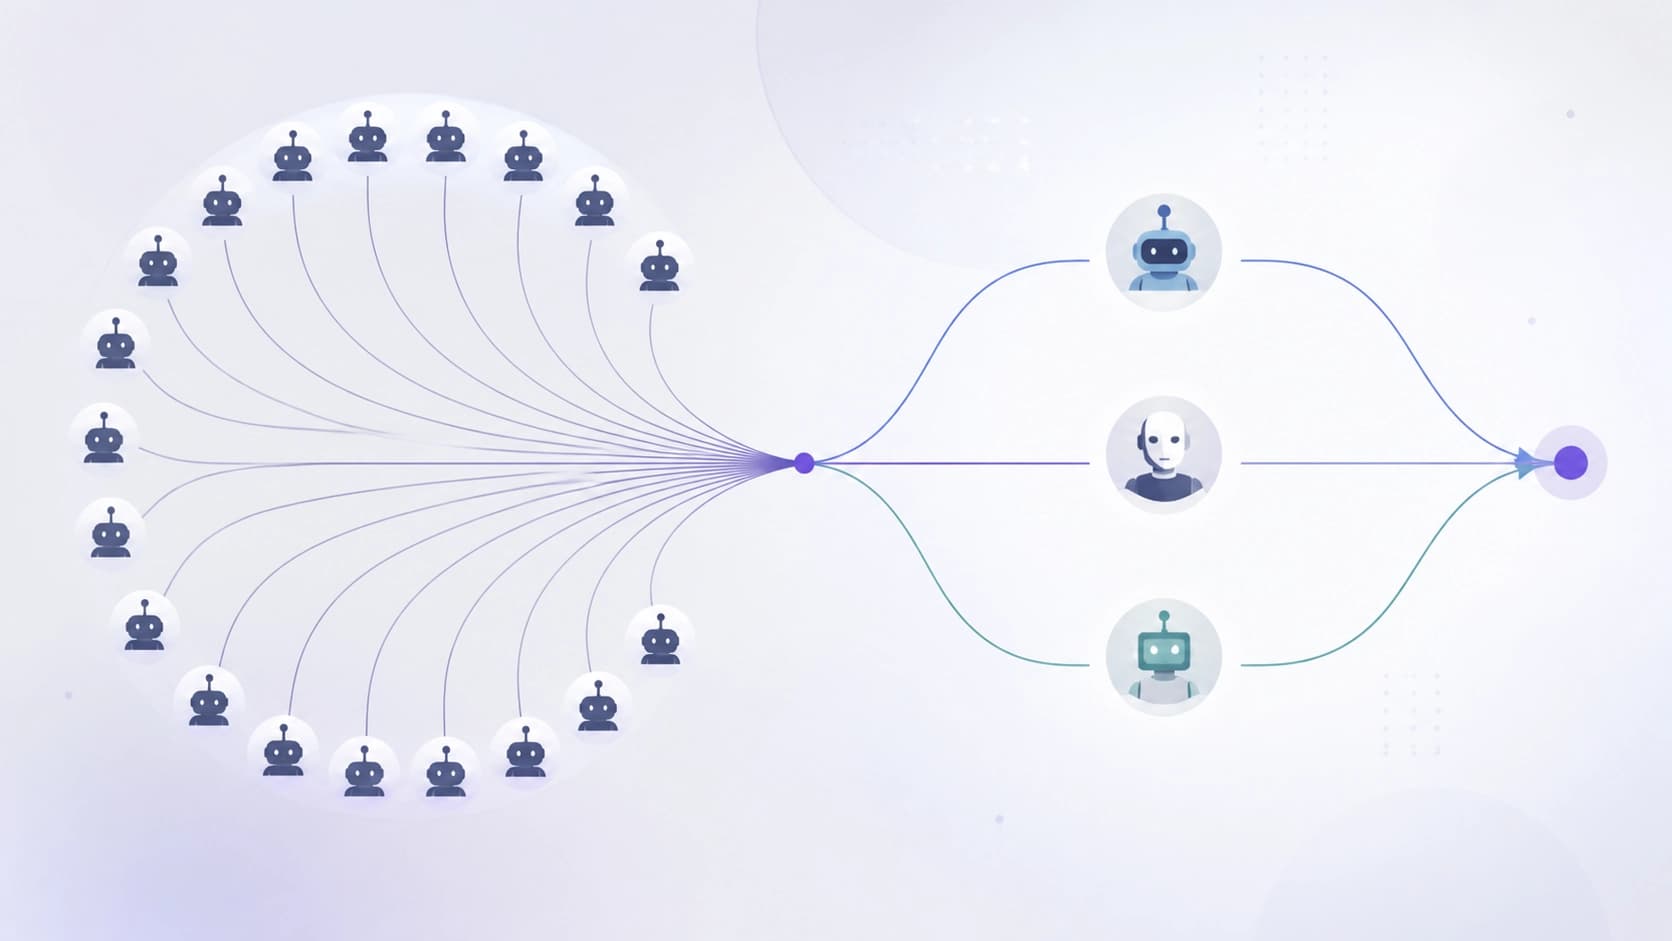
तरीका: मॉडलों का चयन उत्तरों के आधार पर नहीं, सोच की शैली के आधार पर
व्यवहार-आधारित चयन कैसा दिखता है
लेखक एक ढाँचा प्रस्तावित करते हैं, जिसे वे व्यवहार-केंद्रित कहते हैं। मूल बात यह नहीं है कि मॉडलों की तुलना अंतिम उत्तरों की सटीकता पर की जाए, बल्कि यह समझा जाए कि वे कैसे सोचते हैं।
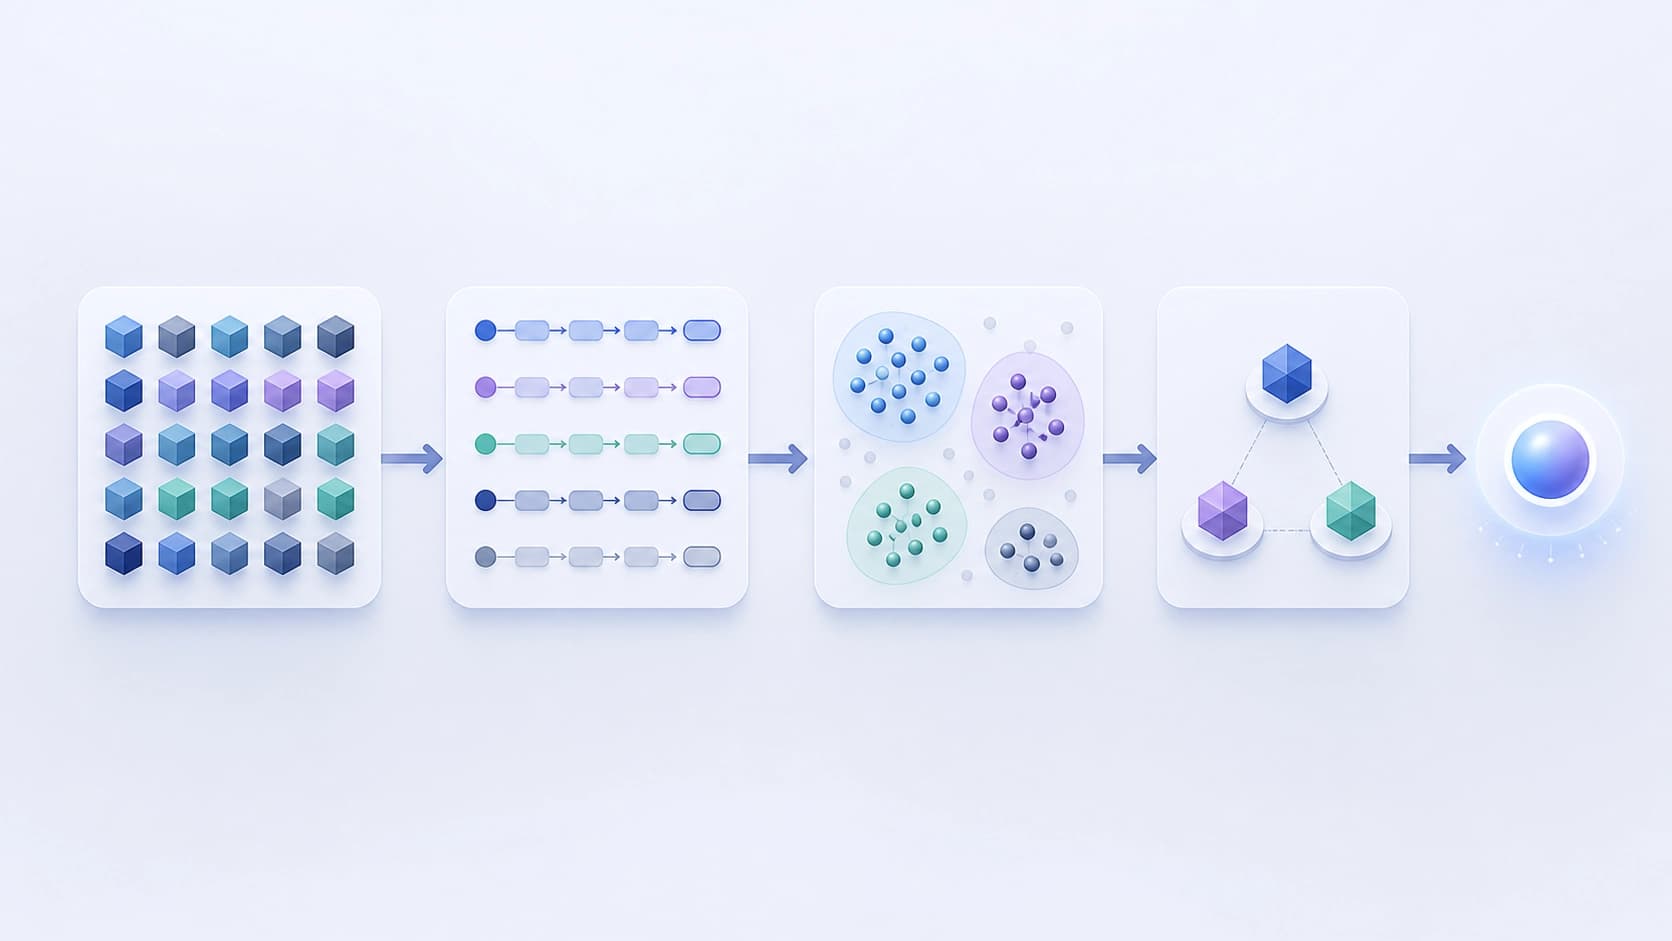
योजना इस प्रकार है:
- प्रत्येक मॉडल को स्वतंत्र कार्यों के एक समूह पर चलाया जाता है, जिनका भविष्य की भविष्यवाणी से कोई संबंध नहीं है। उत्तरों से अधिक, सोच की शृंखलाएँ — यानी वही reasoning traces — एकत्र की जाती हैं।
- इन निशानों के आधार पर एक व्यवहारिक प्रोफ़ाइल बनाई जाती है: मॉडल कौन-से कदम उठाता है, कार्य को कैसे बाँटता है, कहाँ गलती करता है, किन तर्कों का सहारा लेता है।
- मॉडलों को व्यवहार की समानता के आधार पर समूहों में बाँटा जाता है। इसके लिए K-means++ एल्गोरिदम का उपयोग किया जाता है।
- प्रत्येक समूह से एक प्रतिनिधि लिया जाता है — एक मेडॉइड, यानी वह मॉडल जो अपने समूह के लिए सबसे विशिष्ट है।
- यही छोटी "भीड़" मेडॉइड्स का सामूहिक पूर्वानुमान निकालती है।
अगर गहराई से सोचें तो यह विचार नया नहीं है — सांख्यिकी में ऐसा ही किया जाता है, जब सहसंबद्ध विशेषताओं में से एक-एक प्रतिनिधि रखा जाता है ताकि एक ही जानकारी दोहराई न जाए। यहाँ नयापन यह है कि "विशेषता" भाषा मॉडल की सोचने की शैली बन जाती है, कोई संख्यात्मक लक्षण नहीं।
किस पर परीक्षण किया गया
प्रयोग 25 मॉडलों पर आधारित है। सात विकास बेंचमार्क का उपयोग मॉडलों को व्यवहार के आधार पर वर्णित करने और अलग करने के लिए किया गया, और दो अलग बेंचमार्क — भविष्य की भविष्यवाणी के लिए — तैयार हुई "भीड़ों" की गुणवत्ता आँकने के लिए। यह विभाजन मूलभूत है: जिन कार्यों पर प्रोफ़ाइल बनाई जाती है, वे उन कार्यों से मेल नहीं खाते जिन पर परिणाम गिना जाता है। अन्यथा यह छिपकर सीखना होता, और आँकड़ों का कोई मतलब नहीं होता।
परिणाम: तीन मॉडल पच्चीस को पीछे छोड़ देते हैं
शोध-पत्र में सबसे चर्चित बात तुलना का नतीजा है। व्यवहारिक क्लस्टरिंग के ज़रिए बनी केवल तीन मेडॉइड मॉडलों की "भीड़" ने सभी 25 मॉडलों पर सामान्य मतदान से बेहतर प्रदर्शन किया। और यह दोनों पूर्वानुमान बेंचमार्कों के लिए सच है।
साथ ही बचत प्रभावशाली रही: मॉडलों को कॉल करने की संख्या 88% कम हो गई, और इन्फ़रेंस का खर्च लगभग 80%। व्यवहार में यह सटीकता में वृद्धि से भी शायद अधिक महत्वपूर्ण है। पूर्वानुमान प्रणालियाँ अक्सर उत्तर की गुणवत्ता पर नहीं, बल्कि उसकी कीमत पर अटकती हैं: अगर हर प्रश्न के लिए दो दर्जन मॉडलों से पूछना पड़े, तो समाधान सटीकता खोने से बहुत पहले लाभहीन हो जाता है।
इससे एक गैर-स्पष्ट निष्कर्ष निकलता है: "भीड़" की संरचना उसके आकार से अधिक मायने रखती है। पच्चीस मॉडल तीन पर स्वतः बढ़त नहीं हैं, अगर वे पच्चीस मूल रूप से एक-दूसरे को दोहराते हैं।
हर विविधता समान रूप से उपयोगी नहीं होती
लेखक एक और सूक्ष्म निष्कर्ष निकालते हैं, जिसे चूकना आसान है। पता चलता है कि महत्वपूर्ण विविधता को अधिकतम करना नहीं है, बल्कि प्रतिनिधित्व है — यह कि चुने गए प्रतिभागी मॉडलों के बीच मौजूद व्यवहार के विभिन्न ध्रुवों को कितना दर्शाते हैं।
अंतर मूलभूत है। आप तीन मॉडल चुन सकते हैं जो संयोगवश और छोटी-छोटी बातों में एक-दूसरे से भिन्न हैं — और संकेत के बजाय शोर पा सकते हैं। या आप वास्तव में अलग व्यवहारिक समूहों में से एक-एक चुन सकते हैं — और एक संक्षिप्त समूह पा सकते हैं जो समाधान-स्थान को कवर करता है। पहला है विविधतापूर्ण बिखराव, दूसरा है विषमरूपता। काम दूसरा करता है।
यहाँ सामान्य विशेषज्ञता से समानता दिखती है। अच्छा आयोग वह नहीं है जहाँ अधिक लोग हों, बल्कि वह है जहाँ अलग-अलग दृष्टिकोण और दृष्टिकोण प्रस्तुत हों। अलग-अलग क्षेत्रों के पाँच विशेषज्ञ आमतौर पर एक ही विभाग के पंद्रह स्नातकों से अधिक उपयोगी होते हैं।
व्यवहार में इसका क्या अर्थ है
जो लोग भाषा मॉडलों पर पूर्वानुमान सेवाएँ बनाते हैं, उनके लिए लेख के निष्कर्ष काफ़ी ठोस नुस्खा देते हैं:
- मॉडलों की सूची की लंबाई के पीछे न भागें। व्यवहार का विश्लेषण किए बिना पूल बढ़ाना — डुप्लिकेट उत्तरों के लिए भुगतान करना है।
- पहले व्यवहार मापें, फिर संरचना चुनें। असंबंधित कार्यों पर चलाना और क्लस्टरिंग यह स्पष्ट तस्वीर देते हैं कि समूह में वास्तव में कौन अलग है।
- सचेत रूप से बचत करें। सटीकता बनाए रखते हुए या सुधारते हुए कॉल की संख्या में परिमाण का कमी उत्पाद की अर्थव्यवस्था बदल देती है, केवल उसकी तकनीकी विशेषताएँ नहीं।
- सीमाओं को याद रखें। यह सब 25 मॉडलों के एक विशिष्ट समूह और दो पूर्वानुमान बेंचमार्कों पर परखा गया है; आँकड़ों को ज्यों का त्यों अन्य डोमेन और अन्य मॉडलों पर लागू करना उचित नहीं है।
लेख का मुख्य विचार लगभग मानवीय लगता है: सामूहिक राय का मूल्य मतों की संख्या पर नहीं, बल्कि इस पर टिका है कि वे मत वास्तव में अलग हैं। भाषा मॉडलों के संदर्भ में इसका अर्थ है कि मापना नामों की सूची नहीं, बल्कि सोचने की शैली है — और उसी के आधार पर टीम जुटानी चाहिए।


