दो संख्याएँ आमतौर पर स्वचालित मूल्यांकन की गुणवत्ता की रिपोर्ट में शामिल होती हैं: मॉडल के निर्णय मानवीय निर्णयों से कितने मेल खाते हैं और वे विकल्पों के क्रम बदलने या प्रॉम्प्ट के पुनर्सूत्रीकरण जैसे छोटे बदलावों के प्रति कितने स्थिर हैं। एक नया शोध कार्य दावा करता है कि यह पर्याप्त नहीं है — और निर्णायक को एक अलग नज़र से देखने का सुझाव देता है।
सहमति उस प्रश्न का उत्तर नहीं देती जो ज़रूरी है
सहमति और सतही गड़बड़ियों के प्रति स्थिरता — ये विश्वसनीयता (reliability) के बारे में हैं। एक विश्वसनीय मापन उपकरण स्थिर परिणाम देता है, लेकिन स्थिरता अपने आप में यह नहीं बताती कि वह सही मात्रा माप रहा है या नहीं। एक थर्मामीटर जो हमेशा 20 डिग्री दिखाता है, बेहद विश्वसनीय है और पूरी तरह बेकार है।
«A Judge Should Know What Changed: Construct Validity for LLM-as-a-Judge Evaluation» (Jianlin Chen, Wenhui Chen, Ziyao Lin, Chi Man Vong; arXiv:2608.24419, cs.AI, 25 अगस्त 2026 को प्रस्तुत; 39 पृष्ठ, 10 चित्र, 11 तालिकाएँ) शीर्षक वाले पेपर के लेखक बातचीत को कंस्ट्रक्ट वैधता के स्तर पर ले जाते हैं: क्या मूल्यांकन उस अवधारणा से मेल खाता है जिसे वह मापने का दावा करता है। LLM-निर्णायक के लिए इसका सीधा अर्थ है — निर्णायक को अर्थ पर प्रतिक्रिया देनी चाहिए, रूप पर नहीं।
दो आयामों का प्रोफ़ाइल
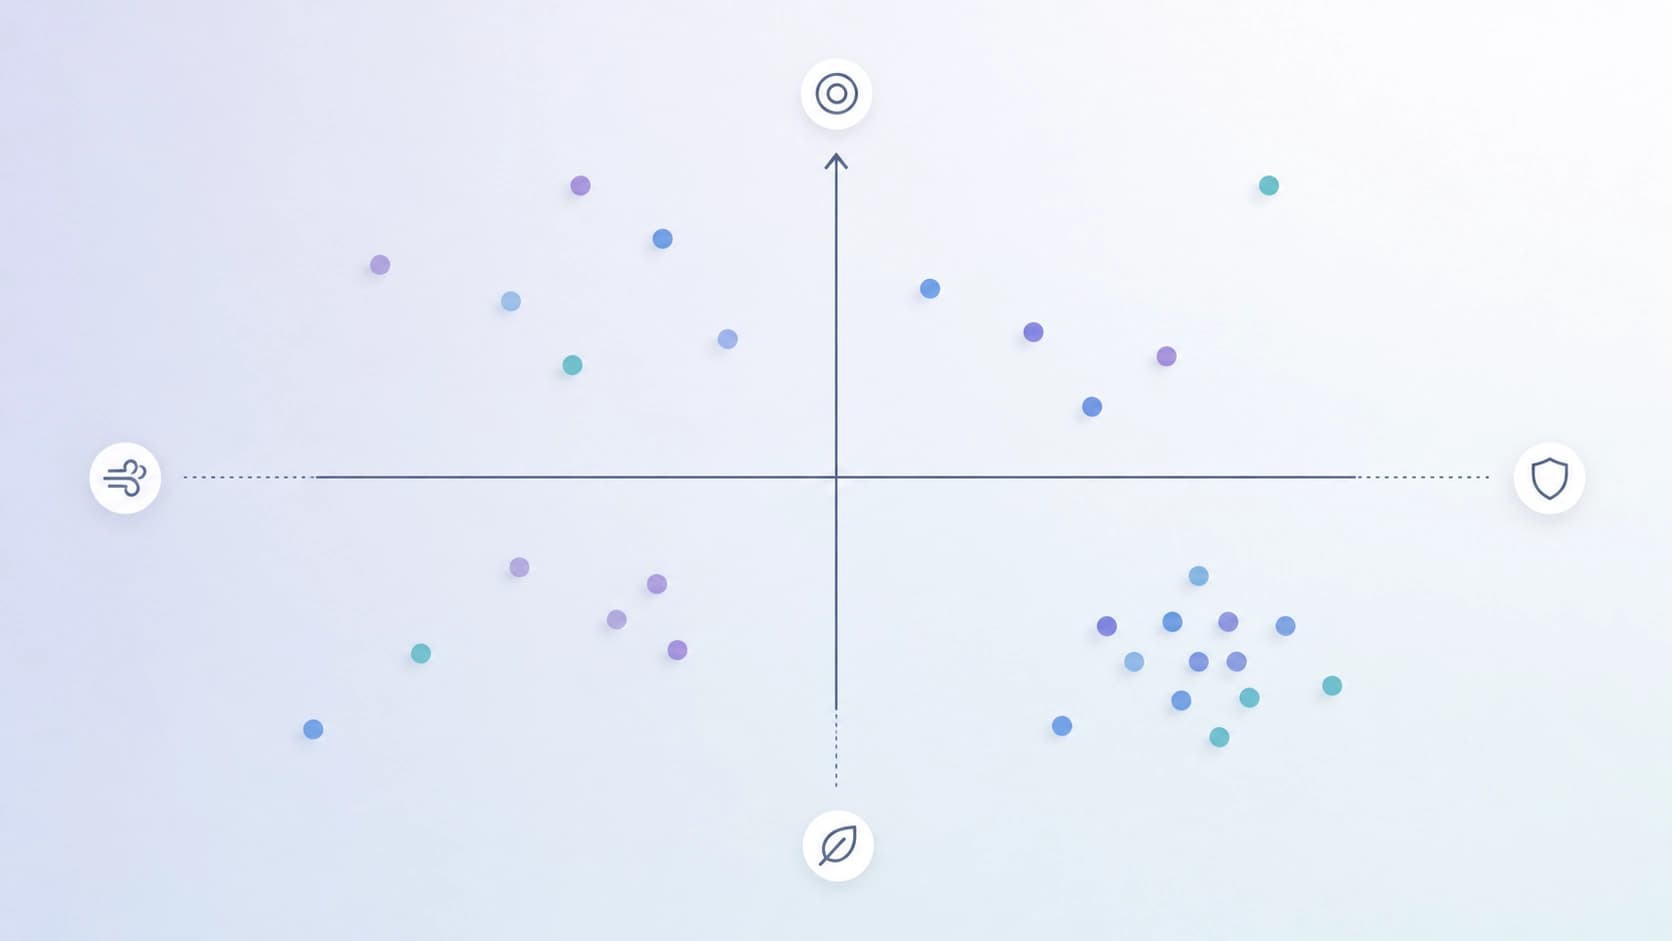
एक मीट्रिक के बजाय दो प्रायिकताओं का प्रोफ़ाइल प्रस्तावित है।
S — अपरिवर्तनीयता। यदि संपादन अर्थ को बनाए रखता है तो निर्णय कितनी बार वही रहता है: अनुच्छेदों का क्रम बदला, शैली बदली, अनावश्यक शब्द हटाए। एक अच्छे निर्णायक को यहाँ विचलित नहीं होना चाहिए।
R — कंस्ट्रक्ट संवेदनशीलता। यदि संपादन न्यूनतम है लेकिन अर्थ प्रभावित होता है तो निर्णय कितनी बार बदलता है: एक शर्त जोड़ी, दावा कमज़ोर किया, दायरा संकुचित किया। एक अच्छे निर्णायक को यहाँ प्रतिक्रिया देनी ही चाहिए।
पेपर का मुख्य दावा: S और R स्वतंत्र हैं, और कोई भी अदिश सारांश सभी प्रासंगिक तुलनाओं को संरक्षित नहीं करता। सरल शब्दों में, दो संख्याओं का औसत निकालकर एक ईमानदार संख्या नहीं पाई जा सकती — उच्च S और निम्न R वाला निर्णायक और निम्न S और उच्च R वाला निर्णायक समान «औसत स्कोर» दे सकते हैं, फिर भी मूल रूप से भिन्न उपकरण बने रहते हैं।
इसकी जाँच कैसे की गई
प्रायोगिक रचना ऐसे कार्यों के लिए सामान्य से कहीं अधिक कठोर है।
- 7 निर्णायक और 4 डोमेन — यानी जाँच एक मॉडल पर और एक प्रकार के कार्य पर नहीं की गई।
- 7 प्रकार के कंस्ट्रक्ट-परिवर्तक हस्तक्षेप बनाम 5 नियंत्रण, जो केवल शैली को छूते हैं और अर्थ नहीं बदलते।
- संपादन की दिशा — यह कंस्ट्रक्ट बदलता है या नहीं — मानव एनोटेटरों ने निर्धारित की, न कि डिफ़ॉल्ट लेबलिंग से।
- जनरेशन, सत्यापन और निर्णायकता गैर-अतिव्यापी मॉडल परिवारों को सौंपी गई थीं। यह एक महत्वपूर्ण ब्यौरा है: निर्णायक उस टेक्स्ट का मूल्यांकन नहीं करता जो उसने खुद बनाया, और न ही उन संपादनों की जाँच करता है जो उसने खुद सुझाए।
अंतिम बिंदु पर अलग से ध्यान देना चाहिए। जब जनरेटर, सत्यापनकर्ता और निर्णायक एक ही मॉडल हों, तो उच्च सहमति साझा पूर्वाग्रहों का परिणाम हो सकती है, गुणवत्ता का संकेत नहीं।
अपरिवर्तनीयता लगभग आदर्श है, संवेदनशीलता नहीं
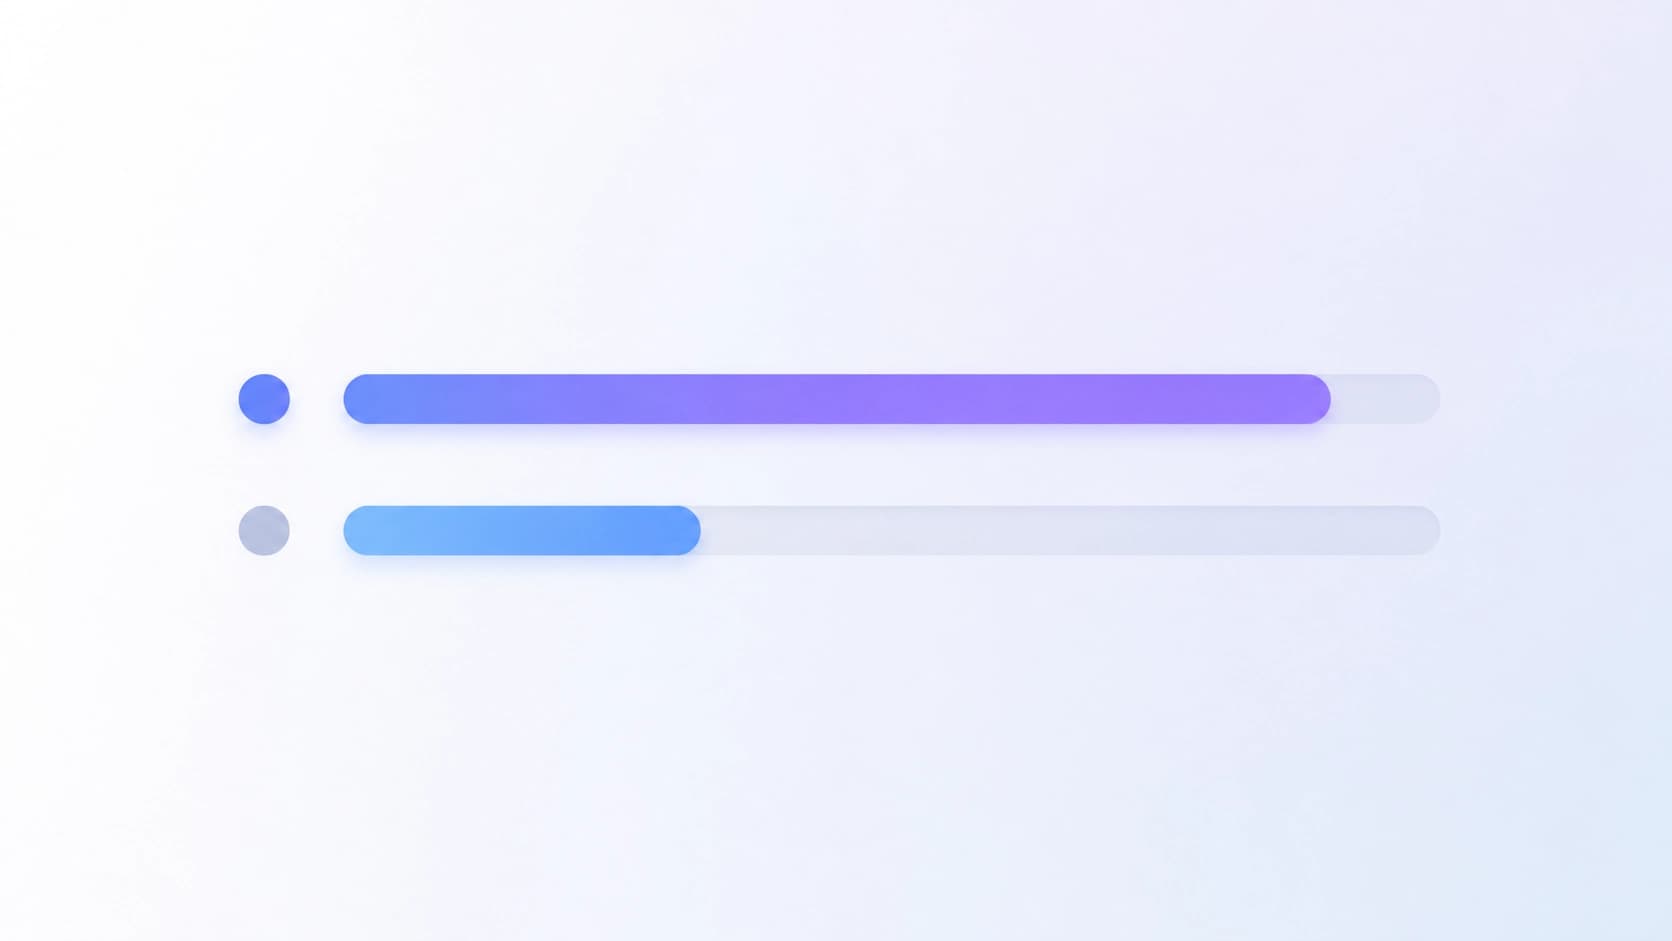
यहीं सबसे दिलचस्प बात शुरू होती है। सहमत अपरिवर्तनीयता की सीमा S ≥ 0.90 पर, निर्णायकों ने औसतन S = 0.945 दिखाया। वह संख्या जिसकी ओर आमतौर पर रिपोर्टिंग में लक्ष्य रखा जाता है।
संवेदनशीलता हालाँकि — R = 0.319। मोटा अनुमान: लगभग तीन में से दो मामलों में निर्णायक ने वह संपादन नहीं पकड़ा जो अर्थ बदलता है। औपचारिक रूप से निर्दोष अपरिवर्तनीयता परिणाम सामग्री के प्रति बहुत कमज़ोर प्रतिक्रिया के साथ सह-अस्तित्व में है।
पैमाना और शक्ति — एक चीज़ नहीं हैं
कमज़ोर संवेदनशीलता असमान रूप से वितरित है। जब संपादन दावे का पैमाना बदलता है, तो प्रतिक्रिया अधिक होती है: R_scope = 0.383। जब वह शक्ति बदलता है — कमज़ोर: R_strength = 0.262। अंतर +0.121 है, और इसका चिह्न सभी सात निर्णायकों के लिए समान है।
यानी यह मॉडलों के बीच यादृच्छिक विचरण नहीं, बल्कि एक व्यवस्थित विशेषता है। निर्णायक दायरे के विस्तार और संकुचन को विश्वास के पैमाने पर बदलाव की तुलना में बेहतर पढ़ते हैं — «संभवतः» बनाम «निश्चित रूप से», «मदद कर सकता है» बनाम «मदद करता है»। व्यवहार के लिए यह अप्रिय समाचार है: यही ऐसी श्रेणियाँ हैं जिन्हें अक्सर अलग करने की ज़रूरत होती है।
मानवीय लेबलों की भी जाँच होनी चाहिए
एक अलग कहानी — पाँच सार्वजनिक लेबल सेट, जो मानक के रूप में उपयोग किए जाते हैं। केवल टेक्स्ट के सतही लक्षणों पर निर्भर प्रेडिक्टर, युग्म मोड में 55–67% लेबल पुनरुत्पादित करते हैं। MT-Bench के मामले में सतही अनुमान 67.4% मानवीय मतों से मेल खाया।
निष्कर्ष असुविधाजनक है। यदि एक सरल नियम, जो सामग्री के बारे में कुछ नहीं समझता, दो-तिहाई मानवीय निर्णयों को दोहराता है, तो ऐसे लेबल अर्थ को रूप से ठीक से अलग नहीं करते — और केवल निर्णायक को ही नहीं, बल्कि उस सेट को भी मान्य करना चाहिए जिस पर उसकी जाँच होती है।
इसका क्या करें
लेखक LLM-निर्णायकों को किसी और चीज़ से बदलने का सुझाव नहीं देते — वे रिपोर्टिंग और जाँच प्रक्रिया बदलने का सुझाव देते हैं।
संयुक्त रिपोर्टिंग। S और R साथ-साथ प्रकाशित हों, एक संख्या में समेटे न जाएँ। रिपोर्ट पढ़ने वाला तुरंत देख लेता है कि निर्णायक कहाँ चूक रहा है।
वैलिडेशन सेट का ऑडिट। मानवीय लेबलों से सहमति पर भरोसा करने से पहले, यह जाँचना चाहिए कि ये लेबल टेक्स्ट को समझे बिना कितने पूर्वानुमेय हैं। यदि वे अच्छी तरह पूर्वानुमेय हैं — तो उन पर भरोसा अत्यधिक है।
भूमिकाओं का पृथक्करण। जनरेशन, सत्यापन और निर्णायकता अलग-अलग मॉडल परिवारों में होने से यह जोखिम कम होता है कि उच्च अपरिवर्तनीयता साझा अंधे धब्बों का परिणाम हो।
मुख्य विचार
उच्च सहमति स्थिरता के बारे में है, सहीपन के बारे में नहीं। जो निर्णायक अर्थपूर्ण संपादन से पहले और बाद में समान आत्मविश्वास से निर्णय देता है, वह «स्थिर» नहीं, बल्कि असावधान है। जब तक रिपोर्टों में केवल एक संख्या होती है, इन दो स्थितियों में अंतर करना असंभव है — और इसीलिए दो आयामों का प्रोफ़ाइल उलझाव नहीं, बल्कि न्यूनतम आवश्यक ईमानदारी लगता है।