
क्यों "दिखाओ कि यह कहाँ है" — गलत सवाल है
क्लासिक विज़ुअल ग्राउंडिंग टेस्ट लगभग स्कूल जैसा दिखता है: एक तस्वीर दी जाती है और "नीचे की शेल्फ पर नीली फ़ाइल" जैसा वाक्यांश, और मॉडल को बताना होता है कि मनचाही वस्तु कहाँ है। एक क्वेरी, एक जवाब, मेट्रिक — सही लगा या नहीं।
यह ढाँचा सुविधाजनक है, लेकिन यह बातचीत नहीं, बल्कि एक आदेश का वर्णन करता है। जीवंत संवाद में इंसान शायद ही पहली बार में पूरी तस्वीर पेश करता है। वह कहता है "अरे वो चीज़ खिड़की के पास वाली" और उम्मीद करता है कि सामने वाला या तो समझ जाएगा, या फिर पूछ लेगा। आपसी समझ बातचीत के दौरान बनती जाती है — कभी दो चक्करों में, कभी पाँच में।
arXiv:2608.23978 (Zhengxiang Wang और Owen Rambow, पेपर EMNLP 2026 में स्वीकृत) के लेखक इसी छूटे हुए चरण को मापने का विषय मानते हैं। उनका सवाल यह है: क्या मॉडल सिर्फ़ देखना ही नहीं, बल्कि पूछना भी जानता है, जब तस्वीरें और शब्द एक स्पष्ट निष्कर्ष के लिए काफ़ी न हों।
प्रयोग कैसे बनाया गया है
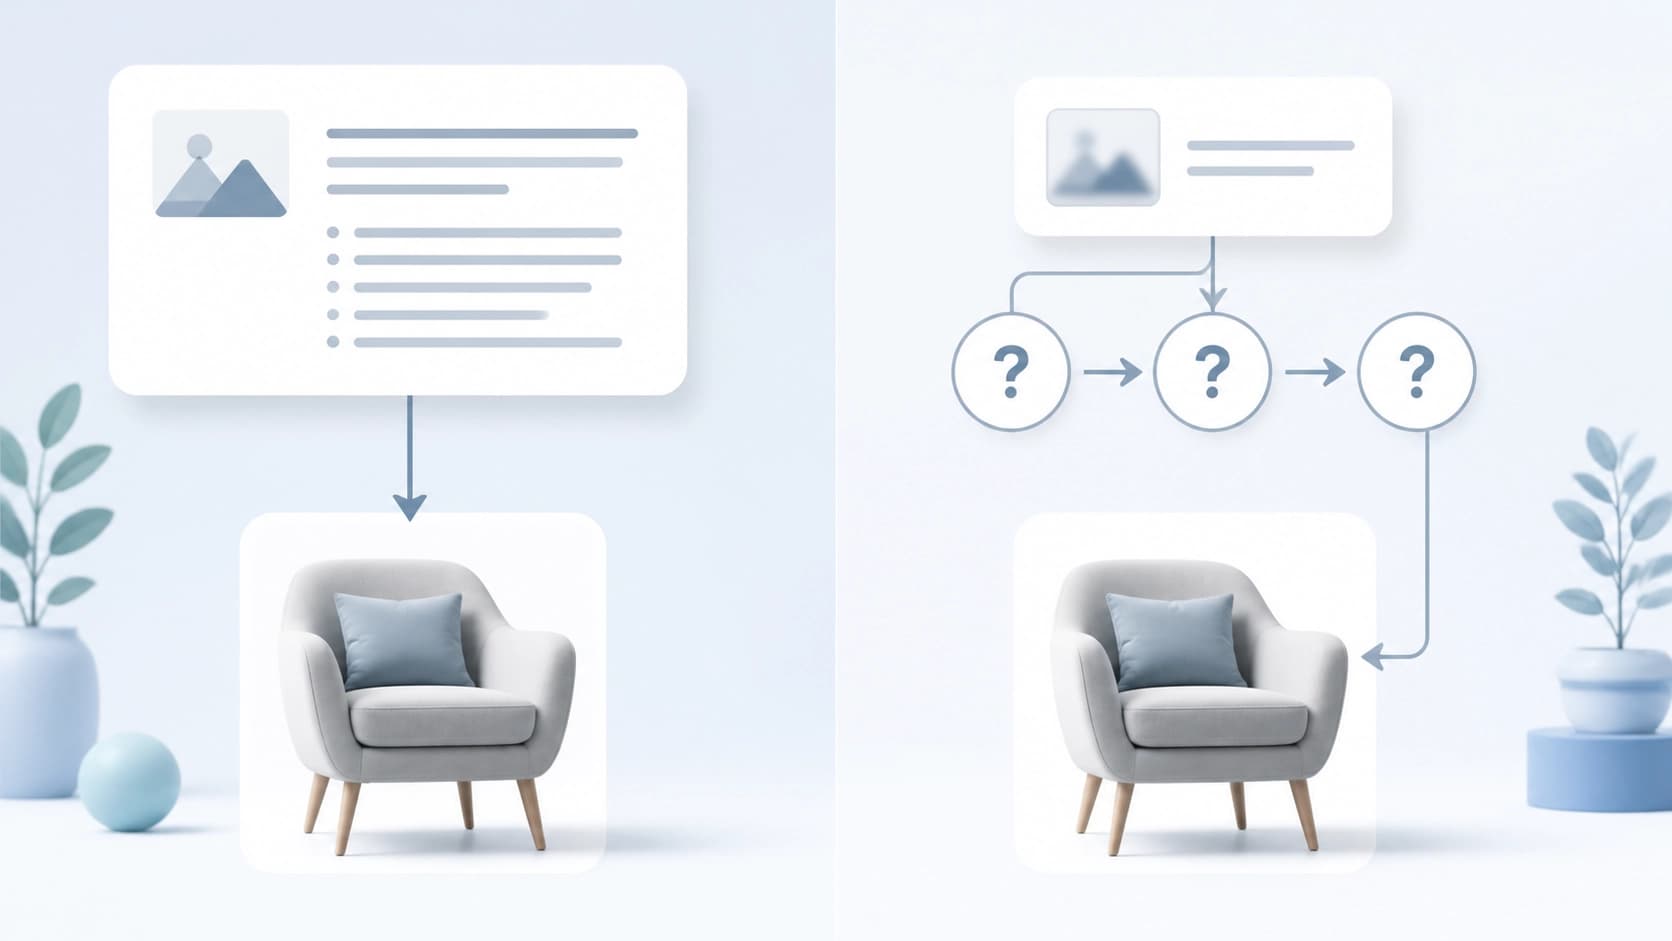
नियंत्रित सूचना-अभाव
मुख्य विचार "औसतन" सटीकता मापने का नहीं, बल्कि यह धीरे-धीरे नियंत्रित करने का है कि लक्ष्य के बारे में पहले से कितनी जानकारी दी गई है और कितनी मॉडल को ख़ुद हासिल करनी है। पैमाने के एक सिरे पर काम सामान्य एक-चरणीय टेस्ट से लगभग अलग नहीं होता: विवरण विस्तृत है, लक्ष्य स्पष्ट है। दूसरे सिरे पर शुरुआती वाक्यांश बिल्कुल नहीं होता, और मनचाही वस्तु के बारे में मॉडल जो कुछ जानता है, वह उसे अपने ही स्पष्टीकरण वाले सवालों से निकालना होता है।
ऐसी बनावट पहचानने के कौशल को बातचीत करने के कौशल से अलग करने देती है। जो मॉडल सटीक संकेत से वस्तु ढूँढ लेता है, वह तब पूरी तरह फ़ेल हो सकता है जब संकेत टुकड़ों में जोड़ना पड़े।
चार संदर्भ और चार प्रोटोकॉल
प्रयोगात्मक माहौल चार विज़ुअल संदर्भों पर टिका है, जो इंसानी परिदृश्यों के क़रीब हैं, और चार अलग-अलग संवाद प्रोटोकॉल पर। यह ज़रूरी है: नतीजा किसी एक कामयाब या नाकाम सेटिंग तक सीमित नहीं है। साथ ही यह भी जाँचा गया कि विवरण कौन बनाता है — इंसान या कोई दूसरा मॉडल, और सोच की मात्रा, दोबारा कोशिशें तथा विवरण देने वाले प्रदाता के बदलाव का क्या असर पड़ता है। नीचे बताई गई प्रवृत्तियाँ इन सभी रूपों में दोहराई गईं।
असल में टूटता कहाँ है
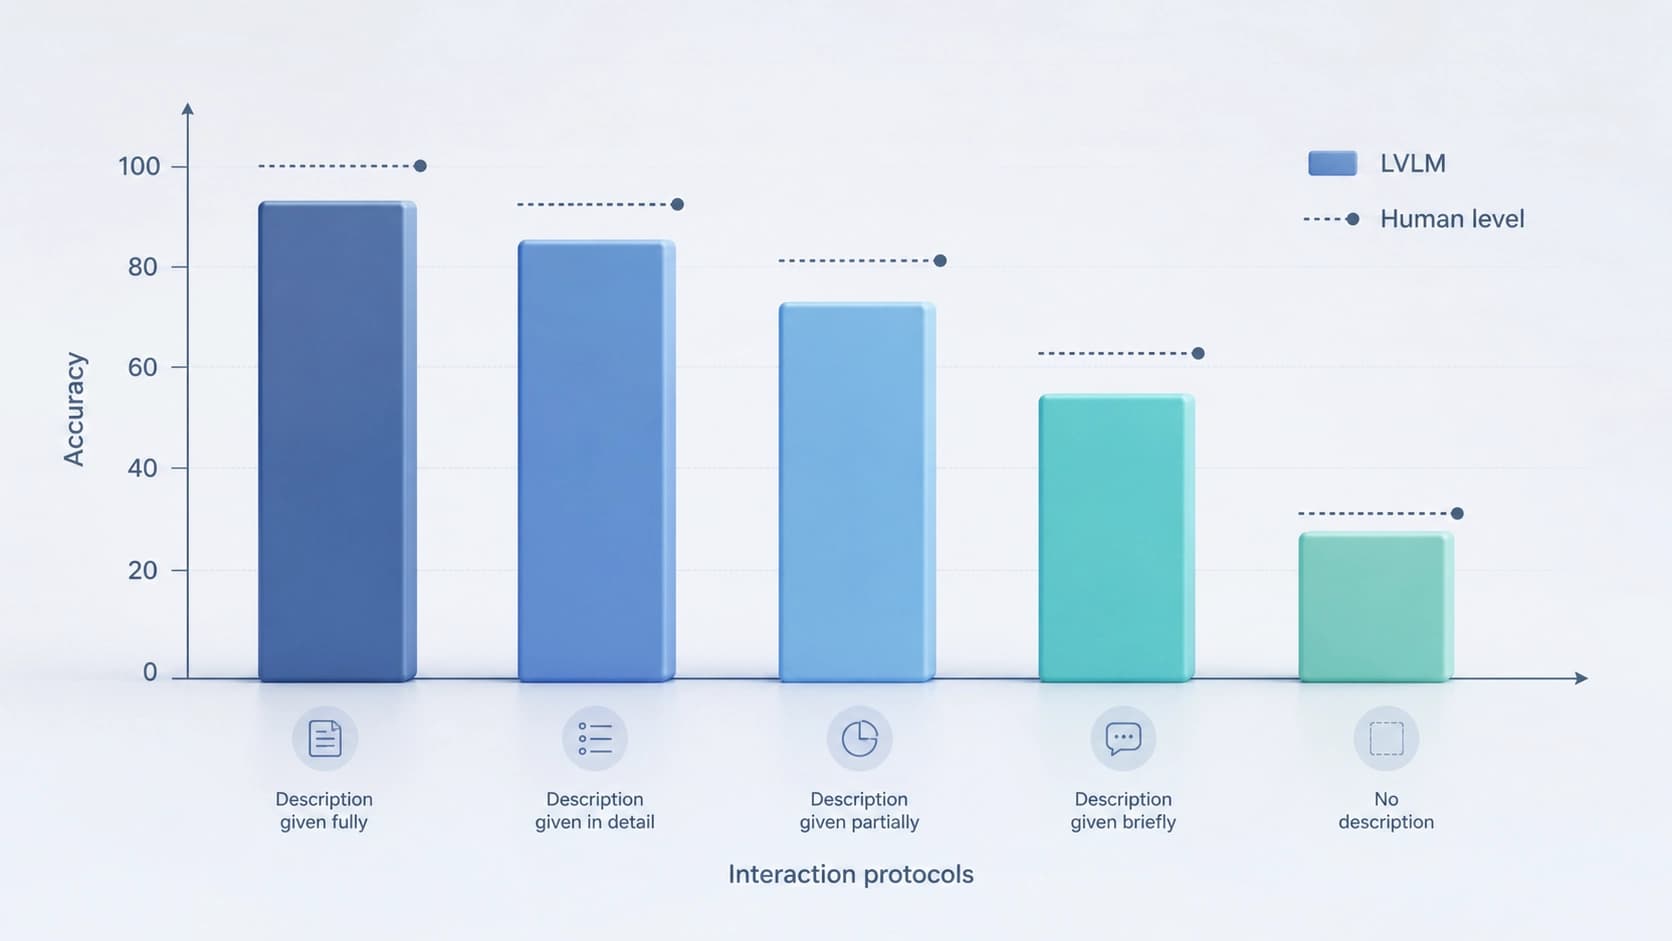
इंसानों से दूरी हर प्रोटोकॉल पर बनी रहती है
मुख्य निष्कर्ष सुखद नहीं है: किसी भी मोड में मौजूदा बड़े विज़ुअल-लैंग्वेज मॉडल इंसानी बेसलाइन के क़रीब तक नहीं पहुँचे। यह दूरी तब भी बनी रहती है जब काम लगभग मामूली लगता है, और तब भी जब उसमें सच्ची बातचीत की ज़रूरत होती है। बात कुछ प्रतिशत अंकों की नहीं, भरोसे में गुणात्मक फ़र्क़ की है।
सबसे बुरा तब — जब विवरण ही न हो
सबसे कम नतीजे उस परिदृश्य में दर्ज हुए जहाँ लक्ष्य का शुरुआती वाक्यांश मौजूद ही नहीं है। मॉडल को ख़ुद अनुमान लगाना पड़ता है कि क्या ढूँढना है, सवाल पूछने पड़ते हैं और जवाबों के आधार पर खोज का दायरा सीमित करना पड़ता है। यह अब पहचानने की बात नहीं, बल्कि सक्रिय व्यवहार की बात है: ख़ुद तय करना होता है कि जानकारी कम है, और ऐसी क्वेरी बनानी होती है जो इस कमी को पूरा करे।
यहीं वह चूक सामने आती है जो पेपर के शीर्षक में है: मॉडल देखना जानता है, पर पूछना नहीं। वह या तो अंदाज़े पर दाँव लगाता है, या ऐसे सवाल पूछता है जो कुछ स्पष्ट नहीं करते।
स्पष्टीकरण काम करता है, पर हमेशा नहीं
बातचीत बेकार नहीं है। जब स्पष्टीकरण वाला सवाल शुरुआती विवरण को सुधारता या पूरा करता है, तो सटीकता साफ़ तौर पर बढ़ती है। यानी मॉडल में संवाद का तंत्र मौजूद है और फ़ायदा देता है — लेकिन सिर्फ़ किसी और के वाक्यांश को संपादित करने की भूमिका में। जैसे ही वाक्यांश शून्य से बनाना पड़े, बढ़त ग़ायब हो जाती है।
भरोसा सटीकता से आगे
विश्लेषण की एक अलग दिशा — कैलिब्रेशन। मॉडल व्यवस्थित रूप से उससे ज़्यादा भरोसा जताते हैं जितना उनकी असल सटीकता पुष्ट करती है। व्यवहार में इसका मतलब है कि मॉडल के जवाब से यह तय नहीं किया जा सकता कि उस पर भरोसा करना चाहिए या नहीं: सही और ग़लत, दोनों चुनाव एक ही उत्साही लहज़े में आते हैं।
ऐप्लिकेशन के लिए यह सिर्फ़ ग़लतियों से ज़्यादा ख़तरनाक है। अगर सिस्टम ग़लती करता है पर ईमानदारी से अनिश्चितता जताता है, तो उससे दोबारा पूछा जा सकता है या किसी इंसान को बुलाया जा सकता है। अगर वह पूरे यक़ीन के साथ ग़लती करता है — तो ऐसा सुरक्षा-कवच बनाया ही नहीं जा सकता।
यह काम जितना दिखता है उससे ज़्यादा मुश्किल क्यों है
इंटरैक्टिव विज़ुअल ग्राउंडिंग के लिए तीन तंत्रों का एक साथ काम ज़रूरी है:
- विज़ुअल मिलान — शब्दों को तस्वीर की वस्तुओं से जोड़ना, जिसमें स्थानिक संबंध और गुण भी शामिल हैं;
- सूचना की खोज — यह समझना कि कौन-सी जानकारी कम है, और उसे ब्रूट-फ़ोर्स के बजाय सवाल के ज़रिए हासिल करना;
- संश्लेषण — बिखरे जवाबों को एक अनुमान में पिरोना और रास्ते में उसे न खोना।
आधुनिक मॉडलों में ये हर कौशल अलग-अलग किसी न किसी हद तक मौजूद है। टूटता है इनके बीच का जोड़: जो दिखा, वह सवाल में नहीं बदलता, और सवाल का जवाब दुनिया की तस्वीर नहीं बदलता।
व्यवहार में इसका क्या मतलब है
अगर आप मल्टीमॉडल मॉडल पर कोई प्रोडक्ट बना रहे हैं — मान लीजिए GPT-4o या इमेज सपोर्ट वाला कोई और API — तो इस काम के निष्कर्ष आसानी से इंजीनियरिंग फ़ैसलों में बदले जा सकते हैं:
- पहले विवरण पर भरोसा न करें। अगर उपयोगकर्ता अनिश्चित ढंग से क्वेरी बनाता है, तो एक क्वेरी-जवाब के बजाय स्पष्टीकरण का चक्र रखें।
- दावा किए गए भरोसे पर भरोसा न करें। कैलिब्रेशन किसी ख़ास काम के लिए अपनी ही एनोटेशन पर बनाना बेहतर है, मॉडल के आत्म-मूल्यांकन पर नहीं।
- मॉडल की जगह सवाल डिज़ाइन करें। अगर सिस्टम ख़ुद यह नहीं समझ पाता कि उसके पास क्या कम है, तो पूछने वाले की भूमिका बाहरी लॉजिक परत को लेनी पड़ेगी।
- अपने सूचना-अभाव पर टेस्ट करें। यह जाँचना उपयोगी है कि पाइपलाइन ठीक उन मोडों में कैसा बर्ताव करती है जहाँ लेखकों के आँकड़ों के मुताबिक सटीकता गिर जाती है।
निष्कर्ष
यह काम क्षमताओं की ग़ैरमौजूदगी नहीं, बल्कि कौशलों के बेमेल होने को दर्ज करता है। मॉडल अच्छी तरह रखे गए सवालों का जवाब देने के लिए काफ़ी देखते हैं, पर स्थिति को इतना नहीं समझते कि ख़ुद सवाल पूछ सकें। जब तक यह दूरी पाटी नहीं जाती, इंटरैक्टिव विज़ुअल ग्राउंडिंग ऐसा काम बना रहेगा जहाँ संवाद की सबसे भरोसेमंद कड़ी इंसान ही बना रहता है।


