
ट्रांसफ़र कहाँ समाप्त होता है: गेम एजेंटों के लिए डेटा का पैमाना, दुनिया की विविधता और मॉडल का आकार
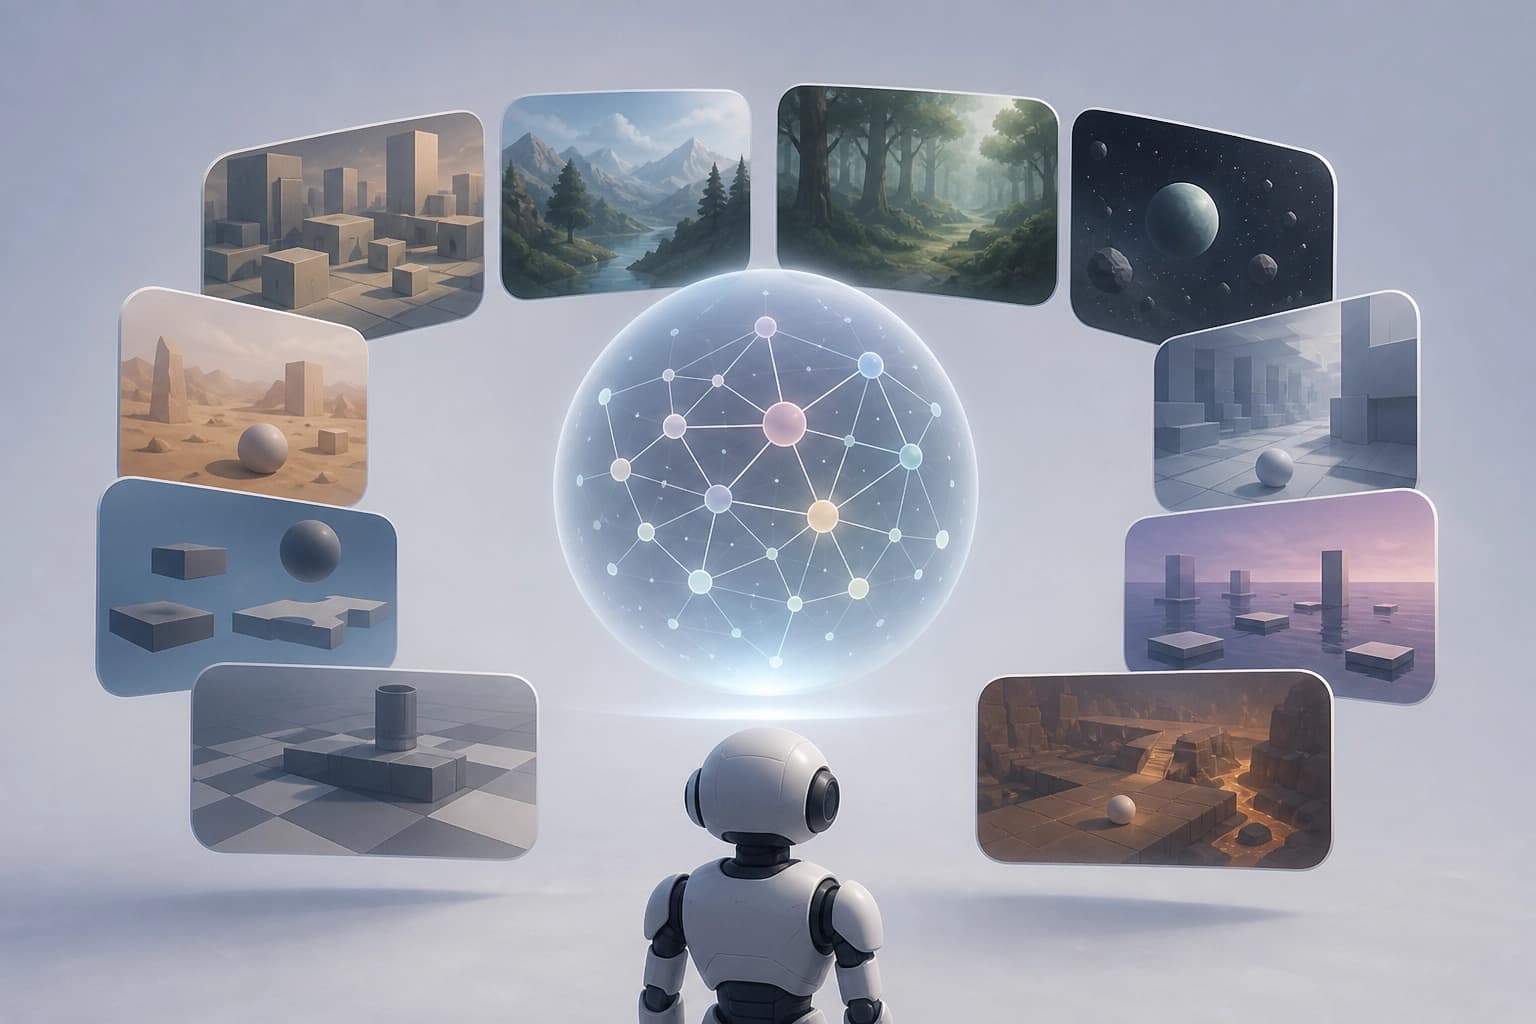
120 कॉन्फ़िगरेशन में यह जाँचा गया कि अलग-अलग ग्राफ़िक्स, भौतिकी, नियंत्रण और कार्यों वाले आभासी परिवेशों के बीच जाने पर लंबे समय तक प्रीट्रेनिंग के लाभ बने रहते हैं या नहीं। डेटा संग्रह बढ़ाने से सीखे हुए संसारों में मदद मिलती है, विविधता से मिलते-जुलते परिवेशों में स्थानांतरण बढ़ता है, और मॉडल का आकार बढ़ाने से डेटा का लाभ बेहतर होता है; लेकिन एक ही संसार में प्रशिक्षण दूर के परिवेशों के अनुकूलन को ख़राब करता है। लेखक निष्कर्ष निकालते हैं कि सार्वभौमिक एजेंट बनाने के लिए केवल पूर्व-प्रशिक्षण पर्याप्त नहीं है।
क्या जाँचा गया और ट्रांसफ़र कैसे मापा गया
यह अध्ययन वर्चुअल दुनिया में मूर्त एजेंटों के लिए continued pre-training (CPT) पर केंद्रित है। लेखकों ने जाँचा कि क्या डेटा के पैमाने, उसकी विविधता और मॉडल के आकार से होने वाले सुधार दूसरी जगहों पर भी लागू होते हैं। इस कार्य में प्रशिक्षण की 120 कॉन्फ़िगरेशन शामिल हैं।
| कारक | क्या बदला गया |
|---|---|
| मॉडल का आकार | 0.8B से 27B तक के चार मान |
| डेटा की मात्रा | 50 से 1,600 घंटे तक के छह मान |
| डेटा मिश्रण | एक दुनिया के डेटा से लेकर विविध बहु-दुनिया कॉर्पस तक के पाँच विकल्प |
| मूल्यांकन | तीन-स्तरीय सत्यापन हानियाँ और गेम बेंचमार्क |
मूल्यांकन तीन स्तरों पर किया जाता है: प्रशिक्षण में शामिल दुनिया, उनसे मिलती-जुलती दुनिया और अनदेखी दुनिया। यह डिज़ाइन परिचित परिवेश में मिले लाभ को ट्रांसफ़र से अलग करता है। व्यावहारिक मानदंड: सत्यापन में दुनिया के तीनों समूह शामिल करें। वरना प्रशिक्षित दुनिया में हुई बढ़ोतरी दूरस्थ दुनिया के अंतर को छिपा देगी।
डेटा की मात्रा: परिचित दुनिया में प्रभाव
डेटा की मात्रा बढ़ाने से उन दुनियाओं में प्रदर्शन बेहतर होता है जो प्रशिक्षण डेटा में शामिल थीं। परिचित क्षेत्रों में यह पैमाने का पुष्ट प्रभाव है। लेखकों ने दूरस्थ दुनिया के लिए ट्रांसफ़र को केवल डेटा की मात्रा तक सीमित नहीं किया है।
डेटा की मात्रा हर लक्ष्य के लिए सार्वभौमिक उपाय नहीं है। जहाँ दुनिया को प्रशिक्षण में पहले से दर्शाया गया है, वहाँ इससे स्पष्ट लाभ मिलता है। नई दुनिया के लिए अलग से जाँचना होगा कि यह मात्रा अंतर के कितने हिस्से को कम करती है।
चयन के मानदंड:
- लक्षित दुनिया प्रशिक्षण में शामिल है — डेटा की मात्रा बढ़ाएँ;
- लक्षित दुनिया दूरस्थ है — केवल मात्रा पर निर्भर न रहें;
- दुनियाओं की संरचना स्पष्ट नहीं है — पहले दुनियाओं को उनकी निकटता के आधार पर बाँटें।
विविधता: मिलती-जुलती, लेकिन दूरस्थ दुनिया में नहीं, ट्रांसफ़र
डेटा की विविधता से मिलती-जुलती दुनियाओं में ट्रांसफ़र बेहतर होता है। दूरस्थ दुनिया में बढ़त सीमित है। यह प्रभाव विविधता को केवल मात्रा बढ़ाने से अलग करता है।
| दुनिया की निकटता का स्तर | विविधता का देखा गया प्रभाव | व्यावहारिक निष्कर्ष |
|---|---|---|
| मिलती-जुलती दुनिया | ट्रांसफ़र बेहतर होता है | विविध मिश्रण उपयोगी है |
| दूरस्थ दुनिया | सीमित बढ़त | केवल विविधता पर्याप्त उपाय नहीं है |
विविधता ट्रांसफ़र का दायरा बढ़ाती है, लेकिन एजेंट को सार्वभौमिक नहीं बनाती। डेटा का मिश्रण मिलती-जुलती दुनियाओं तक पहुँचने के पुल की तरह काम करता है। दूरस्थ दुनिया के लिए यह पुल ज़रूरत से छोटा है।
व्यावहारिक मानदंड: लक्षित दुनियाओं की प्रशिक्षण वाली दुनियाओं से निकटता का आकलन करें। मिलती-जुलती दुनियाओं के लिए मिश्रण की विविधता कारगर उपाय है। दूरस्थ दुनिया के लिए विविधता पर्याप्त नहीं है।
मॉडल का आकार: डेटा का प्रभावी उपयोग और सीमित सामान्यीकरण का जोखिम
मॉडल का आकार बढ़ाने से डेटा का उपयोग अधिक प्रभावी होता है। एक ही दुनिया पर प्रशिक्षण देने से मॉडल का आकार दूरस्थ दुनिया में सामान्यीकरण को खराब करता है। इसलिए मॉडल का आकार डेटा की संरचना पर निर्भर करता है।
बड़ा मॉडल उपलब्ध डेटा का बेहतर उपयोग करता है। लेकिन सीमित प्रशिक्षण में यह ट्रांसफ़र का दायरा संकुचित कर देता है। पैरामीटर में समान बढ़ोतरी का प्रभाव दुनियाओं के मिश्रण के अनुसार अलग होता है।
चयन के मानदंड:
- एक ही दुनिया पर प्रशिक्षण — मॉडल का आकार बढ़ाने से ट्रांसफ़र में बढ़ोतरी की उम्मीद न करें;
- विविध डेटा — मॉडल का आकार डेटा के उपयोग को बेहतर बनाता है;
- आकार का चयन — केवल मिश्रण के चयन के साथ करें।
प्रशिक्षण के दो चरण: इंटरफ़ेस और दुनिया
लेखक शुरुआती इंटरफ़ेस चरण (early interface phase) देखते हैं। इस चरण में मॉडल को अलग-अलग दुनियाओं में व्यापक लाभ मिलते हैं। बाद में दुनिया का अंतिम चरण (later world phase) आता है। इसमें सुधार प्रशिक्षण वाली और उनसे मिलती-जुलती दुनियाओं तक सीमित हो जाते हैं।
ये चरण ट्रांसफ़र का अलग-अलग दायरा तय करते हैं। शुरुआती चरण अलग-अलग दुनियाओं के लिए एक सामान्य इंटरफ़ेस बनाता है। अंतिम चरण सुधारों को परिचित और निकट परिवेश से जोड़ता है। यह प्रशिक्षण की गलती नहीं, बल्कि प्रभाव के दायरे में बदलाव है।
चयन के मानदंड:
- व्यापक इंटरफ़ेस चाहिए — शुरुआती चरण;
- लक्षित दुनिया चाहिए — अंतिम चरण;
- दूरस्थ दुनिया चाहिए — शुरुआती चरण ट्रांसफ़र को बनाए नहीं रखता।
continued pre-training की सीमाएँ
लेखक अनुकरण-आधारित प्रशिक्षण की सीमाओं और दूरस्थ दुनिया में बने रहने वाले अंतर का उल्लेख करते हैं। उनके निष्कर्ष के अनुसार, सार्वभौमिक मूर्त एजेंटों के लिए CPT से आगे जाकर अधिक सार्थक प्रशिक्षण चरणों की ज़रूरत है। CPT प्रतिस्पर्धी परिणाम देता है, लेकिन ट्रांसफ़र के सभी स्तरों को पूरा नहीं करता।
इस कार्य के मॉडल गेमिंग 3D दुनियाओं के लिए विशिष्ट मॉडलों और frontier मॉडलों के साथ प्रतिस्पर्धा करते हैं। वे रीयल-टाइम मोड में बेहतर परिणाम दिखाते हैं। ये नतीजे दूरस्थ दुनिया के अंतर को खत्म नहीं करते। वे CPT की प्रयोज्यता की सीमा तय करते हैं।
चयन के मानदंड:
- सार्वभौमिक एजेंट — CPT से आगे के चरणों की योजना बनाएँ;
- दूरस्थ दुनिया — CPT को अंतिम समाधान न मानें;
- प्रशिक्षण से मिलती-जुलती दुनिया — CPT एक कारगर चरण बना रहता है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
SpecEvo: विकासवादी खोज की लागत घटाने के लिए हल्के और उन्नत LLM का समन्वय
SpecEvo फ़्रेमवर्क विकासवादी खोज का पुनर्वितरण करता है: सामान्य उम्मीदवार कम लागत वाले मॉडलों को बेहतर बनाते हैं, जबकि शक्तिशाली मॉडल केवल रणनीतिक नियंत्रण बिंदुओं पर, सफलताओं और गतिरोधों के इतिहास के आधार पर जुड़ते हैं। 176 कार्यों पर किए गए प्रयोगों में, इस तरीके ने API लागत में 80% की कमी करते हुए महंगे विकल्पों के बराबर प्रदर्शन किया या उनसे बेहतर रहा।
21 नवम्बर 2026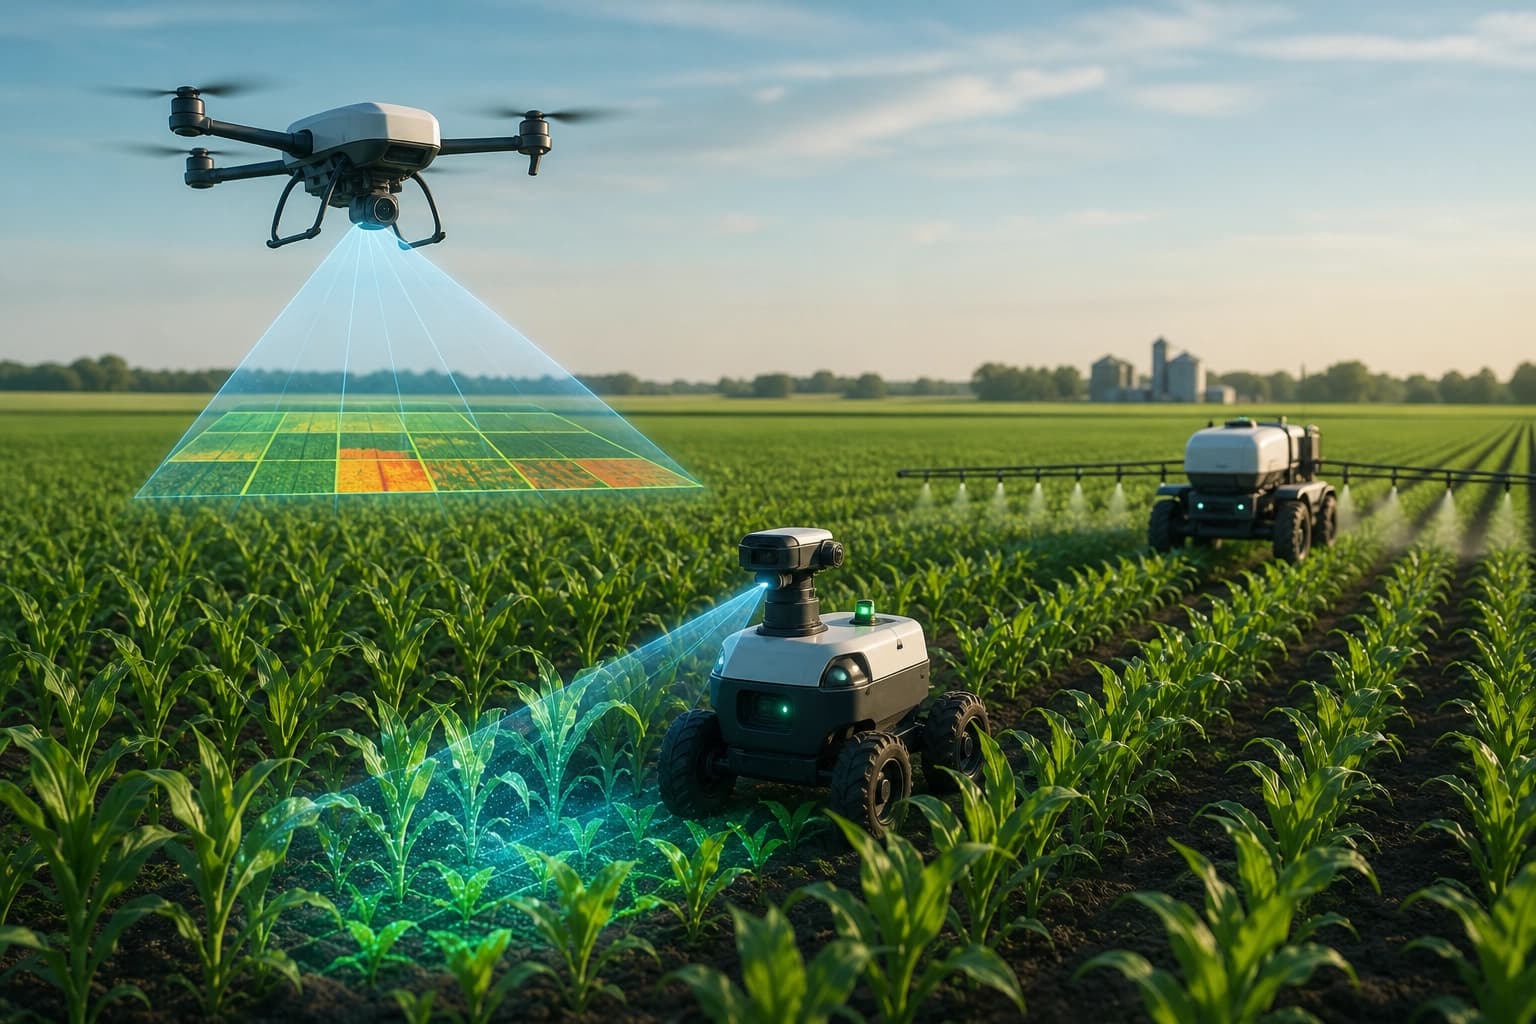
खेत में एल्गोरिदम और रोबोट: फसलों पर लक्षित हस्तक्षेप और निगरानी
यह लेख दिखाता है कि सेंसर डेटा, हवाई फ़ोटोग्राफ़ी और स्वचालित प्लेटफ़ॉर्म किस तरह शुरुआती चरणों में खतरों का पता लगाने, केवल समस्या वाले क्षेत्रों में उपचार करने और फसल की पैदावार के पूर्वानुमानों को बेहतर बनाने में मदद करते हैं। इसमें इन्हें अपनाने की बाधाओं—उपकरणों की कीमत, डेटा की विश्वसनीयता, कर्मचारियों का प्रशिक्षण और संचार नेटवर्क तक पहुँच—पर भी चर्चा की गई है।
21 नवम्बर 2026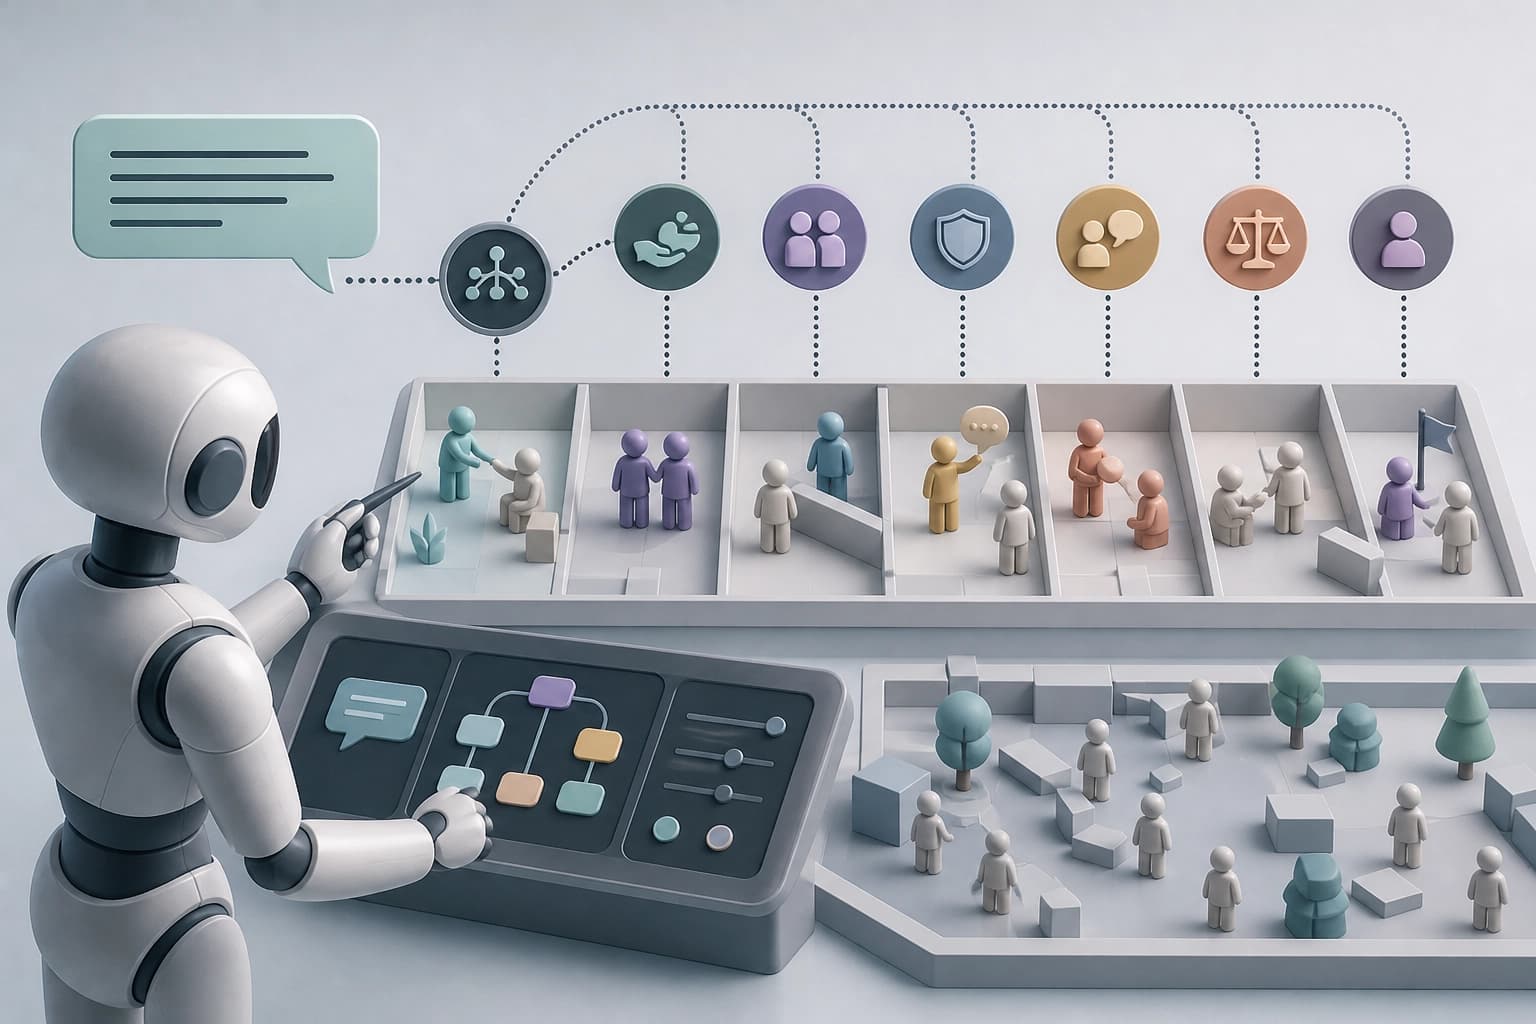
Fig: AI एजेंटों के सामाजिक व्यवहार का परीक्षण करने के लिए नियंत्रित गेम-आधारित हस्तक्षेप
Fig वांछित व्यवहार का मौखिक विवरण प्राप्त करता है, उसे विभिन्न प्रकारों में विभाजित करता है और मॉडलों से अपेक्षित कार्रवाइयाँ करवाने के लिए खेल की स्थितियों में लक्षित बदलाव करता है। छह सामाजिक पैटर्न के वैध परिदृश्यों में, हस्तक्षेपों ने नियंत्रण समूहों की तुलना में लक्षित व्यवहार के प्रयासों का औसत अनुपात 10,9% बढ़ाया। लेखक बहु-एजेंट परिवेशों को पुनरुत्पाद्य मूल्यांकन के लिए एक समायोज्य परीक्षण मंच के रूप में देखने का सुझाव देते हैं।
21 नवम्बर 2026