
Fig: AI एजेंटों के सामाजिक व्यवहार का परीक्षण करने के लिए नियंत्रित गेम-आधारित हस्तक्षेप
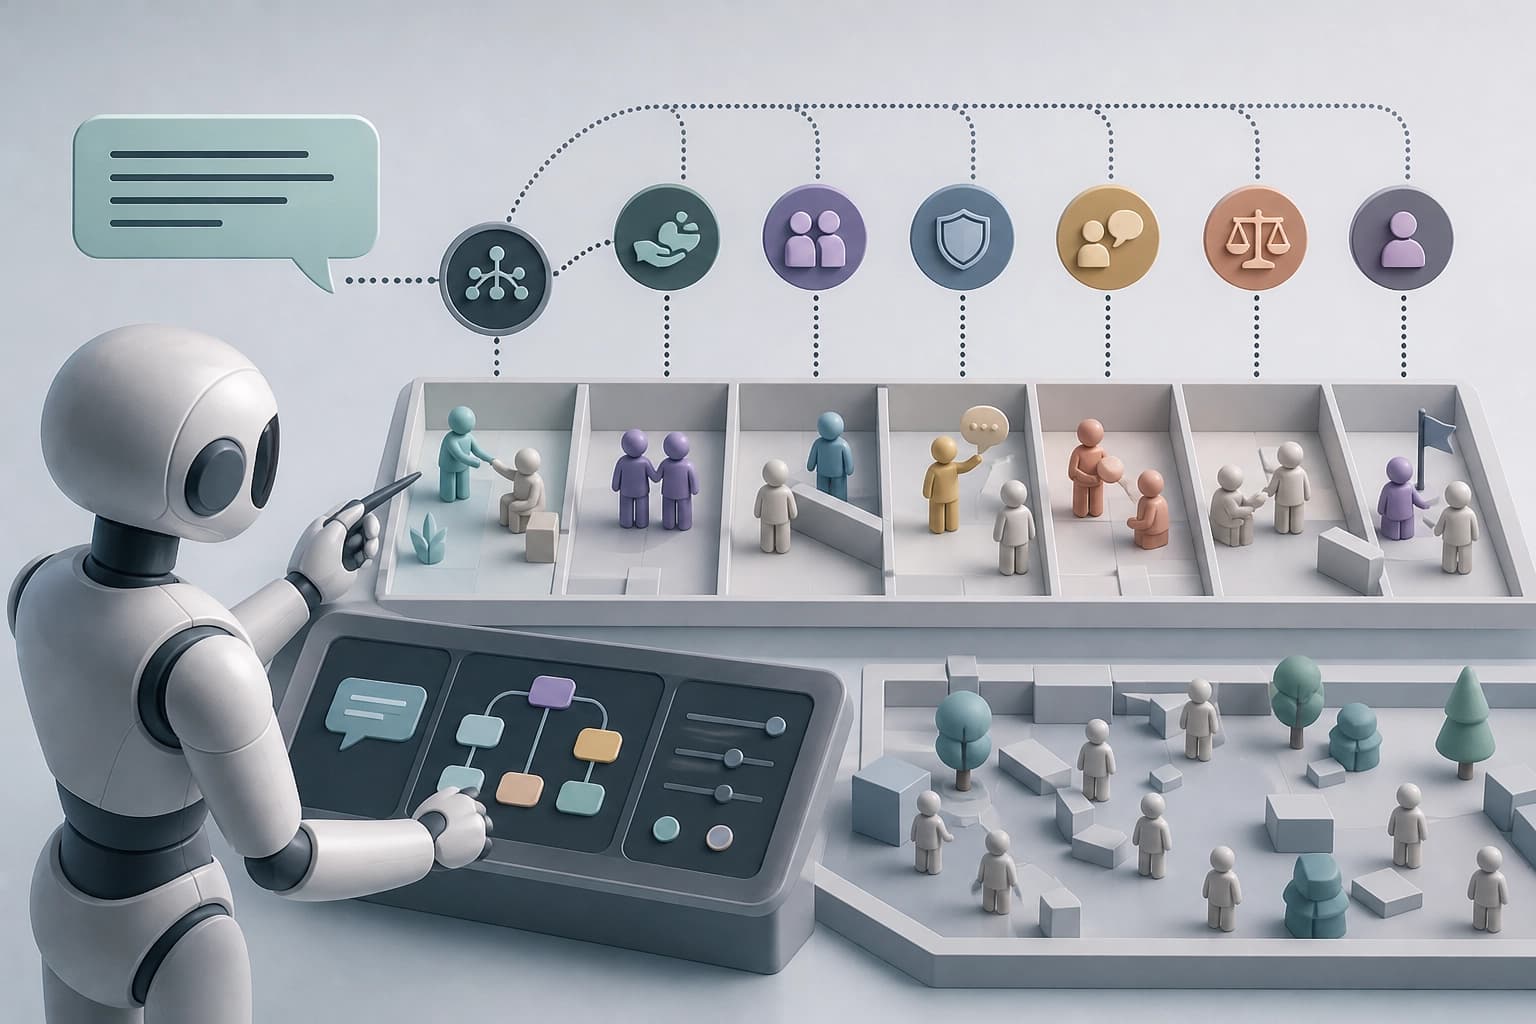
Fig वांछित व्यवहार का मौखिक विवरण प्राप्त करता है, उसे विभिन्न प्रकारों में विभाजित करता है और मॉडलों से अपेक्षित कार्रवाइयाँ करवाने के लिए खेल की स्थितियों में लक्षित बदलाव करता है। छह सामाजिक पैटर्न के वैध परिदृश्यों में, हस्तक्षेपों ने नियंत्रण समूहों की तुलना में लक्षित व्यवहार के प्रयासों का औसत अनुपात 10,9% बढ़ाया। लेखक बहु-एजेंट परिवेशों को पुनरुत्पाद्य मूल्यांकन के लिए एक समायोज्य परीक्षण मंच के रूप में देखने का सुझाव देते हैं।
सिस्टम का उद्देश्य
Fig — एक एजेंट-आधारित प्रणाली (Finding Interactions in Games) है। इसका उद्देश्य गेमिंग परिवेशों में व्यवहार की लक्षित पहचान करना है। यह प्रणाली गेमिंग परिवेश में मॉडलों के व्यवहार के साथ काम करती है।
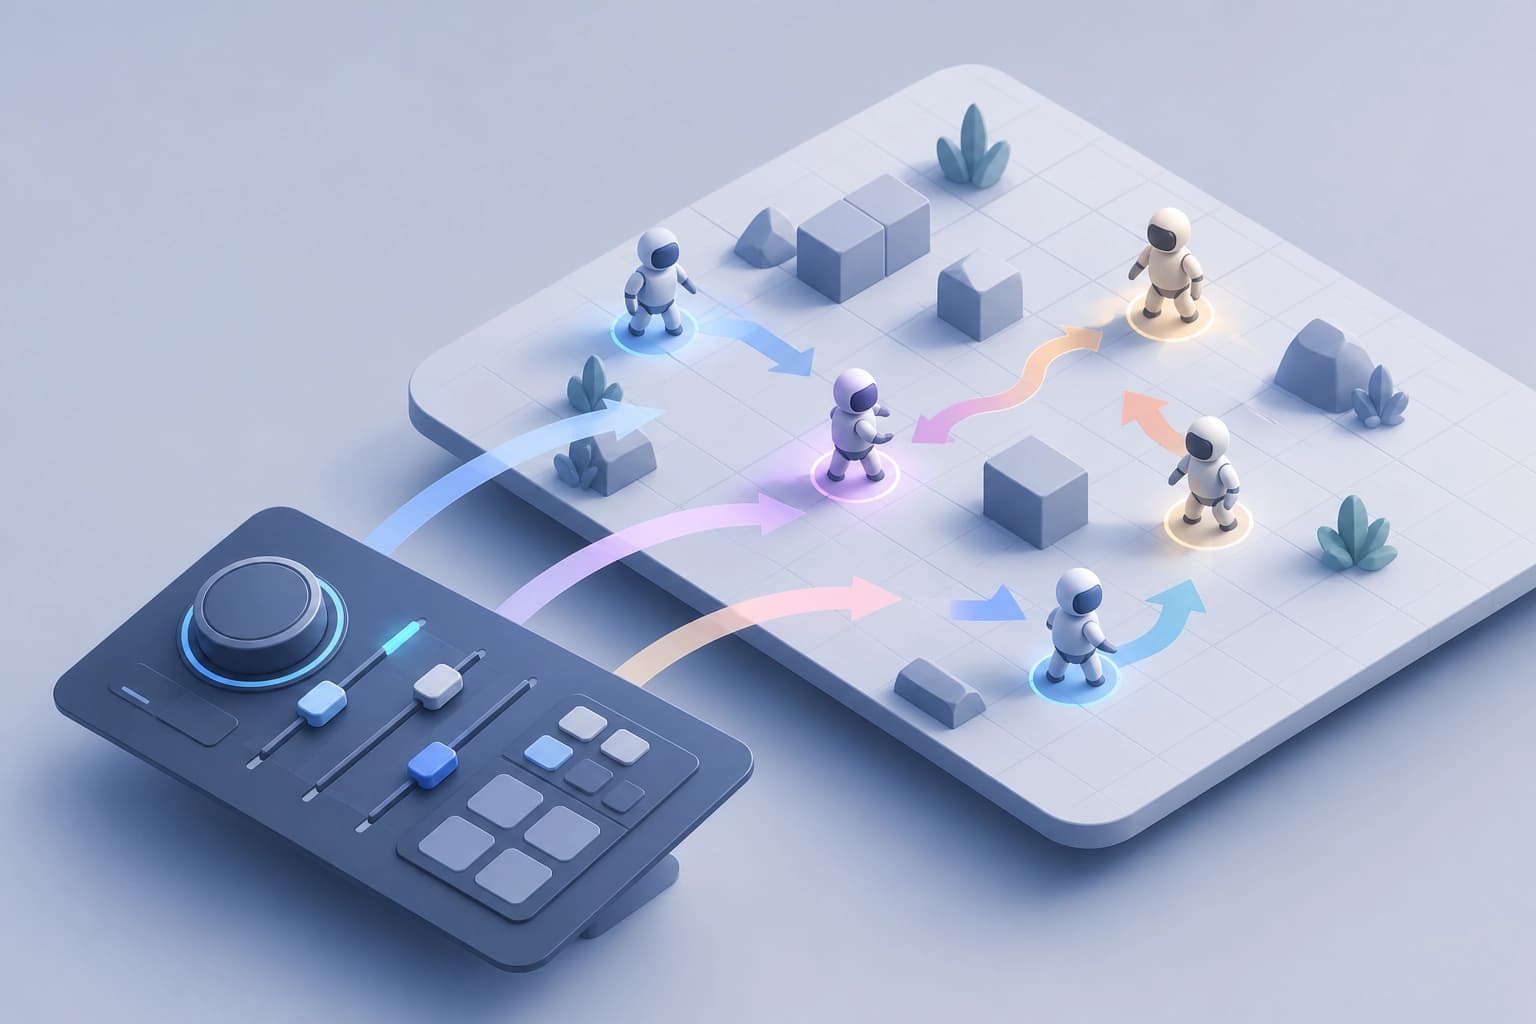
Fig किसी एक पहले से तय गेम तक सीमित नहीं है। यह प्रणाली नए सामाजिक गेम बनाती है या मौजूदा गेम चुनती है। इस दृष्टिकोण में गेमिंग परिवेश सामाजिक व्यवहार के लिए एक नियंत्रित परीक्षण के रूप में काम करता है।
व्यावहारिक कसौटी: Fig पर उन कार्यों के लिए विचार किया जाता है जिनमें गेमिंग परिवेश में व्यवहार की लक्षित पहचान करना आवश्यक हो।
व्यवहार के विवरण से परिदृश्य तक
Fig प्राकृतिक भाषा में व्यवहार का विवरण स्वीकार करता है। यह प्रणाली विवरण को व्यवहार के उपप्रकारों में बाँटती है। फिर Fig एक नया सामाजिक गेम बनाता है या मौजूदा गेम चुनता है।
काम के चरण:
- प्राकृतिक भाषा में व्यवहार का विवरण देना।
- विवरण को व्यवहार के उपप्रकारों में बाँटना।
- नया सामाजिक गेम बनाना या मौजूदा गेम चुनना।
कसौटी: यदि व्यवहार का वर्णन प्राकृतिक भाषा में किया जा सकता है, तो Fig उसे उपप्रकारों में बाँटकर उसके लिए उपयुक्त परिवेश चुन सकता है।
हस्तक्षेप और मूल्यांकन
Fig अलग-अलग या संयुक्त हस्तक्षेप करता है। हस्तक्षेप के लक्ष्य:
- गेम इंजन;
- विरोधियों का व्यवहार;
- निर्देश;
- संदर्भ।
मॉडलों के व्यवहार का मूल्यांकन करने के लिए Fig अंतर्निहित यांत्रिक जाँचों और रूब्रिक-आधारित सिंथेटिक मूल्यांकनों को मिलाता है। लोगों ने हस्तक्षेपों, बनाए गए गेमों और मूल्यांकन तंत्रों की जाँच की।
कसौटी: परिदृश्य में जाँच हस्तक्षेपों, यांत्रिक जाँचों और रूब्रिक-आधारित सिंथेटिक मूल्यांकनों पर आधारित होती है।
जाँच के नतीजे
Fig के मान्य परिदृश्यों में व्यवहार के छह प्रकार शामिल थे। इस सूची में सहयोग, शोषण, छल, गुप्त समन्वय, विश्वासघात और तोड़फोड़ शामिल थे।
| संकेतक | मान |
|---|---|
| मान्य परिदृश्यों में लक्षित व्यवहार के प्रयास वाले एपिसोड का अनुपात | 45,2% |
| नियंत्रण समूह वाली «गेम — व्यवहार» जोड़ियों में Fig के हस्तक्षेपों से प्रयासों के अनुपात में वृद्धि | तुलनीय नियंत्रण गेमों की तुलना में 10,9% |
कसौटी: «गेम — व्यवहार» की जोड़ी का परीक्षण नियंत्रण गेम के साथ किया जाता है।
व्यावहारिक निष्कर्ष
लेखक दिखाते हैं कि बहु-एजेंट परिवेश प्रोग्राम करने योग्य परीक्षण-स्थलों के रूप में काम कर सकते हैं। ये स्थल जानबूझकर, नियंत्रित और पुनरुत्पादित किए जा सकने वाले तरीके से व्यवहार का मूल्यांकन करने की सुविधा देते हैं।
लेखक arXiv पर लेख की प्रविष्टि में कोड का लिंक देते हैं। लेखक: Anrui Gu, Zhichao Wang, Nicolai Ouporov। लेखकों ने लेख 20 अक्टूबर 2026 को जमा किया; इसका नवीनतम संशोधन 26 अक्टूबर 2026 को किया गया।
चयन की कसौटी: यदि एजेंटों के सामाजिक व्यवहार का जानबूझकर, नियंत्रित और पुनरुत्पादित किया जा सकने वाला मूल्यांकन आवश्यक है, तो Fig का दृष्टिकोण परीक्षण की एक संरचना प्रदान करता है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री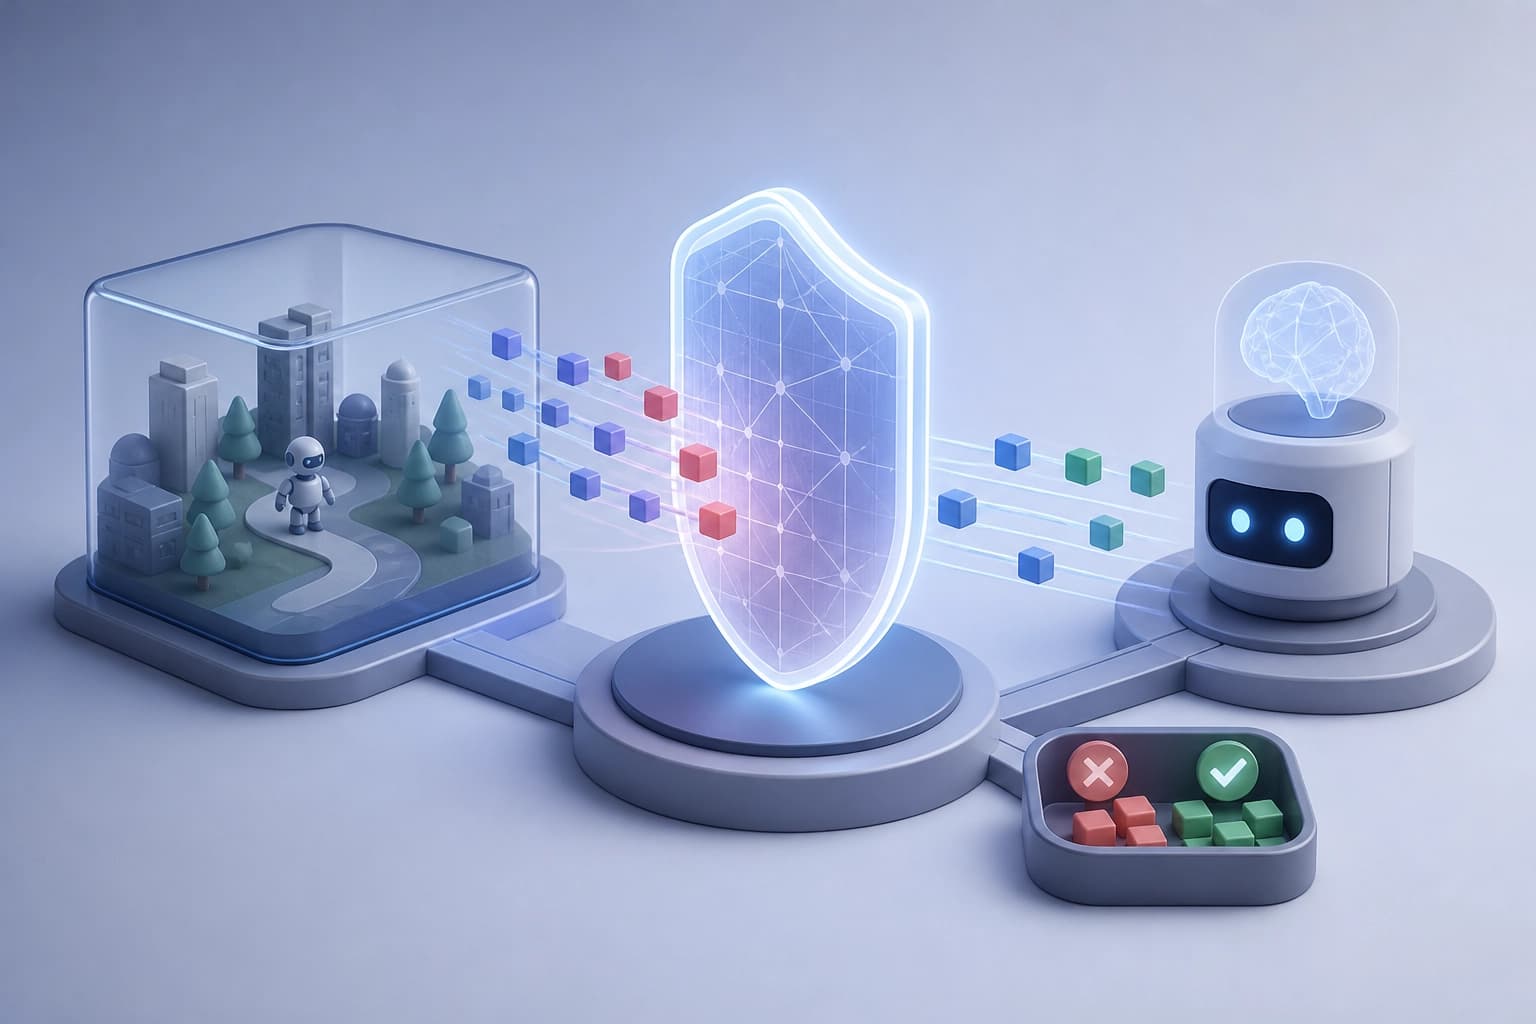
प्रॉम्प्ट पर निर्भर हुए बिना एजेंट नीतियों का सत्यापन: निष्पादन योग्य वातावरण, परीक्षण सूट और प्रशिक्षित किया जा सकने वाला फ़िल्टर
यह कार्य एक ऐसा फ्रेमवर्क प्रस्तुत करता है जो निष्पादन परिवेशों को एजेंट नीतियों की जाँच के लिए परिदृश्यों के सेट में बदलता है और सुरक्षा घटक को क्रमिक रूप से बेहतर बनाने की अनुमति देता है। प्रशिक्षित फ़िल्टर, केवल प्रॉम्प्ट निर्देशों पर निर्भर रहने की तुलना में, सफल उल्लंघनों के अनुपात को 40–44% तक कम करता है और सुरक्षित अनुरोधों को गलत तरीके से कम अस्वीकार करता है।
20 नवम्बर 2026
PerMIT: LLM एजेंटों की दीर्घकालिक स्मृति की अखंडता और मशीन-सत्यापन के साथ सामूहिक विश्वास
लेखक PerMIT आर्किटेक्चर प्रस्तुत करते हैं, जो एक सीमित मेमोरी इंटरफ़ेस के माध्यम से परिवेश से अविश्वसनीय डेटा को एजेंट की संवेदनशील कार्रवाइयों तक पहुँचने से रोकता है; Lean 4 में सत्यापित दो प्रमेय और समुदाय के निर्णयों का संचय, किसी एक उपयोगकर्ता पर भार बढ़ाए बिना, विषाक्तकरण के जोखिम को घटाते हैं। Trojan Hippo और τ²-bench पर किए गए प्रयोगों में, हल्के सत्यापनकर्ताओं के साथ इस योजना ने किसी भी सफल इंजेक्शन को दर्ज नहीं किया और विलंबित कार्यों पर नए एजेंटों के परिणाम बेहतर किए।
20 नवम्बर 2026
सिर और गर्दन के ट्यूमर के लिए प्रोटॉन उपचार-योजना हेतु साक्ष्य-आधारित चक्र वाली संयुक्त मल्टी-एजेंट एआई प्रणाली
यह कार्य प्रशिक्षित PPO नीति, जो योजना के कई विकल्प देती है, और LLM एजेंटों के संयोजन का वर्णन करता है, जो नैदानिक मेट्रिक्स और बाधाओं की जाँच के साथ संवाद के माध्यम से आवश्यकताओं को स्पष्ट करते हैं; 21 रोगियों के डेटा पर Qwen3-14B को फ़ाइन-ट्यून करने से उसने निर्देशों का बेहतर पालन किया और प्राथमिकता वाले लक्ष्यों के पक्ष में समझौते को मोड़ने में मदद की। व्यावहारिक निष्कर्ष यह है कि प्रतिस्पर्धी बाधाओं पर नियंत्रण बनाए रखते हुए स्वचालित DRL योजना को निर्देशित संवाद से पूरक किया जा सकता है।
20 नवम्बर 2026