
SpecEvo: विकासवादी खोज की लागत घटाने के लिए हल्के और उन्नत LLM का समन्वय
SpecEvo फ़्रेमवर्क विकासवादी खोज का पुनर्वितरण करता है: सामान्य उम्मीदवार कम लागत वाले मॉडलों को बेहतर बनाते हैं, जबकि शक्तिशाली मॉडल केवल रणनीतिक नियंत्रण बिंदुओं पर, सफलताओं और गतिरोधों के इतिहास के आधार पर जुड़ते हैं। 176 कार्यों पर किए गए प्रयोगों में, इस तरीके ने API लागत में 80% की कमी करते हुए महंगे विकल्पों के बराबर प्रदर्शन किया या उनसे बेहतर रहा।
कार्य और उद्देश्य
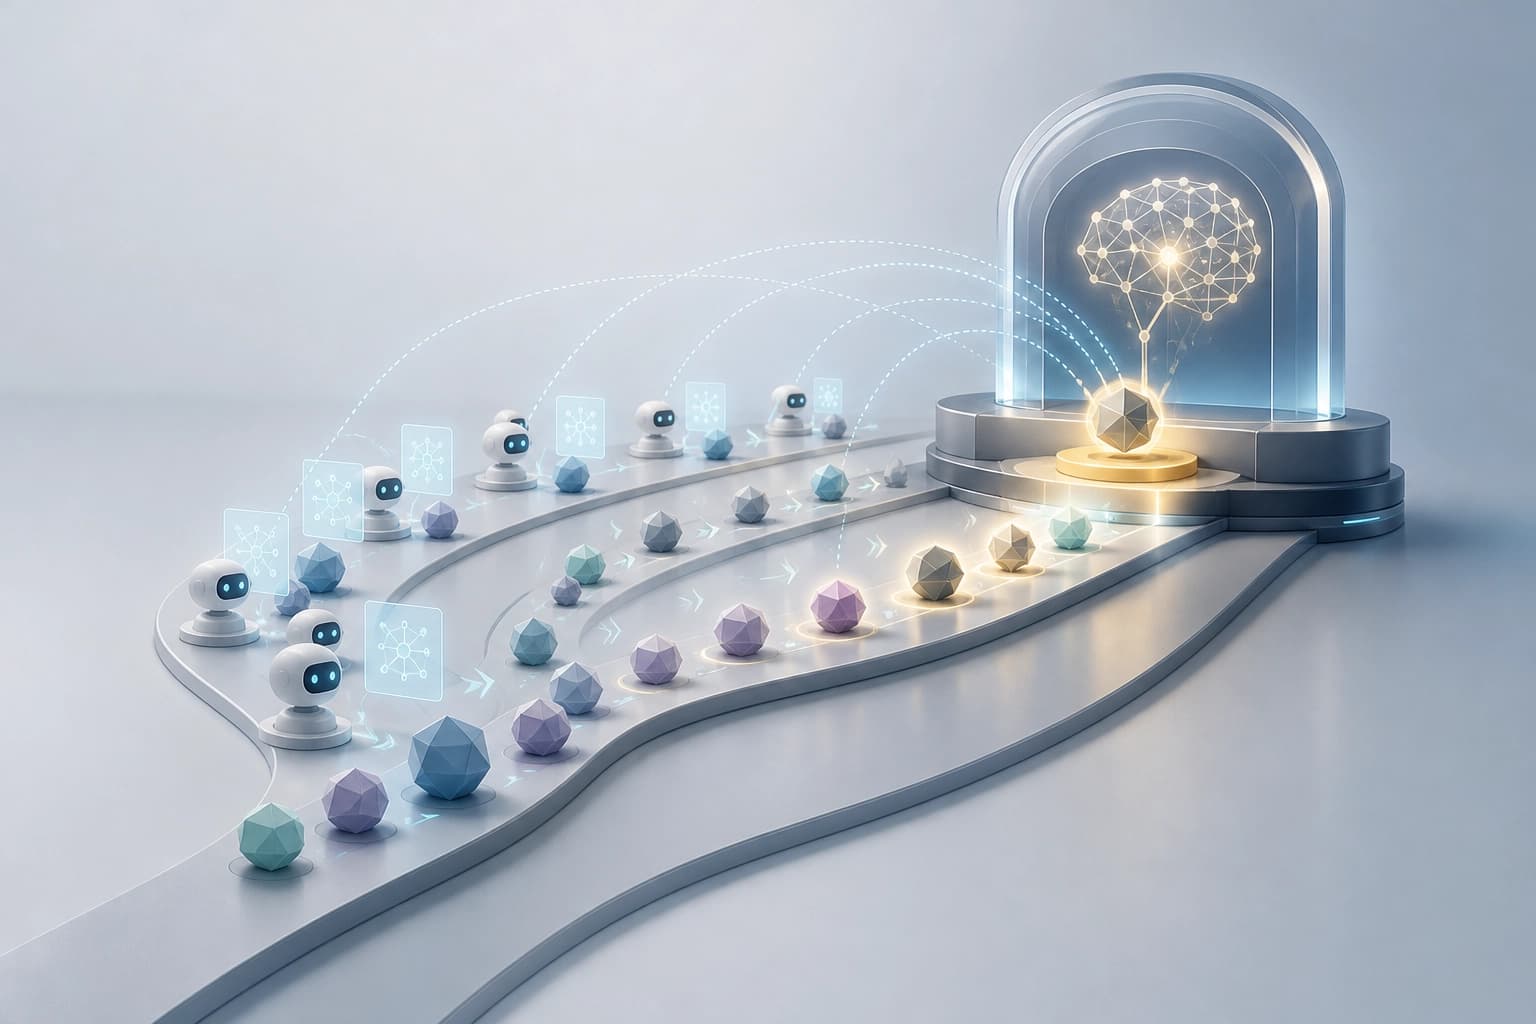
SpecEvo (Speculative Evolution) वैज्ञानिक खोजों के लिए एक मल्टी-LLM फ्रेमवर्क है। यह उम्मीदवार प्रोग्रामों की खोज को कम खर्चीला बनाने के लिए हल्के और उन्नत मॉडलों के बीच समन्वय करता है। arXiv:2610.28706 लेख 20 अक्टूबर 2026 को जमा किया गया था। इसके लेखक Ha Minh Hieu, Tongyao Zhu, Do Xuan Long और Min-Yen Kan हैं।
मुख्य विशेषताएँ:
- प्रकार: मल्टी-LLM फ्रेमवर्क;
- उद्देश्य: वैज्ञानिक खोजें और एल्गोरिद्मिक खोज;
- सिद्धांत: हल्के और उन्नत मॉडलों के बीच समन्वय;
- लेख: arXiv:2610.28706, 20 अक्टूबर 2026 को जमा किया गया;
- लेखक: Ha Minh Hieu, Tongyao Zhu, Do Xuan Long, Min-Yen Kan।
व्यावहारिक मानदंड: उन कार्यों के लिए इस फ्रेमवर्क पर विचार करें जहाँ API की लागत महत्वपूर्ण हो और दुर्लभ जाँच-बिंदुओं के साथ उम्मीदवार प्रोग्रामों की खोज आवश्यक हो।
आर्किटेक्चर: हल्के और उन्नत मॉडलों की भूमिकाएँ
SpecEvo काम को हल्के और उन्नत मॉडलों के बीच बाँटता है। हल्के मॉडल Speculators और Advisor की समानांतर भूमिकाएँ निभाते हैं। उन्नत मॉडल दुर्लभ जाँच-बिंदुओं पर Navigator के रूप में काम करता है।
| घटक | मॉडल का प्रकार | कार्य | काम करने का तरीका | | Speculators | हल्के | उम्मीदवार प्रोग्राम तैयार और परिष्कृत करते हैं | समानांतर रूप से | | Advisor | हल्का | सफलताओं, विफलताओं और संतृप्त हो चुकी दिशाओं का सार प्रस्तुत करता है; उन्हें स्थायी सुझावों में बदलता है | संचित जानकारी का सारांश | | Navigator | उन्नत | विकसित होती आबादी का अध्ययन करता है; संश्लेषण, लक्षित परिष्करण या खोज का दायरा बदलकर हस्तक्षेप करता है | जाँच-बिंदुओं पर, विरले ही |
व्यावहारिक मानदंड: सामान्य खोज और साक्ष्यों का सारांश हल्के मॉडलों को सौंपें, और रणनीतिक हस्तक्षेपों के लिए उन्नत मॉडलों को शामिल करें।
कार्यप्रवाह: «पहले अनुमान, फिर समेकन»
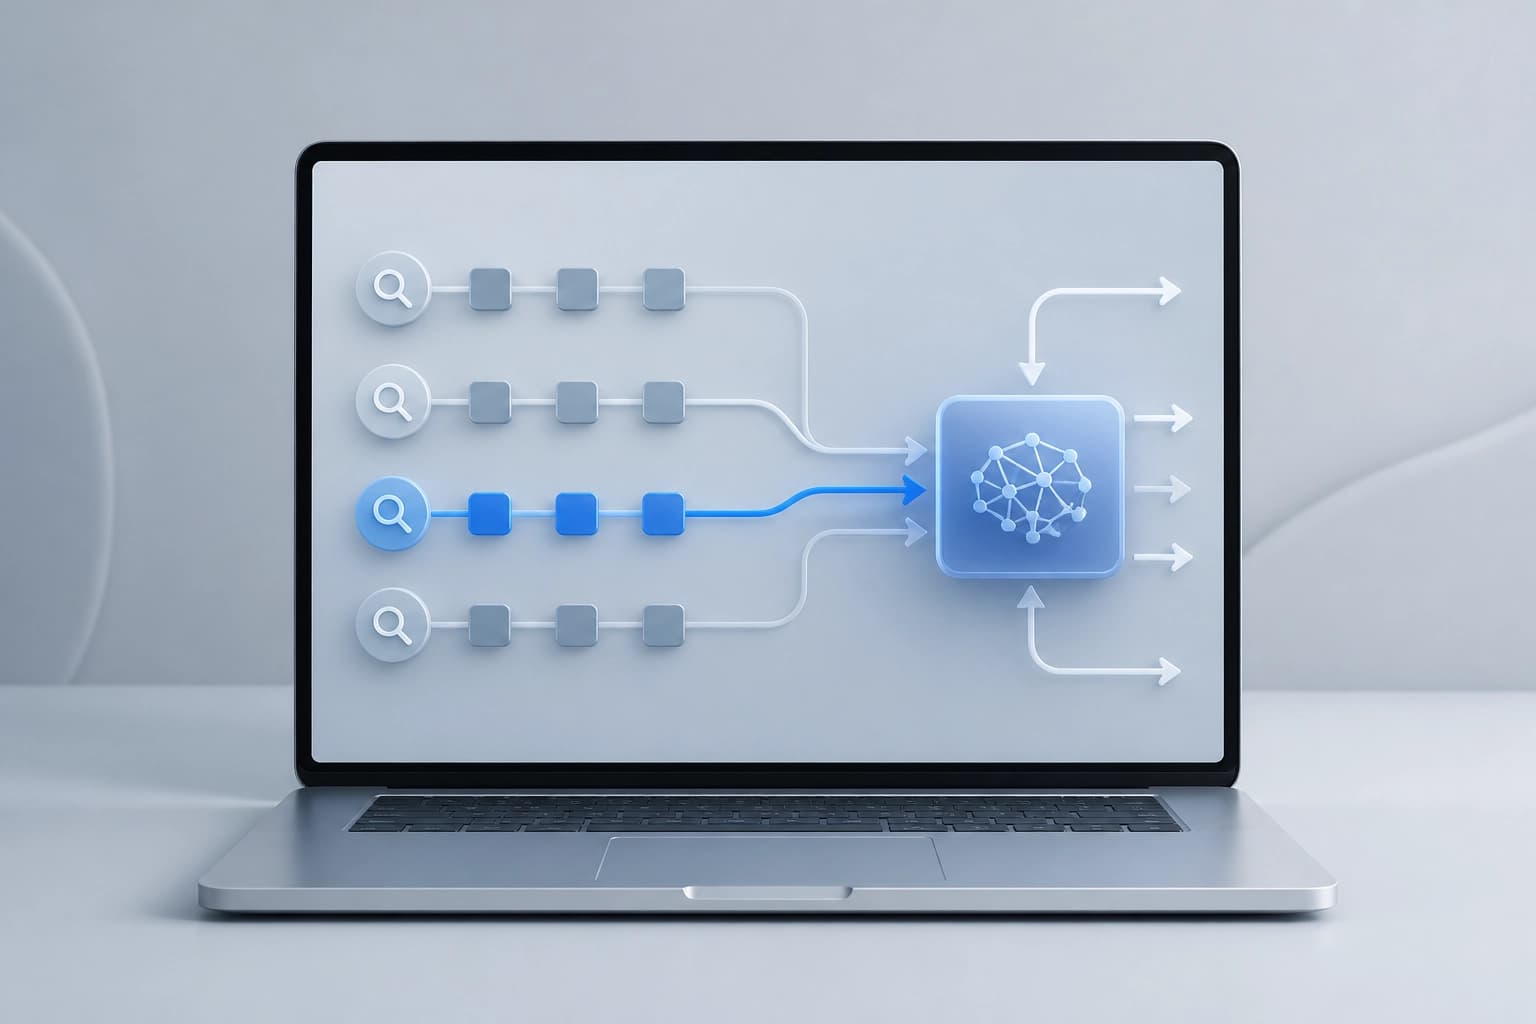
SpecEvo में सामान्य खोज और साक्ष्यों के सारांश का काम कम लागत वाले मॉडलों को सौंपा जाता है। रणनीतिक हस्तक्षेपों के लिए उन्नत मॉडलों को शामिल किया जाता है। उनका लाभ आगे होने वाले कई कम लागत वाले मूल्यांकनों तक पहुँचता है।
चरण:
- हल्के मॉडल उम्मीदवार प्रोग्रामों की सामान्य खोज करते हैं।
- Advisor सफलताओं, विफलताओं और संतृप्त हो चुकी दिशाओं के बारे में संचित जानकारी का सार प्रस्तुत करता है।
- दुर्लभ जाँच-बिंदु पर Navigator आबादी का अध्ययन करता है और हस्तक्षेप का तरीका चुनता है।
- हस्तक्षेप खोज में ठहराव पर निर्भर करता है और इसमें संश्लेषण, लक्षित परिष्करण या खोज का दायरा बदलना शामिल हो सकता है।
- कम लागत वाले मॉडल स्थायी सुझावों को ध्यान में रखते हुए मूल्यांकन जारी रखते हैं।
व्यावहारिक मानदंड: यह तरीका तब उपयुक्त है जब खोज में दुर्लभ जाँच-बिंदु और उनके बीच सुझावों का संचय संभव हो।
परिणाम और आधारभूत तरीकों से तुलना
लेखकों ने वैज्ञानिक और एल्गोरिद्मिक खोज के चार क्षेत्रों के 176 कार्यों पर SpecEvo का परीक्षण किया। फ्रेमवर्क ने उन्नत मॉडलों पर आधारित आधारभूत तरीकों के बराबर या उनसे बेहतर परिणाम दिए। साथ ही, इसने API की लागत 80% तक घटाई। समीकरणों की खोज में फ्रेमवर्क ने लागत-कुशल आधारभूत तरीकों की तुलना में 1,5× तक अधिक मूल्यांकन दक्षता दिखाई। फ्रेमवर्क ने सबसे मज़बूत आधारभूत तरीके CO-Bench को 3,8% से पीछे छोड़ा।
| मापदंड | परिणाम | | उन्नत मॉडलों पर आधारित आधारभूत तरीकों से तुलना | बराबर या बेहतर | | API की लागत में कमी | 80% तक | | समीकरणों की खोज में मूल्यांकन दक्षता | लागत-कुशल आधारभूत तरीकों की तुलना में 1,5× तक अधिक | | CO-Bench से बेहतर प्रदर्शन | 3,8% |
व्यावहारिक चयन मानदंड: अपने कार्यों पर खोज की गुणवत्ता और API की लागत की तुलना आधारभूत तरीकों से करें। लेखकों का निष्कर्ष है कि खोज की दिशा को ध्यान में रखते हुए मॉडलों के बीच समन्वय, लागत-कुशल वैज्ञानिक खोजों का एक प्रभावी तरीका है।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री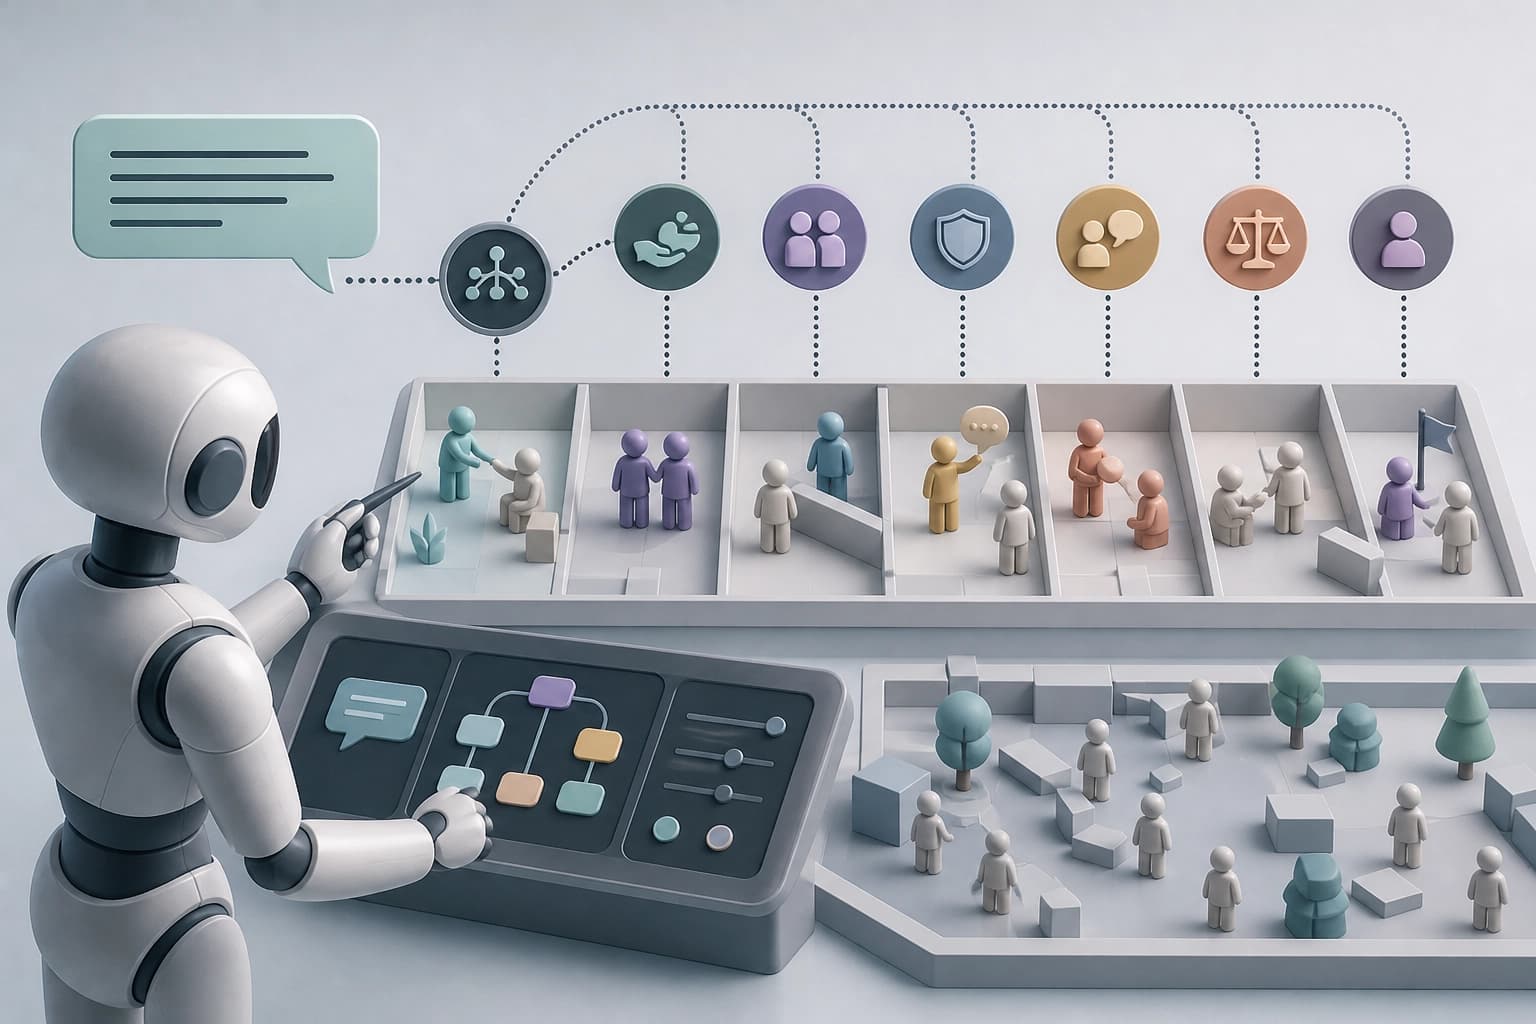
Fig: AI एजेंटों के सामाजिक व्यवहार का परीक्षण करने के लिए नियंत्रित गेम-आधारित हस्तक्षेप
Fig वांछित व्यवहार का मौखिक विवरण प्राप्त करता है, उसे विभिन्न प्रकारों में विभाजित करता है और मॉडलों से अपेक्षित कार्रवाइयाँ करवाने के लिए खेल की स्थितियों में लक्षित बदलाव करता है। छह सामाजिक पैटर्न के वैध परिदृश्यों में, हस्तक्षेपों ने नियंत्रण समूहों की तुलना में लक्षित व्यवहार के प्रयासों का औसत अनुपात 10,9% बढ़ाया। लेखक बहु-एजेंट परिवेशों को पुनरुत्पाद्य मूल्यांकन के लिए एक समायोज्य परीक्षण मंच के रूप में देखने का सुझाव देते हैं।
21 नवम्बर 2026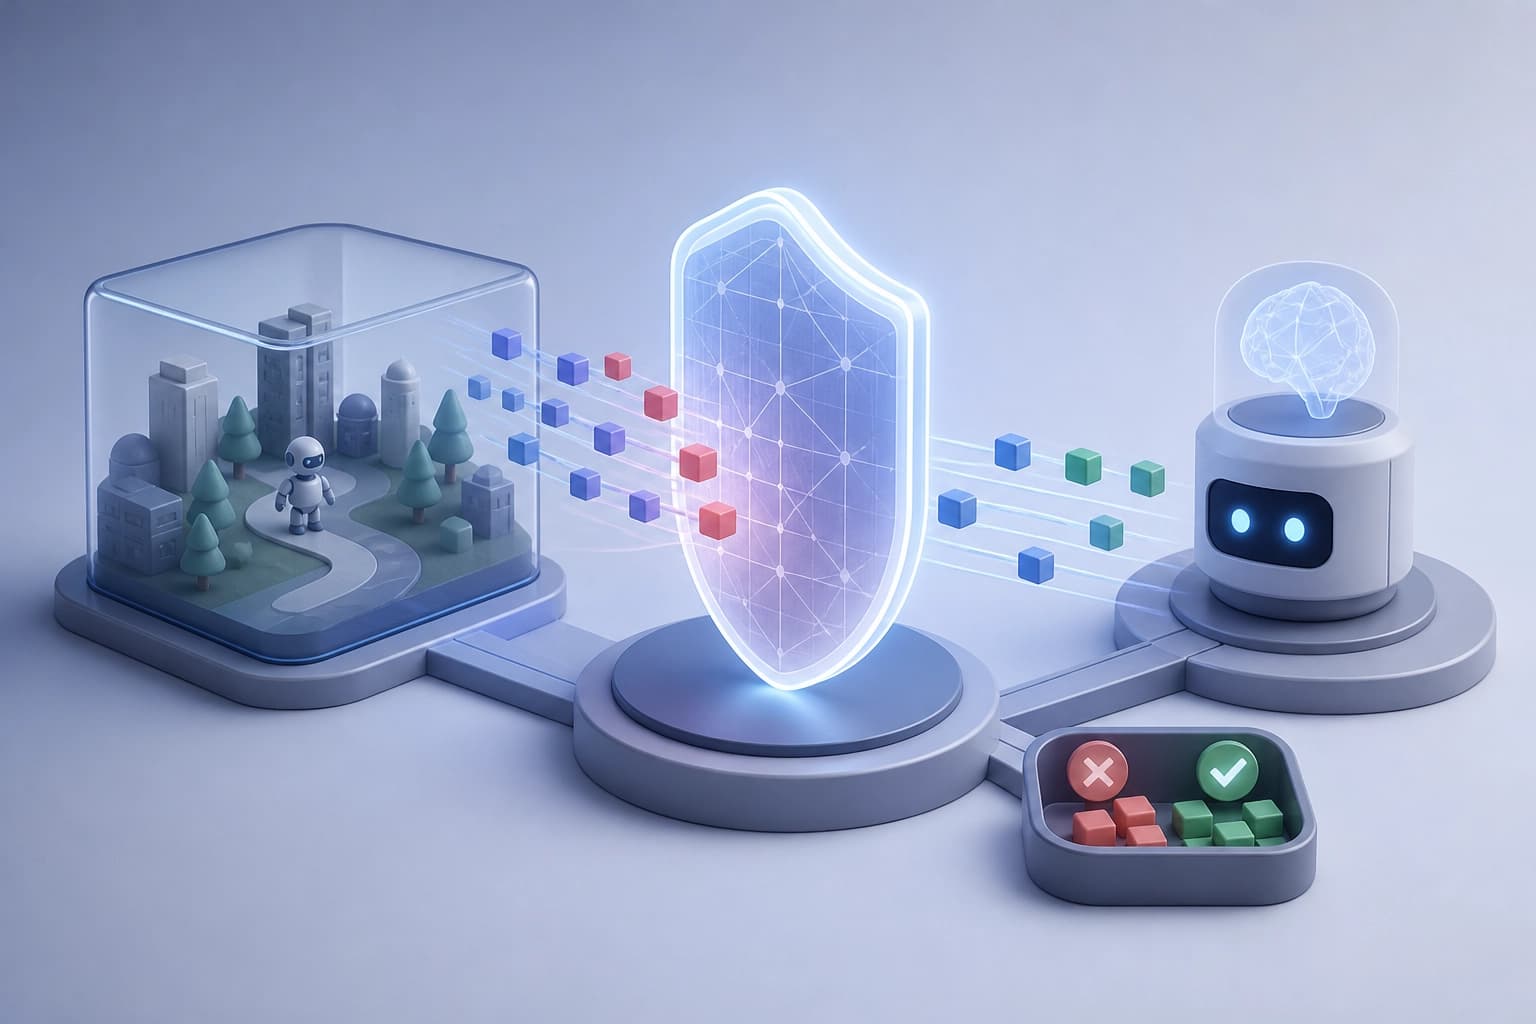
प्रॉम्प्ट पर निर्भर हुए बिना एजेंट नीतियों का सत्यापन: निष्पादन योग्य वातावरण, परीक्षण सूट और प्रशिक्षित किया जा सकने वाला फ़िल्टर
यह कार्य एक ऐसा फ्रेमवर्क प्रस्तुत करता है जो निष्पादन परिवेशों को एजेंट नीतियों की जाँच के लिए परिदृश्यों के सेट में बदलता है और सुरक्षा घटक को क्रमिक रूप से बेहतर बनाने की अनुमति देता है। प्रशिक्षित फ़िल्टर, केवल प्रॉम्प्ट निर्देशों पर निर्भर रहने की तुलना में, सफल उल्लंघनों के अनुपात को 40–44% तक कम करता है और सुरक्षित अनुरोधों को गलत तरीके से कम अस्वीकार करता है।
20 नवम्बर 2026
PerMIT: LLM एजेंटों की दीर्घकालिक स्मृति की अखंडता और मशीन-सत्यापन के साथ सामूहिक विश्वास
लेखक PerMIT आर्किटेक्चर प्रस्तुत करते हैं, जो एक सीमित मेमोरी इंटरफ़ेस के माध्यम से परिवेश से अविश्वसनीय डेटा को एजेंट की संवेदनशील कार्रवाइयों तक पहुँचने से रोकता है; Lean 4 में सत्यापित दो प्रमेय और समुदाय के निर्णयों का संचय, किसी एक उपयोगकर्ता पर भार बढ़ाए बिना, विषाक्तकरण के जोखिम को घटाते हैं। Trojan Hippo और τ²-bench पर किए गए प्रयोगों में, हल्के सत्यापनकर्ताओं के साथ इस योजना ने किसी भी सफल इंजेक्शन को दर्ज नहीं किया और विलंबित कार्यों पर नए एजेंटों के परिणाम बेहतर किए।
20 नवम्बर 2026