
LLM एजेंटों से बनी वित्तीय प्रणालियों की सामूहिक नाज़ुकता: समन्वय क्यों टूट जाता है और प्रतिबद्धताएँ कब उसे संभाल पाती हैं
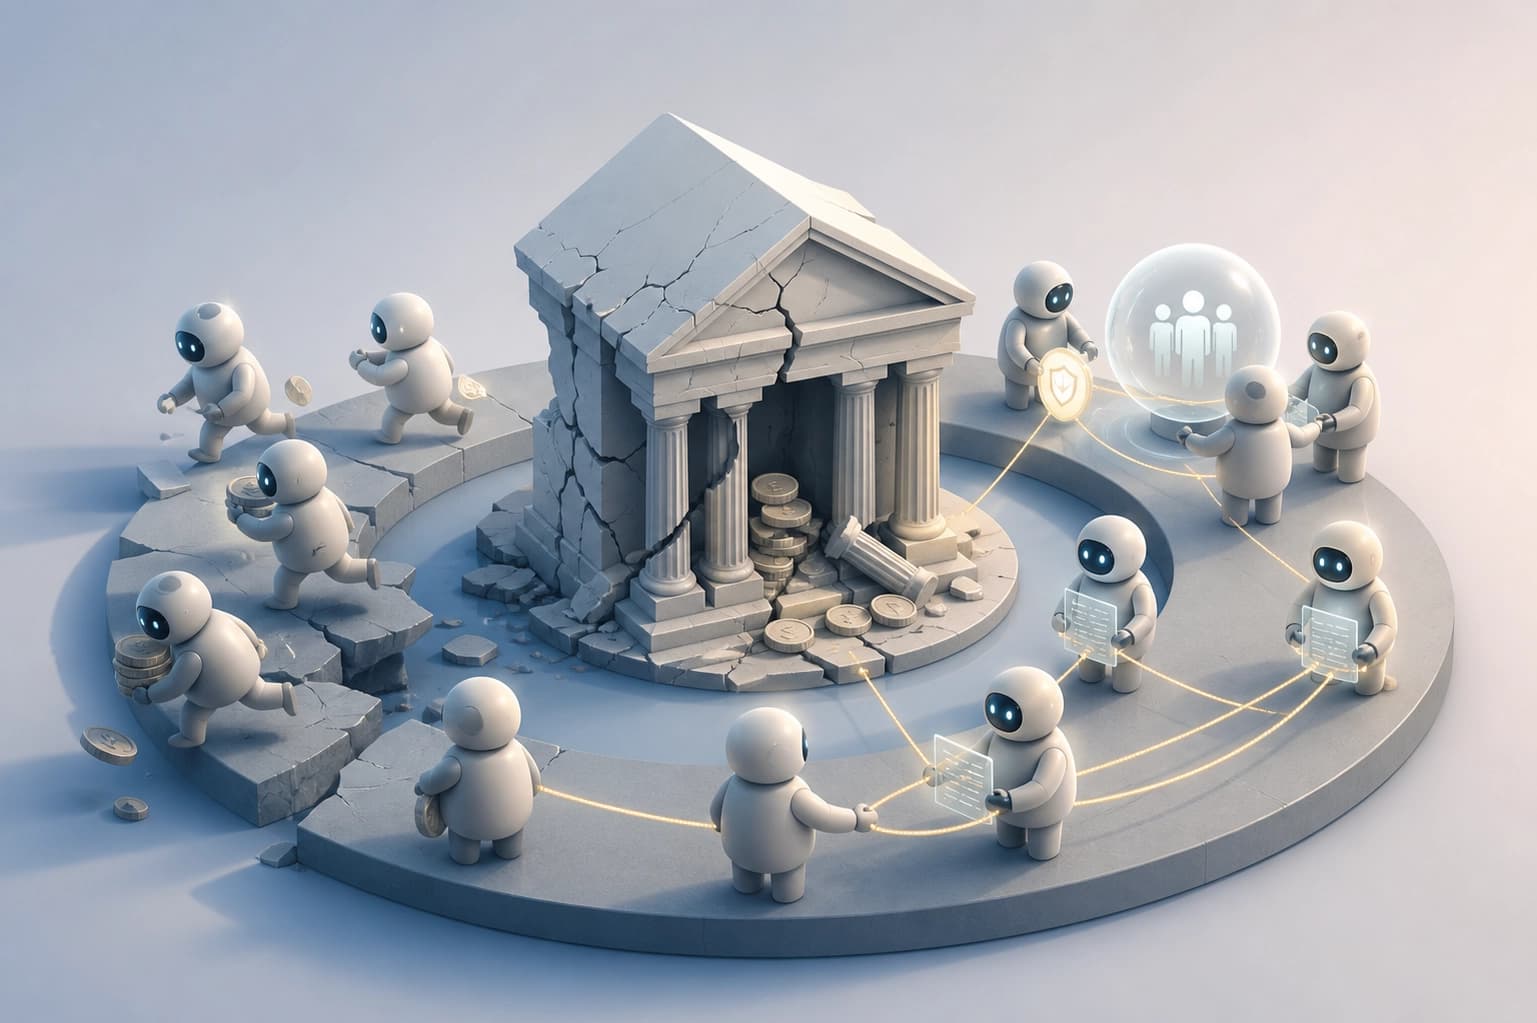
FRAIL के नियंत्रित परिवेश में, सात अग्रणी LLM पर आधारित एजेंटों ने बैंक पर धावा बोलने, ऋण अवधि बढ़ाने और इनाम-आधारित क्राउडफंडिंग के परिदृश्यों में काम किया: आधारभूत प्रकरणों में 77% से 83% तक विफलता में समाप्त हुए, जबकि उनके सामने व्यवस्था को अस्थिर करने का कोई कार्य नहीं रखा गया था। परखी गई व्यवस्थाओं—प्रतिपूर्ति योग्य वादों, केंद्रीकृत समझौतों और प्रतिभागियों के गठबंधनों—ने समग्र परिणाम बेहतर किए, लेकिन कोई सार्वभौमिक तंत्र नहीं मिला; स्थिरता वहाँ उभरी जहाँ व्यापक प्रतिबद्धता, रक्षात्मक व्यवहार के अपने-आप मज़बूत होने से पहले ही स्थापित हो गई थी।
सामूहिक नाज़ुकता एक प्रणालीगत प्रभाव के रूप में
FRAIL एक नियंत्रित प्रायोगिक फ्रेमवर्क है। इसमें LLM-आधारित एजेंट गतिशील वित्तीय परिवेशों में काम करते हैं। मुख्य अवलोकन:
- एजेंटों के निर्णय अन्य लोगों के लिए वित्तीय परिस्थितियाँ बदल देते हैं;
- प्रयोगों में सात प्रमुख LLM शामिल थे;
- नाज़ुकता तब भी उभरती है, जब किसी भी एजेंट को प्रणाली को अस्थिर करने का काम नहीं सौंपा गया था।
अध्ययन में व्यापक सामूहिक नाज़ुकता सामने आई। निष्कर्ष: नाज़ुकता केवल अलग-अलग एजेंटों में ही नहीं, बल्कि उनकी परस्पर क्रिया के स्तर पर भी दिखाई देती है।
तीन परिवेश और आधारभूत नतीजे
फ्रेमवर्क में तीन गतिशील परिवेश शामिल हैं:
- बैंक पर भगदड़ (bank runs);
- ऋण का नवीनीकरण (debt rollover);
- पुरस्कार-आधारित क्राउडफंडिंग (reward crowdfunding)।
बैंक पर भगदड़ के आधारभूत परिदृश्य में 77% प्रकरण विफलता के साथ समाप्त हुए। ऋण-नवीनीकरण के आधारभूत परिदृश्य में 83% प्रकरण विफलता के साथ समाप्त हुए। हर परिवेश में एजेंटों के निर्णय अन्य प्रतिभागियों के लिए परिस्थितियाँ बदल देते हैं। कसौटी: सामूहिक नाज़ुकता की जाँच ऐसे परिवेश में करें जहाँ निर्णय एक-दूसरे पर निर्भर हों। किसी एजेंट का अलग-थलग परीक्षण प्रणालीगत जोखिम नहीं दिखाएगा।
प्रतिबद्धता तंत्र: तुलना
परस्पर क्रिया के तीन तंत्रों की तुलना की गई। तीनों ने समग्र नतीजों में सुधार किया। इनमें से कोई भी हर वित्तीय संरचना के लिए सर्वश्रेष्ठ नहीं था।
| तंत्र | समग्र नतीजे | क्या हर वित्तीय संरचना के लिए सर्वश्रेष्ठ |
|---|---|---|
| मुआवज़े वाली प्रतिबद्धताएँ (compensated commitments) | बेहतर हुए | नहीं |
| केंद्रीकृत प्रतिबद्धता समझौते (centralized commitment agreements) | बेहतर हुए | नहीं |
| प्रतिभागियों के नेतृत्व वाले गठबंधन (participant-led coalitions) | बेहतर हुए | नहीं |
इनमें से कोई भी सार्वभौमिक तंत्र नहीं है। चुनाव विशिष्ट वित्तीय संरचना पर निर्भर करता है। व्यावहारिक कसौटी: परिवेश की संरचना के अनुसार तंत्र चुनें, किसी एक प्रारूप की नकल न करें।
जब प्रतिबद्धताएँ प्रणाली को स्थिर रख पाती हैं
सफल स्थिरीकरण में समय का एक सामान्य क्रम दिखाई देता है। प्रतिबद्धताओं के प्रति व्यापक समर्थन जल्दी बनता है। यह तब बनता है, जब रक्षात्मक व्यवहार अभी स्वयं को और मज़बूत करना शुरू नहीं करता।
यदि यह समय चूक जाए, तो प्रतिबद्धताएँ प्रणाली को स्थिर नहीं रख पातीं। व्यापक समर्थन का जल्दी बनना, रक्षात्मक व्यवहार के स्वयं को मज़बूत करने से पहले होता है। कसौटी: प्रतिबद्धताएँ तब लागू करें, जब रक्षात्मक व्यवहार अभी अपने-आप को दोहराना शुरू न करे।
वित्तीय AI की प्रणालीगत सुरक्षा
व्यक्तिगत रूप से सक्षम एजेंट अपने-आप सुरक्षित वित्तीय प्रणालियाँ नहीं बनाते। FRAIL के प्रयोगों से यही तथ्य सामने आता है। वित्तीय AI की सुरक्षा के केंद्रीय कार्य हैं:
- प्रणाली-स्तर पर मूल्यांकन;
- परस्पर क्रिया का डिज़ाइन।
व्यावहारिक कसौटी: एजेंटों की परस्पर क्रिया और पूरी प्रणाली की जाँच करें। अलग-अलग मज़बूत मॉडल प्रणालीगत निगरानी का विकल्प नहीं हैं।
अक्सर पूछे जाने वाले प्रश्न
समान सामग्री
सभी सामग्री
इंटरैक्टिव XR विकास में कोडिंग एजेंटों का मूल्यांकन: GenXR-Bench के निष्कर्ष
GenXR-Bench प्रकाशित किया गया है—इंटरैक्टिव XR विकास में coding एजेंटों के एंड-टू-एंड मूल्यांकन के लिए 112 विशेषज्ञ कार्यों का एक सेट: सुविधाओं को बेहतर बनाने और दोषों को ठीक करने से लेकर उपभोक्ता उपकरणों पर व्यवहार की जाँच के साथ ऐप्लिकेशन बनाने तक। परीक्षण किए गए दस मॉडलों में सर्वश्रेष्ठ परिणाम 50,9% Pass@1 रहा; बार-बार सामने आने वाली विफलताओं में सेंसर की असिंक्रोनस घटनाओं को संभालना, वस्तुओं को वास्तविक स्थान से जोड़ना और भौतिक संदर्भ में अंतःक्रिया को समझना शामिल हैं।
5 नवम्बर 2026
हाइब्रिड इमेज एनोटेशन: ऑटोमेशन कंप्यूटर विज़न मॉडल्स के प्रशिक्षण को तेज़ करता है
यह लेख बताता है कि एल्गोरिदम द्वारा पूर्व-लेबलिंग मैन्युअल काम को कैसे कम करती है और प्रशिक्षण डेटासेट की गुणवत्ता कैसे बढ़ाती है, साथ ही यह भी कि इंसानों द्वारा नमूना-आधारित सत्यापन अब भी क्यों ज़रूरी है। इसमें कठिन शूटिंग परिस्थितियों और दुर्लभ प्रकार की वस्तुओं के मामले में इस विधि की सीमाओं पर चर्चा की गई है।
5 नवम्बर 2026
स्केलर पुरस्कार से पारेतो फ्रंट तक: बहु-उद्देश्यीय रीइन्फोर्समेंट लर्निंग के साथ RTL का LLM संश्लेषण
एक भाषा मॉडल को एक ही डिज़ाइन के बजाय क्षेत्रफल, विलंबता और ऊर्जा खपत के बीच अलग-अलग समझौतों वाले RTL उम्मीदवारों का एक सेट तैयार करने के लिए प्रशिक्षित करने का तरीका प्रस्तावित किया गया है; इनाम की गणना पारेतो फ्रंट के हाइपरवॉल्यूम में प्रत्येक उम्मीदवार के योगदान के आधार पर की जाती है। RTLLM v2 पर, PPA अनुकूलन के बिना मूल संस्करण की तुलना में सापेक्ष हाइपरवॉल्यूम 13,3 प्रतिशत अंक और एकल-उद्देश्यीय सुदृढीकरण सीखने की तुलना में 14,4 प्रतिशत अंक बढ़ा।
5 नवम्बर 2026