
एन्कोडर का चुनाव गलत मेट्रिक पर किया जाता है
फ्रोज़न एन्कोडर आमतौर पर प्रोजेक्ट में एक ही चीज़ देखकर लिया जाता है: उसके प्रतिनिधित्वों के ऊपर एक हल्का हेड — लीनियर लेयर, छोटा MLP, ऐसा ही कुछ — कितनी अच्छी तरह ट्रेन होता है। अगर साधारण हेड आवश्यक फ़ीचर निकाल लेता है, तो एन्कोडर को सफल मान लिया जाता है। लेकिन यह मूल्यांकन इस सवाल का जवाब देता है कि "इन एम्बेडिंग्स से कुछ पढ़ना सुविधाजनक है या नहीं", न कि इस सवाल का कि "क्या फ़ीचर को स्पेस की ज्यामिति खुद अलग करती है"। ये दो अलग सवाल हैं, और इन्हें मिलाना महँगा पड़ता है: जब तक कार्य सरल हैं और क्लासें कम हैं, हेड प्रतिनिधित्व की कमज़ोरी को छिपा देता है।
अलग से संतुलन की समस्या भी है। जब तक क्लासें लगभग बराबर हैं, "एन्कोडर कर सकता है" और "हेड निकाल लेता है" के बीच का अंतर लगभग दिखता ही नहीं। जैसे ही कोई एक क्लास दुर्लभ हो जाता है, निकटतम पड़ोसियों पर आधारित मेट्रिक्स systematically झूठ बोलने लगती हैं।
निकटतम पड़ोसियों पर आधारित डिस्कॉर्डेंस क्यों झूठ बोलता है
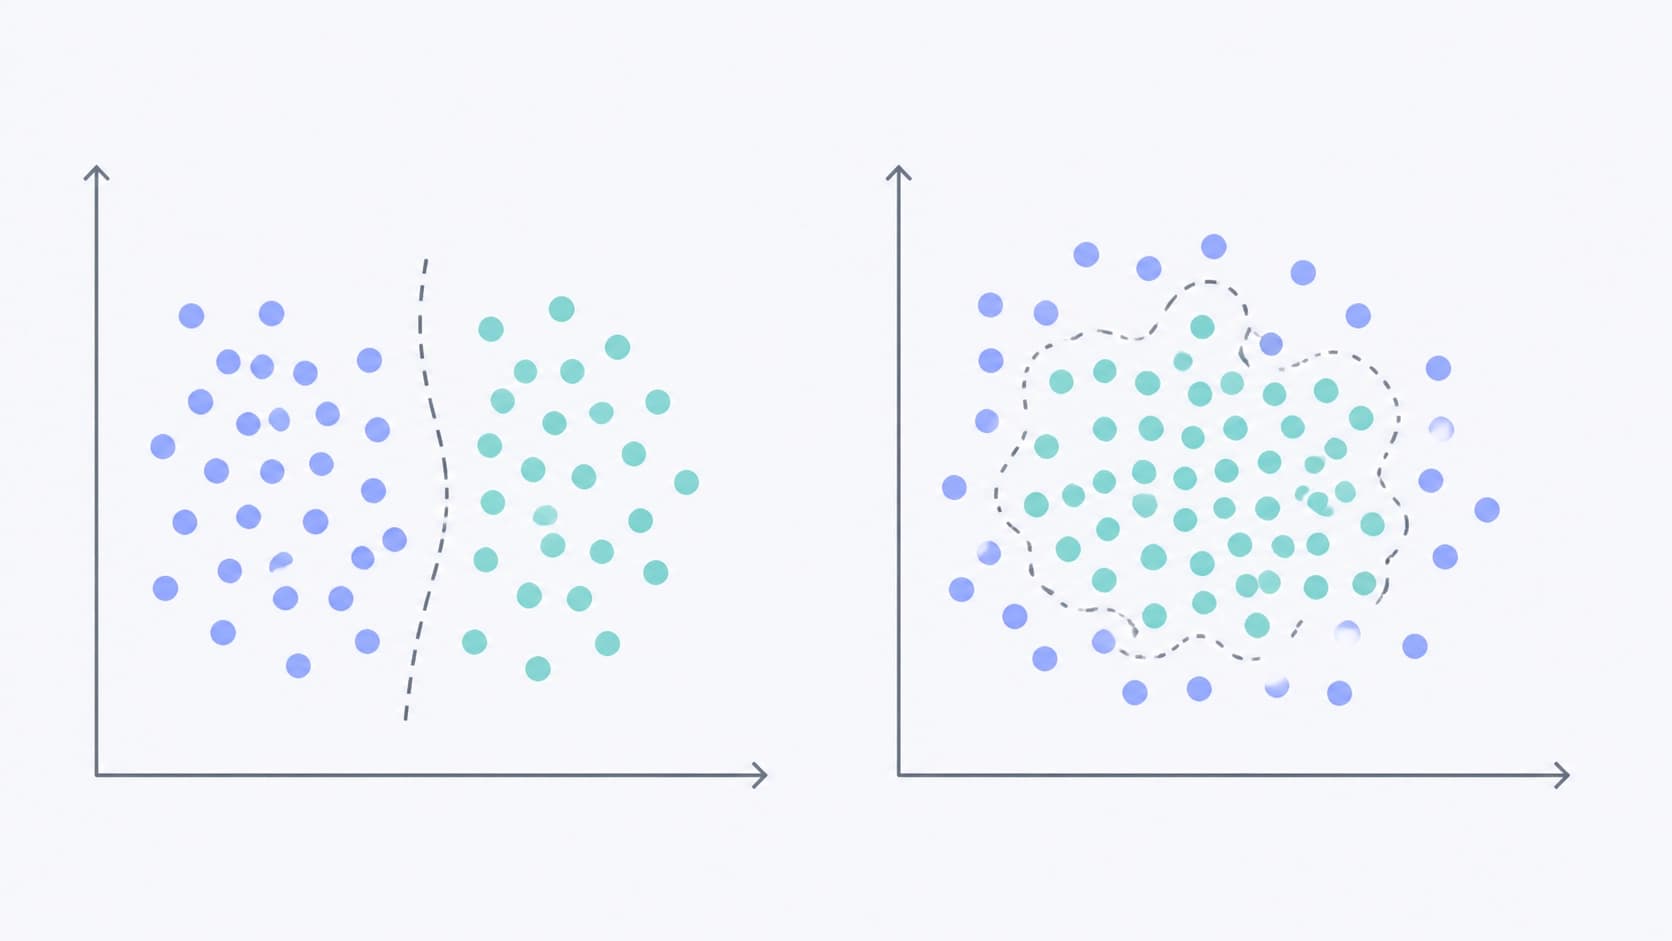
क्लासिक डिस्कॉर्डेंस मेट्रिक सरल है: हर बिंदु के लिए एम्बेडिंग स्पेस में पड़ोसी खोजे जाते हैं, और अगर निकटतम पड़ोसी की लेबल विपरीत है — तो मामले को डिस्कॉर्डेंट दर्ज किया जाता है। एक ही क्लास के भीतर ज्यामिति बहुत अच्छी तरह काम करती है, पड़ोसियों पर कोई शिकायत नहीं।
समस्या प्रक्रिया की असममिति में है। जब सकारात्मक और नकारात्मक उदाहरणों के लिए पड़ोसी अलग-अलग आकार के समुच्चयों से चुने जाते हैं, तो विपरीत लेबल वाला निकटतम पड़ोसी इसलिए नहीं जीतता कि ज्यामिति ऐसी है, बल्कि इसलिए कि उसका क्लास आस-पास में ज़्यादा घना है। दूसरे शब्दों में, परिणाम में क्लास की व्यापकता (prevalence) रिस आ जाती है — यह डेटासेट की सांख्यिकी है, प्रतिनिधित्व का गुण नहीं। असर अप्रिय है: पूरी तरह अनभिज्ञ एन्कोडर अंधा दिखने लगता है, जबकि असल में वह उतना ही बेकार है जितना एक ईमानदार सिक्का, और उससे बुरा नहीं।
CANDOR असल में क्या बदलता है
CANDOR — Chance-Calibrated Discordance in Frozen Foundation Encoders — गणना की प्रक्रिया को ही फिर से परिभाषित करता है। यहाँ पड़ोसी बैंक बराबर आकार के चुने जाते हैं, और मेट्रिक की बनावट लेबलों की अदला-बदली के प्रति सममित है: सकारात्मक और नकारात्मक को आपस में बदल दें, तो मान नहीं बदलेगा। परिणामस्वरूप, यादृच्छिक अनुमान का स्तर ठीक एक-बटा-दो — 50% — पर तय है। "लगभग आधे के आसपास, डेटासेट पर निर्भर" नहीं, बल्कि 1/2 पर एक सख्त संदर्भ बिंदु।
यह कोई सौंदर्यात्मक सुधार नहीं है। यही अस्थिर संदर्भ बिंदु एन्कोडरों की आपस में और डेटासेटों के बीच तुलना में बाधा डालता था: जहाँ असंतुलन ज़्यादा था, वहाँ यादृच्छिक अनुमान अपने असली स्तर से बुरा दिखता था, और मॉडल को अनुचित भरोसा मिल जाता था। जब संदर्भ स्थिर हो जाता है, तुलना ईमानदार हो जाती है।
और एक और बात, जो व्यवहार के लिए ज़रूरी है: चूँकि संदर्भ बिंदु निश्चित है, CANDOR को किसी भी हेड के ट्रेनिंग से पहले निकाला जा सकता है। कोई फ़ाइनट्यूनिंग नहीं, कोई हाइपरपैरामीटर ट्यूनिंग नहीं — मेट्रिक खुद प्रतिनिधित्वों का वर्णन करती है और पहले से बता देती है कि कोई विशेष फ्रोज़न एन्कोडर किन खोजों को खराब तरीके से सपोर्ट करता है।
बड़े पैमाने पर जाँच
लेखकों ने मूल्यांकन व्यापक रूप से चलाया: 22 एन्कोडर, 7 विषय-क्षेत्रों के 20 डेटासेट, कुल 605,443 इमेज। इतनी व्यापकता इसलिए ज़रूरी थी ताकि मेट्रिक के असर को किसी एक कार्य की विशेषताओं से अलग किया जा सके।
नतीजा उस निष्कर्ष को पलट देता है, जिस पर पुरानी प्रक्रिया पहुँचाती थी। सुधार के बाद प्रतिनिधित्व का कोलैप्स लगभग हर जगह यादृच्छिक अनुमान के स्तर से नीचे निकलता है। इसे ऐसे पढ़ा जा सकता है: जाँचे गए एन्कोडरों में से कोई भी अंधा नहीं है — प्रतिनिधित्वों में फ़ीचर की जानकारी मौजूद है — लेकिन वे सभी कमज़ोर हैं। "सभी कमज़ोर हैं, कोई अंधा नहीं" वाक्य पहले वाले से नरम लगता है, और साथ ही वास्तविकता का कहीं ज़्यादा सटीक वर्णन करता है।
क्लिनिकल उदाहरण: कमज़ोर ज्यामिति के साथ मज़बूत हेड
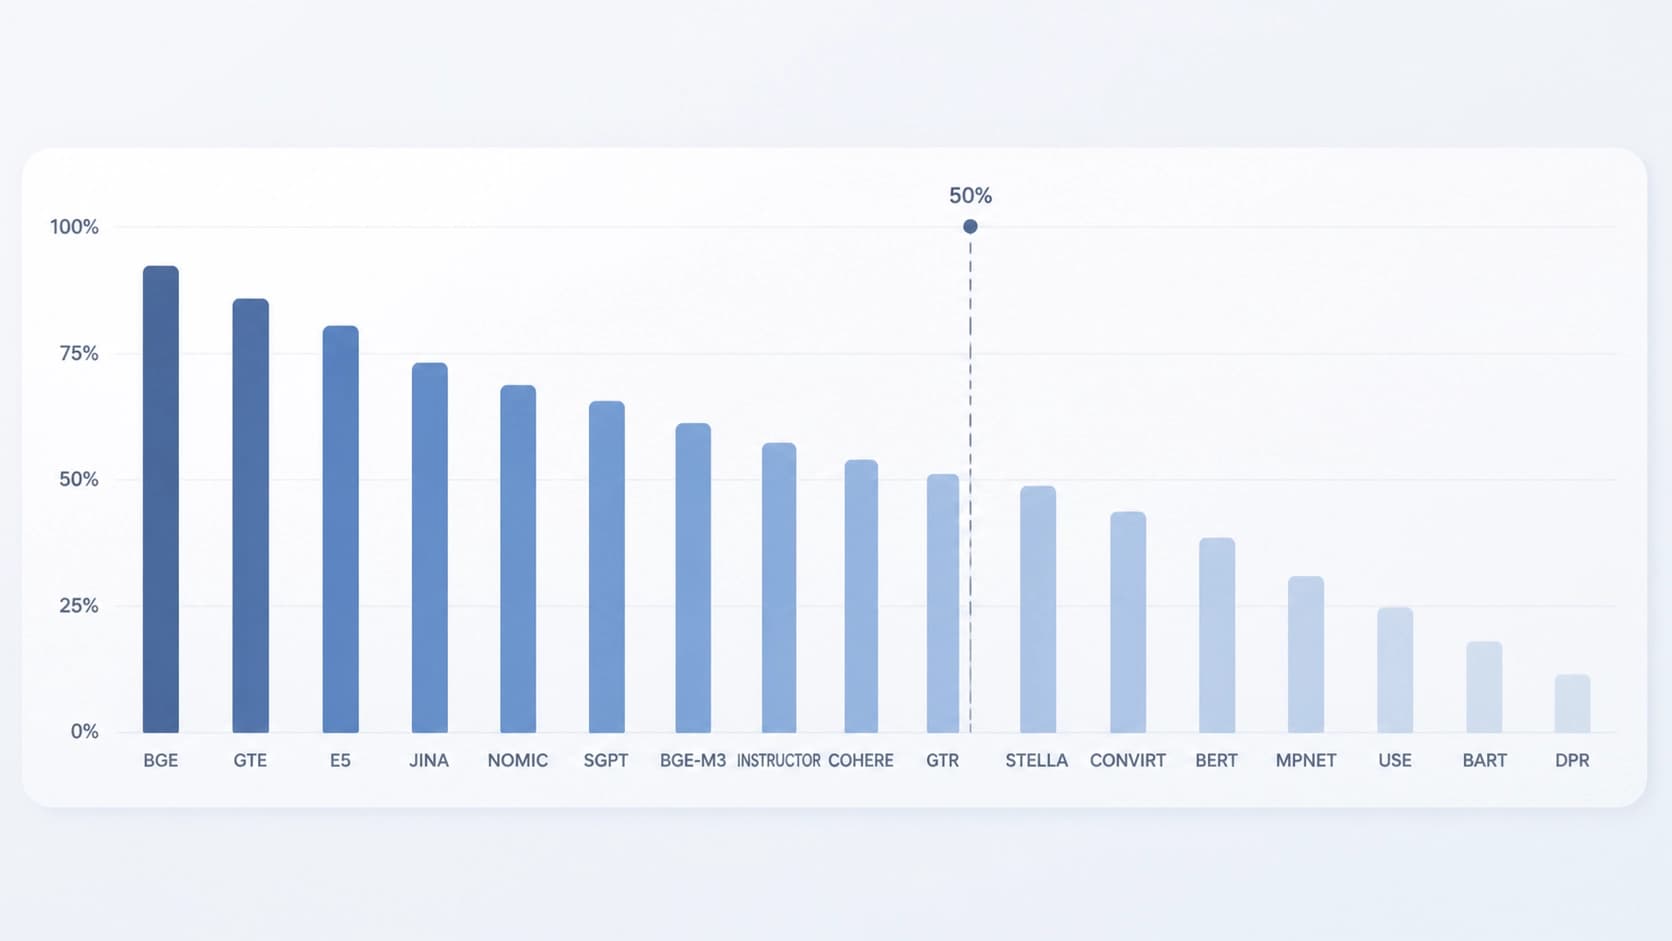
सबसे स्पष्ट उदाहरण मेडिकल इमेजिंग का है। चेस्ट के लिए सबसे अच्छा मॉडल न्यूमोथोरैक्स को AUROC 84.5 के साथ पढ़ता है। आँकड़ा ठोस है, और मॉडल चुनते समय आमतौर पर इसी को देखा जाता है। लेकिन वही मॉडल 18.4% सकारात्मक मामलों को विपरीत लेबल वाली इमेज के ज़्यादा करीब रखता है, बजाय उसी फ़ाइंडिंग वाली अपनी इमेज के — और यह एक ही अस्पताल के भीतर है, यानी स्पष्टीकरण के तौर पर डोमेन शिफ्ट के बिना।
"हेड कार्य अच्छी तरह हल करता है" और "ज्यामिति सकारात्मक-नकारात्मक को उलझा देती है" के बीच का अंतर — यही वह विरोधाभास है। हेड कमज़ोर प्रतिनिधित्व की भरपाई करता है; CANDOR मेट्रिक दिखाती है कि भरपाई बहुत ज़्यादा करनी पड़ती है।
आगे — डोमेनों के बीच तुलना। वही एन्कोडर पक्षियों की प्रजातियों को 4.5 के स्तर पर अलग करता है (यानी लगभग पूर्ण रूप से), जबकि चेस्ट की फ़ाइंडिंग्स को 42.8 पर, ग्लूकोमा को 49.8 पर छोड़ देता है। आख़िरी संख्या यादृच्छिक अनुमान के स्तर पर है, और असल में — यादृच्छिक वज़नों से भी बुरी। एक एन्कोडर, एक ट्रेनिंग, तीन बिल्कुल अलग ज्यामिति गुणवत्ताएँ।
जानकारी की नहीं, चयन की कमी
इससे एक स्वाभाविक सवाल उठता है: तो क्या प्रतिनिधित्व निराशाजनक हैं? बिल्कुल नहीं। यादृच्छिकता किसी भी लिपशिट्ज़ हेड — यानी सीमित इनपुट-संवेदनशीलता वाले हेड — के नॉर्मलाइज़्ड मार्जिन को सीमित करती है। हालाँकि ग्यारह हेडों के समुच्चय के भीतर एक ऐसा हेड मिलता है जो 2.8% के अलावा सभी मामलों में सही होता है, जबकि अकेले लिया गया हेड 35.9% में चूकता है। प्रतिनिधित्व में फ़ीचर की जानकारी मौजूद है — बस वह अलग-अलग पढ़ने वाले उपकरणों के लिए समान रूप से उपलब्ध नहीं है। यानी कमी चयन (selection) से जुड़ी है, जानकारी के अभाव से नहीं।
एक दिलचस्प संबंध कहीं और भी मिला: इरेज़र रिटेंशन (erasure retention) कोलैप्स से जुड़ा है। लेकिन ट्रेनिंग उद्देश्य, मॉडल का पैमाना, रिलीज़ की ताज़गी या फ़ाइंडिंग के आकार से कोई संबंध नहीं मिला। सीधे शब्दों में, "बड़ा और नया मॉडल ले लो" समस्या का समाधान नहीं है — यह न आकार के बारे में है, न उम्र के।
व्यवहार में इससे क्या निकलता है
तीन व्यावहारिक निष्कर्ष।
- हेड की ट्रेनिंग से पहले CANDOR निकालें। यह एक सस्ती जाँच है जो दिखाती है कि एन्कोडर किसी विशेष दुर्लभ फ़ाइंडिंग को सपोर्ट करता है या नहीं, और आपको ट्यूनिंग में समय बर्बाद करने से पहले अनुपयुक्त बैकबोन छाँटने देती है।
- हेड के AUROC को प्रतिनिधित्व की गुणवत्ता से न मिलाएँ। 18.4% डिस्कॉर्डेंट सकारात्मक के साथ 84.5 — यह सामान्य, दुर्लभ नहीं, स्थिति है, और इसे अलग से मापने लायक है।
- यह न सोचें कि पैमाना और नयापन सब ठीक कर देंगे। आकार, ट्रेनिंग उद्देश्य और ताज़गी से कोई संबंध नहीं मिला; फ्रोज़न एन्कोडरों की कमज़ोरी प्रणालीगत लगती है।
इस कहानी की असली कीमत मेट्रिक में भी नहीं, बल्कि पलटे हुए निष्कर्ष में है। पहले लगता था कि एन्कोडर अलग-अलग क्लासों के प्रति "अंधे" हैं। चांस के अनुसार कैलिब्रेशन के बाद कुछ और दिखता है: वे लगभग हर जगह देखते हैं, लेकिन हर जगह कमज़ोर तरीके से। यह कहीं कम नाटकीय और कहीं ज़्यादा काम का चित्र है — इसके साथ साफ़ है कि क्या ठीक करना है और किस क्रम में।


