
Les humains sont compréhensibles, les LLM ne le sont pas : les experts n'ont pas pu expliquer la logique des modèles
Les chercheurs ont comparé les facteurs latents sous-jacents aux réponses d'humains et de six modèles de langage à des tâches de raisonnement quantitatif et de chimie. Les facteurs extraits des réponses humaines ont été interprétés avec succès par des experts, tandis que la plupart des constructions des modèles se sont révélées opaques pour eux.
Les humains sont compréhensibles, les LLM non : les experts n'ont pas pu expliquer la logique des modèles
Lorsque nous regardons les résultats des tests, il semble naturel de supposer que l'intelligence artificielle résout les problèmes « comme un humain » : en utilisant les mêmes concepts, règles et raisonnements. Cependant, une nouvelle étude remet en question cette hypothèse. Les scientifiques ont découvert que les structures cachées qui déterminent les réponses des LLM, dans la plupart des cas, ne se prêtent pas à une interprétation humaine — même pour des experts du domaine.
Ce qui a été exactement vérifié
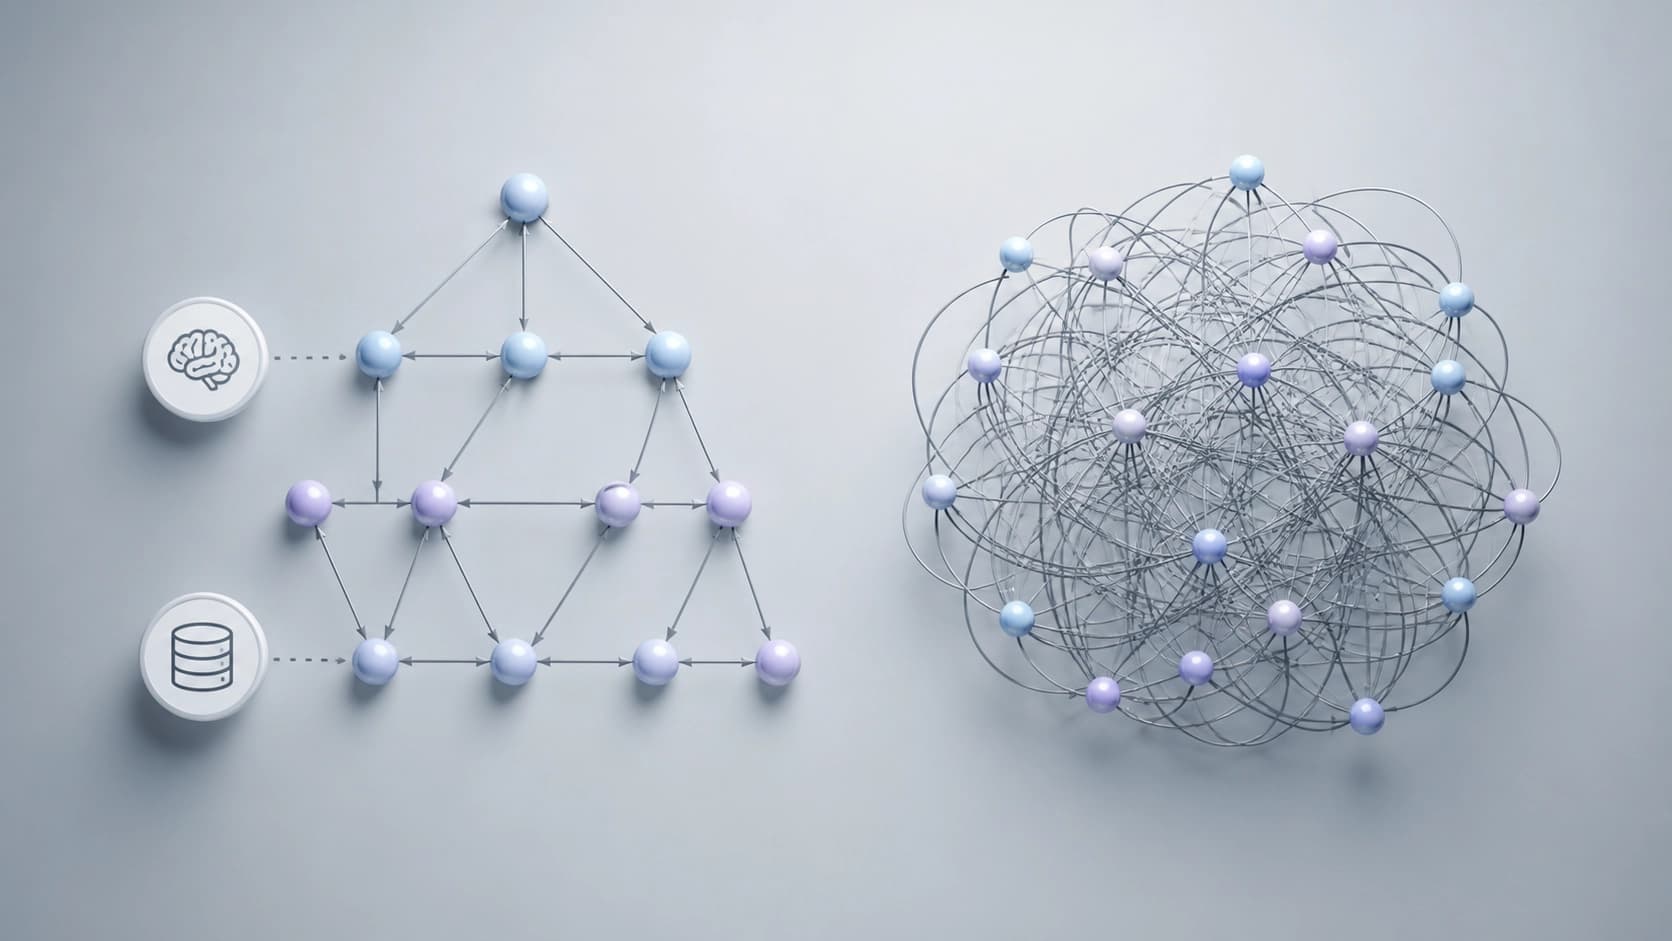
Les auteurs de l'étude (arXiv:2608.17810) — Alona Strugatski, Likol Zeinfeld, Jason Cooper et leurs collègues — ont pris les réponses d'humains et de six LLM différents à des tâches de raisonnement quantitatif et de chimie. À l'aide d'une analyse factorielle exploratoire, ils ont identifié pour chaque groupe des facteurs latents cachés qui sont présumés être à l'origine de la réussite à ces tâches.
Ensuite, des experts du domaine ont étudié les structures obtenues en aveugle et ont tenté d'attribuer aux facteurs un sens pédagogique : par exemple, « capacité à travailler avec des formules » ou « compréhension de la stœchiométrie ». Le format en aveugle excluait tout indice — les spécialistes ne savaient pas si les graphes concernaient des humains ou des modèles.
Résultat : un fossé dans l'interprétabilité
Les experts ont presque sans difficulté compris les facteurs issus des réponses humaines. La plupart des construits ont reçu une explication pertinente, facilement traduisible en recommandations pour l'apprentissage ou le diagnostic.
Avec les LLM, le tableau était différent :
- En raisonnement quantitatif, les experts n'ont pas pu interpréter de manière pertinente aucun des facteurs identifiés pour les modèles.
- En chimie, la situation était légèrement meilleure, mais encore loin d'être idéale : seulement environ la moitié des structures ont pu être expliquées.
Ce que cela signifie
Les auteurs tirent une conclusion importante : lorsque les LLM obtiennent de bons résultats aux tests, cela ne signifie pas qu'ils raisonnent de la manière qui nous est familière. Les modèles peuvent trouver des moyens statistiquement efficaces, mais totalement « étrangers » à l'humain, pour résoudre des problèmes. Leurs mécanismes internes fonctionnent au niveau de schémas qui ne portent aucun sens pédagogique ou cognitif compréhensible.
Cette observation remet en cause la pratique courante qui consiste à tirer des conclusions sur le niveau de connaissances ou de compétences à partir des résultats de l'IA. Si nous ne pouvons pas expliquer quelles constructions exactes se cachent derrière les réponses, nous risquons d'attribuer aux modèles des capacités inexistantes — ou, à l'inverse, de manquer de réelles limitations.
Où aller ensuite
L'étude n'affirme pas qu'interpréter les LLM est impossible en principe. Elle montre simplement que l'approche classique, conçue pour étudier la cognition humaine, ne se transpose pas directement aux modèles. Il faudra peut-être développer des méthodes d'analyse fondamentalement nouvelles — qui tiennent compte de la nature « non humaine » des structures latentes.
En attendant, la question reste ouverte : si les experts ne peuvent pas expliquer la logique des modèles, pouvons-nous nous fier à leur utilisation dans l'éducation et l'évaluation des connaissances ? La réponse exigera probablement de revoir à la fois les approches de vérification de l'IA et nos attentes vis-à-vis de « l'intelligence » des machines.
Foire aux questions
Matériaux connexes
Tous matériaux
La validation des candidats coûte plus cher que leur génération : des leurres contre la recherche de vulnérabilités par les LLM
Cette étude analyse l’asymétrie des coûts de la recherche agentique de défauts : la génération de variantes est peu coûteuse, tandis que leur confirmation au moyen d’une analyse d’accessibilité, de l’exécution et d’un PoC mobilise l’essentiel du budget ; la vérification peut donc devenir une cible de défense à part entière. RedHerring, qui propose des leurres adaptés au dépôt et assortis d’un certificat secret, a réduit de 38,7 à 60,4 % le nombre de véritables vulnérabilités détectées, à coût égal, dans 33 projets OSS-Fuzz ; même après avoir averti l’agent, la baisse restait de 37,2 %.
9 novembre 2026
Vérification des hallucinations des LLM via une vue SQL des sources, sans réentraînement
Ce travail évalue si un LLM peut mobiliser une compétence symbolique élémentaire — la création d’une base SQL à partir des documents sources — afin d’ancrer les réponses dans leurs sources sans supervision pour détecter les hallucinations. Sur RAGTruth et DiaHalu, ce pipeline neuro-symbolique se révèle plus précis que la prédiction directe et comparable aux méthodes de pointe, sans nécessiter de réglage fin spécifique au domaine.
9 novembre 2026
MathAdv : ce que cache la précision finale des preuves automatiques
Un ensemble de tâches diagnostiques couvrant 13 domaines des mathématiques universitaires et de troisième cycle évalue les systèmes de démonstration automatique dans Lean 4 non seulement sur le résultat final, mais aussi sur leur maîtrise des sujets, la qualité de leurs raisonnements informels et leur robustesse face aux reformulations des énoncés. L’analyse par composante montre que la formalisation des problèmes reste le principal obstacle et que la réussite dépend fortement du domaine mathématique et de la manière dont le problème est formulé.
9 novembre 2026