Ce que l’IA doit planifier exactement
La planification urbaine est ici un problème d’optimisation spatiale : il faut choisir des actions admissibles parmi un vaste ensemble de possibilités.
Les objectifs pratiques incluent le coût et la qualité du service.
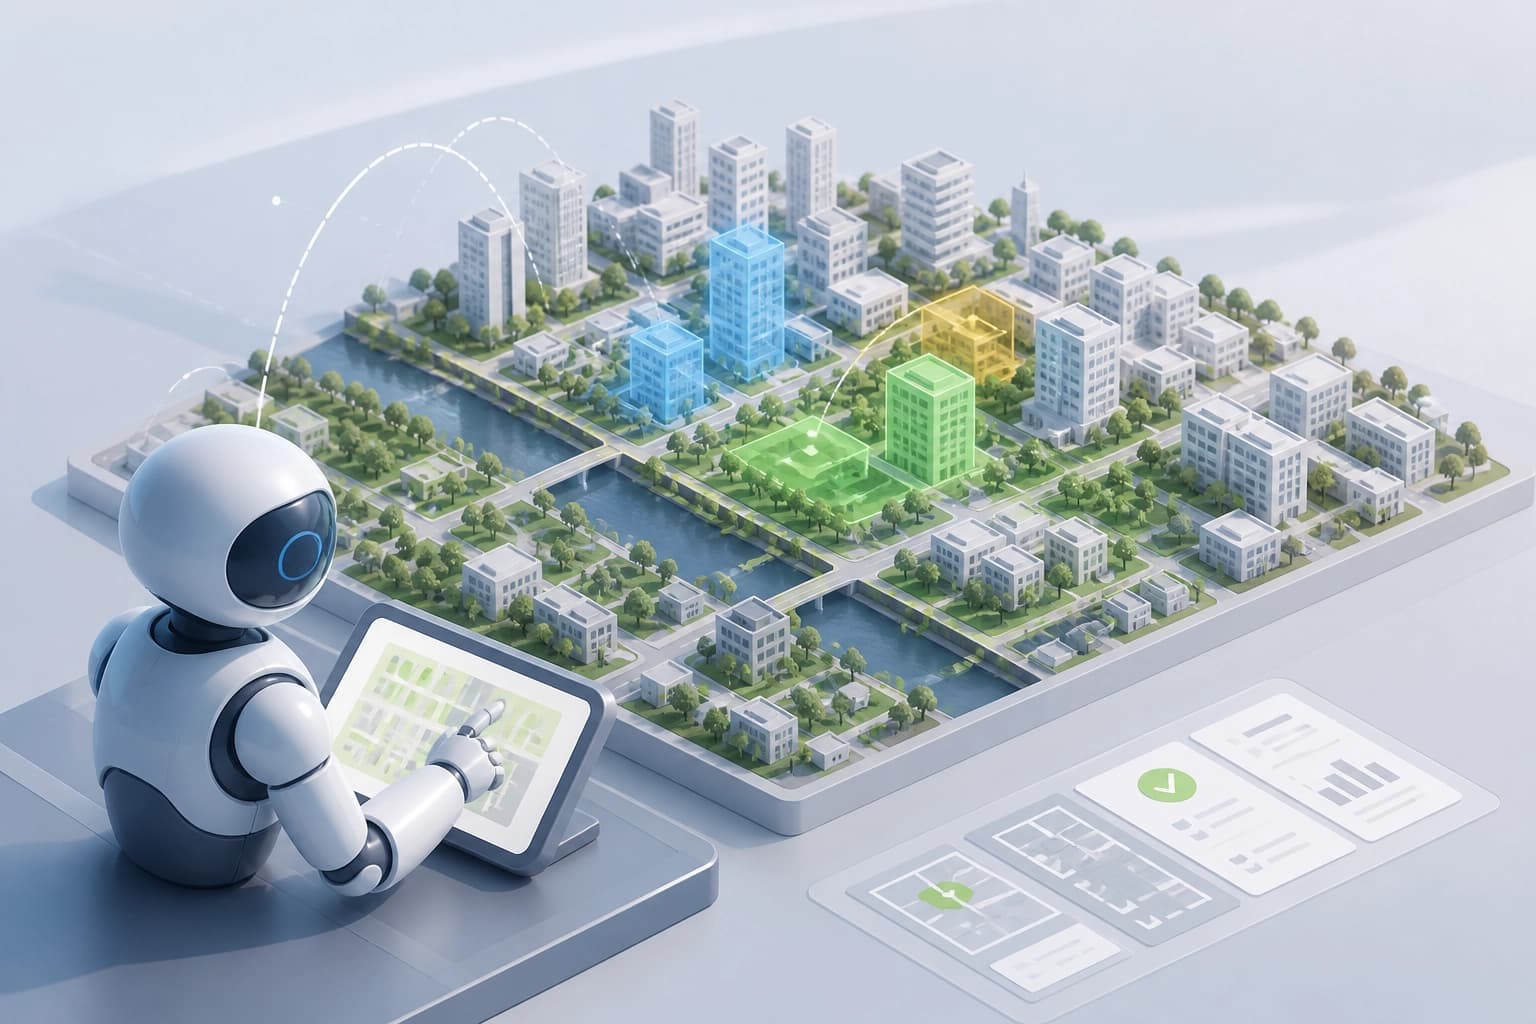
Le travail CityPlanner décrit un agent sandbox pour la planification urbaine exécutable.
Un scénario vérifiable relie le plan à son évaluation : le système lance un évaluateur et reçoit un retour exécutable.
Dans ce cadre, les actions admissibles, l’objectif pratique et la possibilité d’évaluer le résultat sont essentiels.
Le critère de vérifiabilité est le suivant : l’environnement peut évaluer le plan créé.
Comment fonctionne l’environnement d’exécution
Dans UrbanSandbox, l’agent évolue dans un environnement de fichiers unifié.
Il examine les fichiers de la tâche, crée un plan, lance des évaluateurs et révise sa solution en fonction des retours.
Ce cycle combine le travail sur les données de la tâche et la vérification du plan.
Actions principales de l’agent :
- examiner les fichiers de la tâche ;
- créer un plan ;
- lancer un évaluateur ;
- réviser la solution à partir des retours exécutables.
L’environnement convient à un scénario si l’agent peut y effectuer tout le cycle, de l’examen de la tâche à la révision du plan.
Comment répartir l’apprentissage
Les auteurs proposent l’apprentissage par renforcement à tâches atomiques : les longues trajectoires dans le sandbox sont divisées en deux tâches.
Cette séparation simplifie l’apprentissage en distinguant la création initiale du plan de son amélioration.
Chaque tâche correspond à une étape distincte du travail sur le plan.
- BuildPlan — créer un plan initial.
- ImprovePlan — améliorer le plan à partir des retours.
Cette séparation est pertinente lorsque l’apprentissage combine la création d’un plan et son ajustement ultérieur en fonction des résultats de l’évaluation.
Ce que montrent les expériences
Sur un benchmark réel, CityPlanner a systématiquement surpassé trois groupes de comparaison :
| Comparaison | Résultat |
|---|---|
| Méthodes heuristiques | L’agent a obtenu le meilleur résultat |
| RL spécifique à la tâche | L’agent a obtenu le meilleur résultat |
| Modèles de base d’agents LLM généralistes | L’agent a obtenu le meilleur résultat |
Les études d’ablation ont confirmé la contribution d’UrbanSandbox, de l’apprentissage par renforcement à tâches atomiques et du déploiement itératif.
Les auteurs signalent la publication du code et du jeu de données.
Les travaux ont été soumis le 9 septembre 2026 et sont en cours d’examen par EMNLP.
La conclusion pratique se limite aux résultats de ce benchmark : ils étayent le cadre proposé, mais n’établissent pas sa supériorité pour toutes les tâches urbaines.
Source : arXiv:2609.09578.