Ce que vérifie la simulation
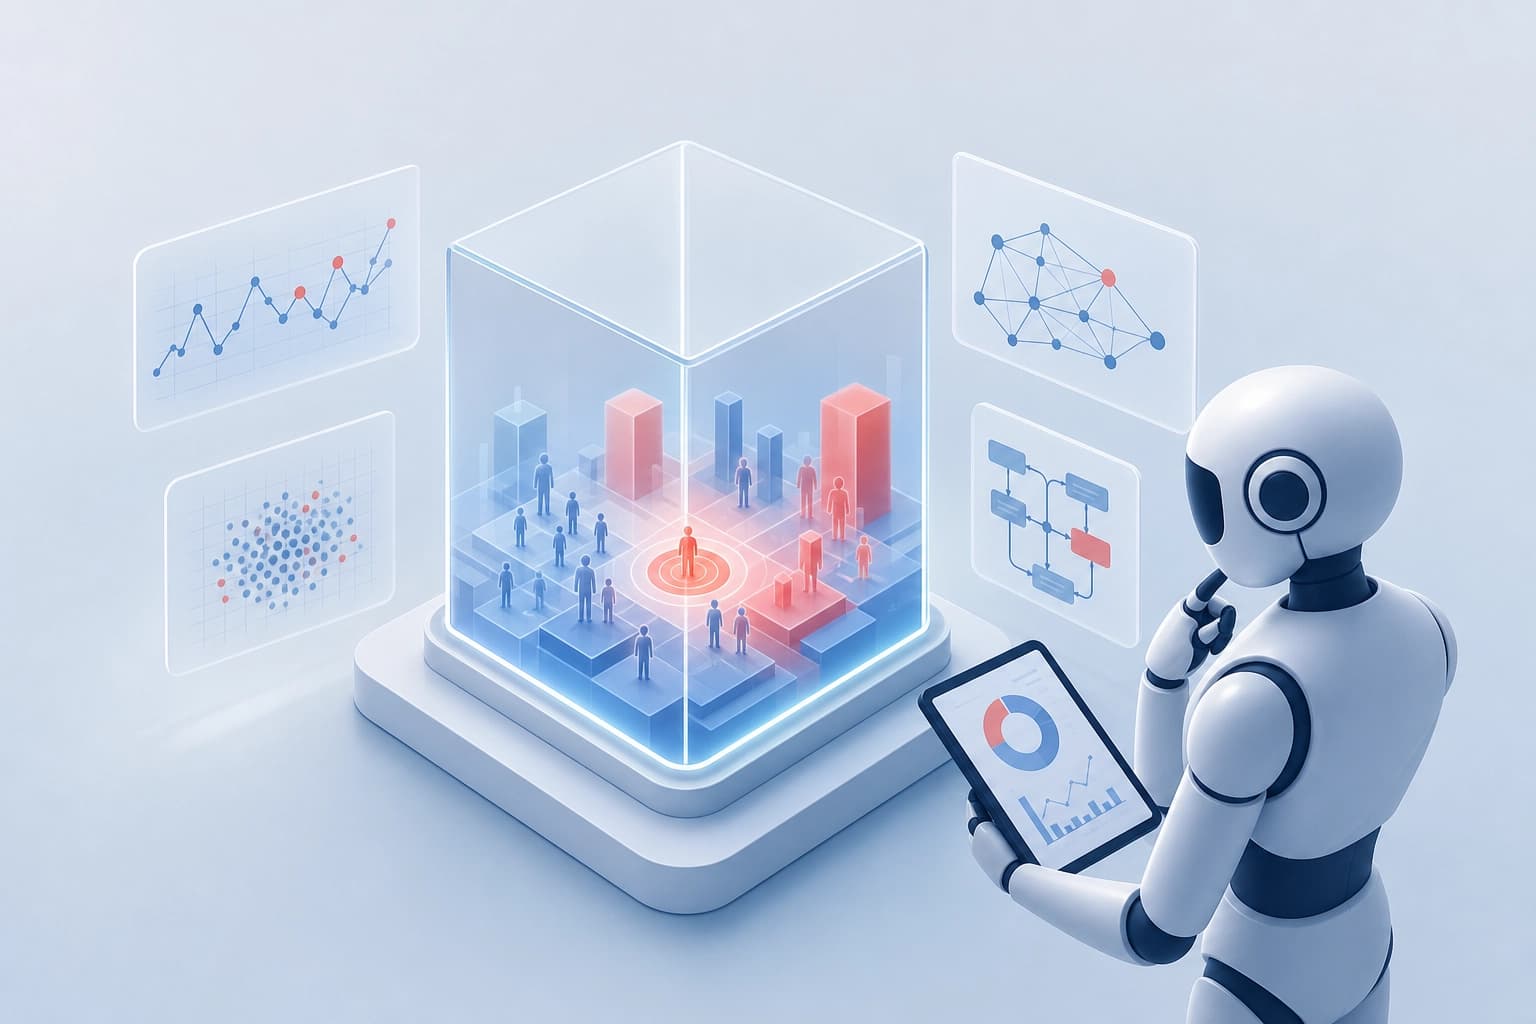
TRACE est un environnement de diagnostic pour la publicité numérique. Il couvre 12 causes racines et permet une attribution détaillée des segments. Dans chaque épisode, l’agent explore les données à l’aide de Python et de SQL. Il identifie ensuite la cause racine et, le cas échéant, le segment touché.
TRACE est décrit dans un article de Rui Sun, Zhan Shi et Bing He, soumis à arXiv le 9 septembre 2026. L’identifiant de l’article est arXiv:2609.10315.
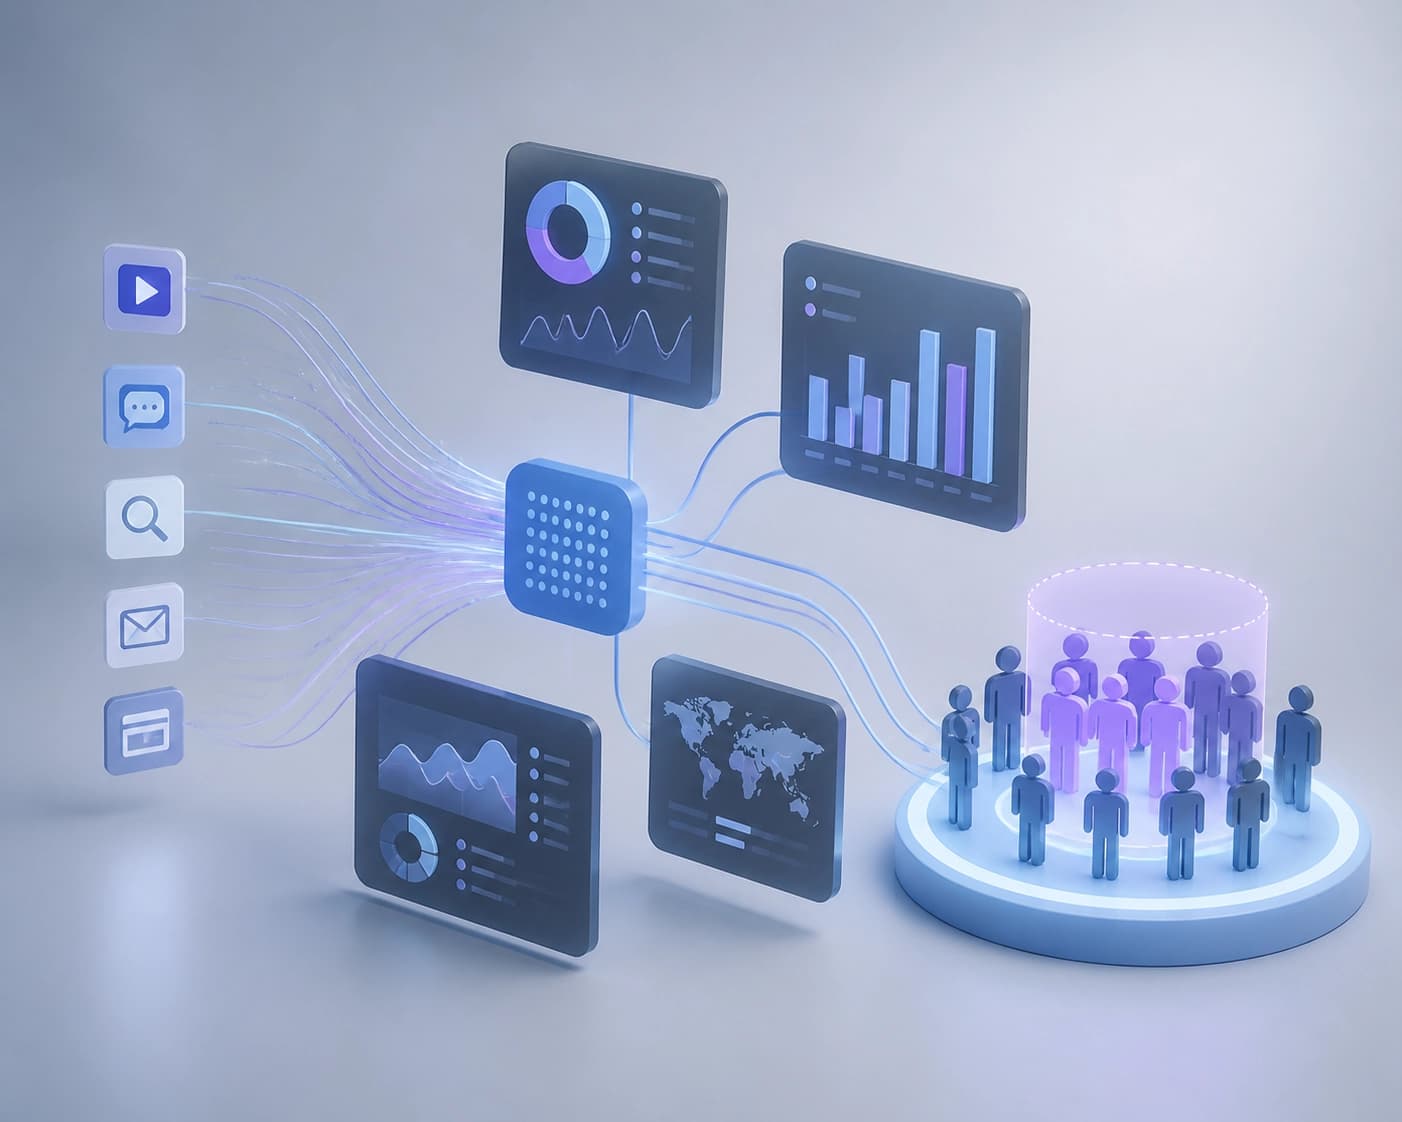
Comment l’évaluation est construite
L’évaluation repose sur une intervention et les observations qu’elle provoque :
- Une intervention est choisie et introduite dans un simulateur contrôlé.
- Le simulateur génère les observations correspondantes.
- L’agent explore les données et recherche la cause de la défaillance.
- L’intervention cachée sert de référence et permet de calculer une récompense objective.
L’agent ne reçoit pas d’explication toute faite. Il doit mettre en relation des éléments de preuve bruités, mêlés et répartis dans les données. La simulation évalue ainsi le raisonnement causal, et non la simple reconnaissance d’une réponse prédéfinie.
Comment lire les résultats
Les auteurs ont évalué les modèles sur un ensemble de test réservé de 235 épisodes. Le meilleur baseline de prompting, Claude Opus 5, a obtenu un score de 0.686 en FullAttr@1.
| Modèle ou étape | Résultat |
|---|---|
| Qwen3.5-35B-A3B après fine-tuning supervisé | 0,159 → 0,637 |
| Même modèle après apprentissage par renforcement avec des récompenses synthétiques | 0,757 |
| Qwen3.5-122B-A10B dans le baseline de prompting | Inférieur au résultat de 0,757 |
Le résultat de 0,757 a dépassé tous les baselines de prompting évalués, y compris les modèles de pointe à code source fermé. Les auteurs indiquent également que la policy obtenue a utilisé nettement moins d’appels aux outils que la version de prompting du modèle de base à 35B.
Ce que les résultats révèlent sur l’entraînement des agents
Les auteurs estiment que l’accès à un signal d’entraînement objectif et évolutif peut constituer une limite plus importante que la seule taille du modèle. Cette conclusion porte sur la tâche décrite et ne constitue pas une règle universelle pour tous les systèmes d’IA.
Une évaluation par simulation peut rendre des tâches ambiguës de raisonnement diagnostique compatibles avec un apprentissage par renforcement à grande échelle. La condition essentielle est de pouvoir comparer la conclusion de l’agent à l’intervention cachée et de calculer une récompense objective.
Quand cette approche est pertinente
La simulation convient à l’évaluation des conclusions causales si le cadre permet de :
- définir une intervention et de l’introduire dans un environnement contrôlé ;
- générer les observations qui lui sont associées ;
- conserver l’intervention comme référence cachée ;
- évaluer à la fois la cause racine et le segment touché, le cas échéant.
Si la tâche ne permet pas cette comparaison avec une référence, le mécanisme de récompense objective décrit n’est pas garanti. Le critère pratique de sélection consiste à déterminer si la conclusion de l’agent peut être vérifiée à partir de la cause cachée sans la révéler pendant l’analyse.