Les simulateurs ne parviennent pas à suivre les systèmes réels
Déployer un véritable cluster pour faire tourner de grands modèles de langage coûte cher, et c'est souvent tout simplement impossible : pas de matériel, pas de budget, pas le temps d'attendre. C'est pourquoi la simulation système est depuis longtemps devenue un outil de travail pour les chercheurs : on calcule d'abord sur un simulateur, puis on passe au matériel.
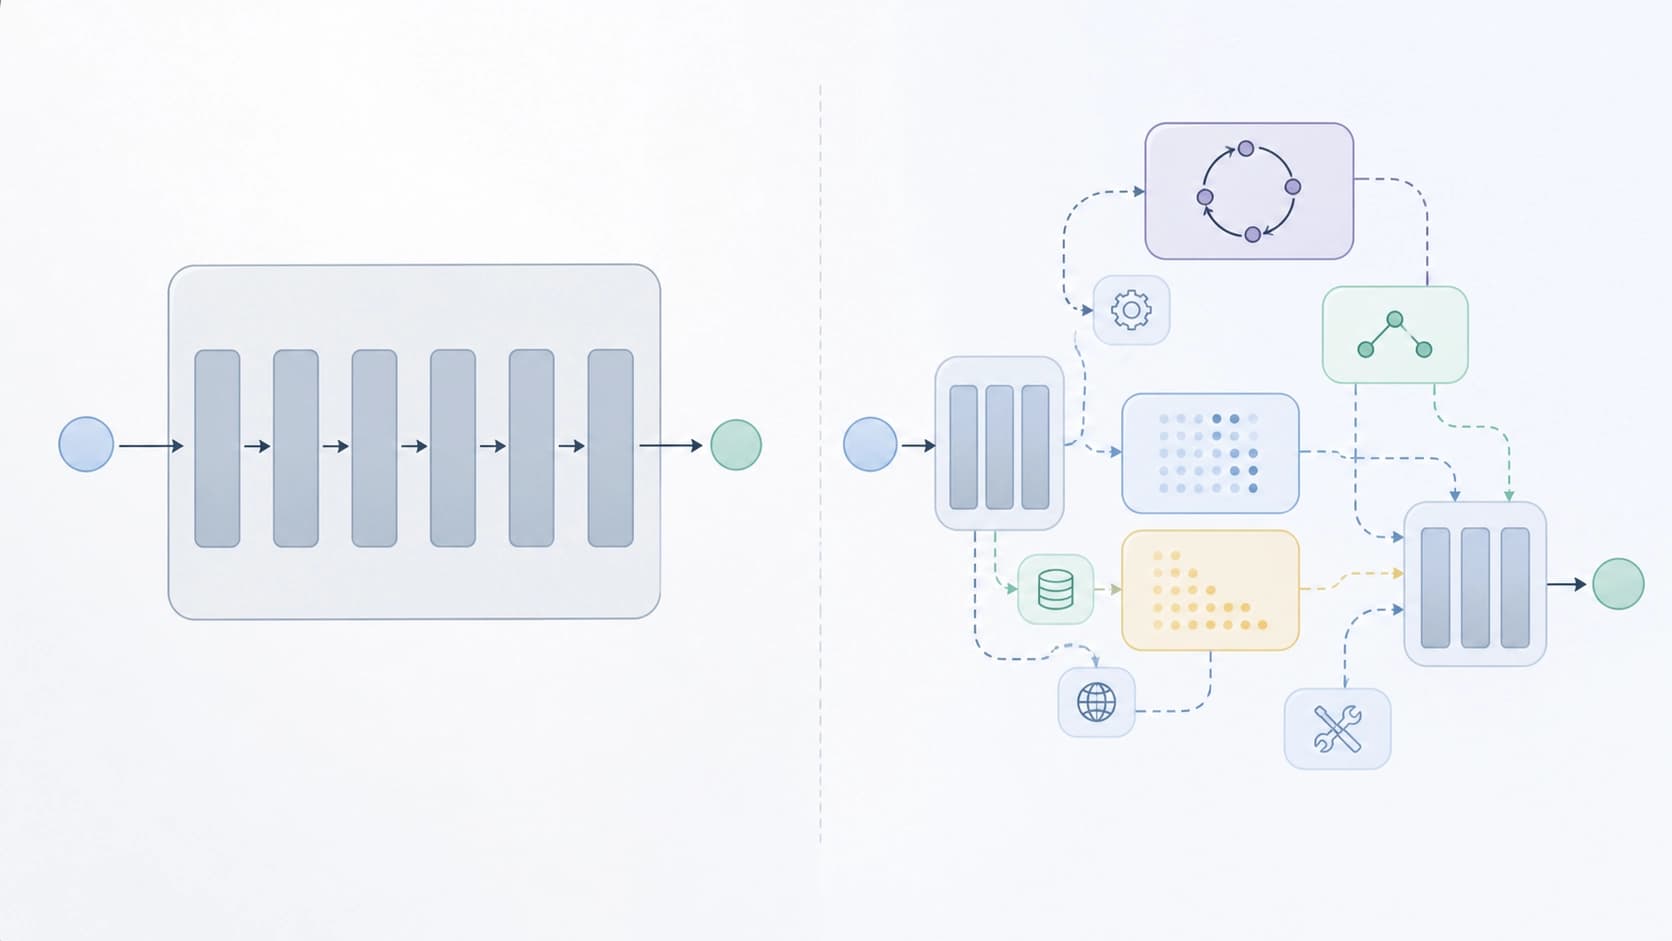
Le hic, c'est que le domaine lui-même évolue plus vite que ne se développent les simulateurs. Les nouvelles charges de travail — les scénarios agentiques, où le modèle appelle des outils et fonctionne en boucle, les schémas à phases prefill et decode séparées — ne rentrent plus dans le pipeline monolithique sur lequel reposent les simulateurs existants. Tout nouveau mécanisme doit être greffé sur le côté via une refonte douloureuse du cœur. Résultat : l'écart entre ce qui tourne réellement en production et ce qu'un simulateur parvient à reproduire ne cesse de se creuser.
L'idée : un simulateur qui s'étend lui-même
Une équipe de chercheurs — Wonung Kim, Hyunmin Choi, Minsu Kim, Jaehong Cho, Yeongwook Kim et Jongse Park — s'est attaquée à ce problème. Leur prépublication arXiv:2608.24650 (cs.AR, cs.AI) s'intitule « Simthesizer: An Agent-Driven Simulation Framework for LLM Serving Systems ».
Le renversement de perspective est le suivant : inutile d'écrire un énième simulateur pour un ensemble donné de mécanismes actuels — il sera obsolète avant même de sortir. Il faut construire Simthesizer de manière à ce qu'il s'étende lui-même, au fur et à mesure de l'apparition de nouveaux besoins. Et pas par un programmeur qui passe un mois à lire du code étranger, mais par un agent qui comprend un énoncé en langage naturel et sait le traiter à l'intérieur du simulateur.
Un graphe dynamique unique au lieu d'un ensemble de modules
La base technique de l'idée est une infrastructure composable. Dans Simthesizer, tout le processus de service est exprimé de manière uniforme : non seulement les calculs eux-mêmes, mais aussi les décisions de contrôle qui coordonnent ce processus — c'est-à-dire l'ordonnanceur, l'ordre de traitement, l'allocation des ressources. Tout cela est décrit comme un graphe dynamique unique, qui évolue au fil de la simulation.
L'avantage pratique est clair : quand une nouvelle fonctionnalité n'a pas besoin d'être greffée sur des jonctions figées entre sous-systèmes, mais qu'il suffit d'ajouter un nœud à la vue d'ensemble, le coût d'extension chute de plusieurs ordres de grandeur. C'est précisément là que survenait auparavant la « refonte invasive » — toute la logique était éparpillée dans le code, et tout nouveau mécanisme touchait la moitié du simulateur.
L'agent synthétiseur : une requête en mots, pas un fork de code
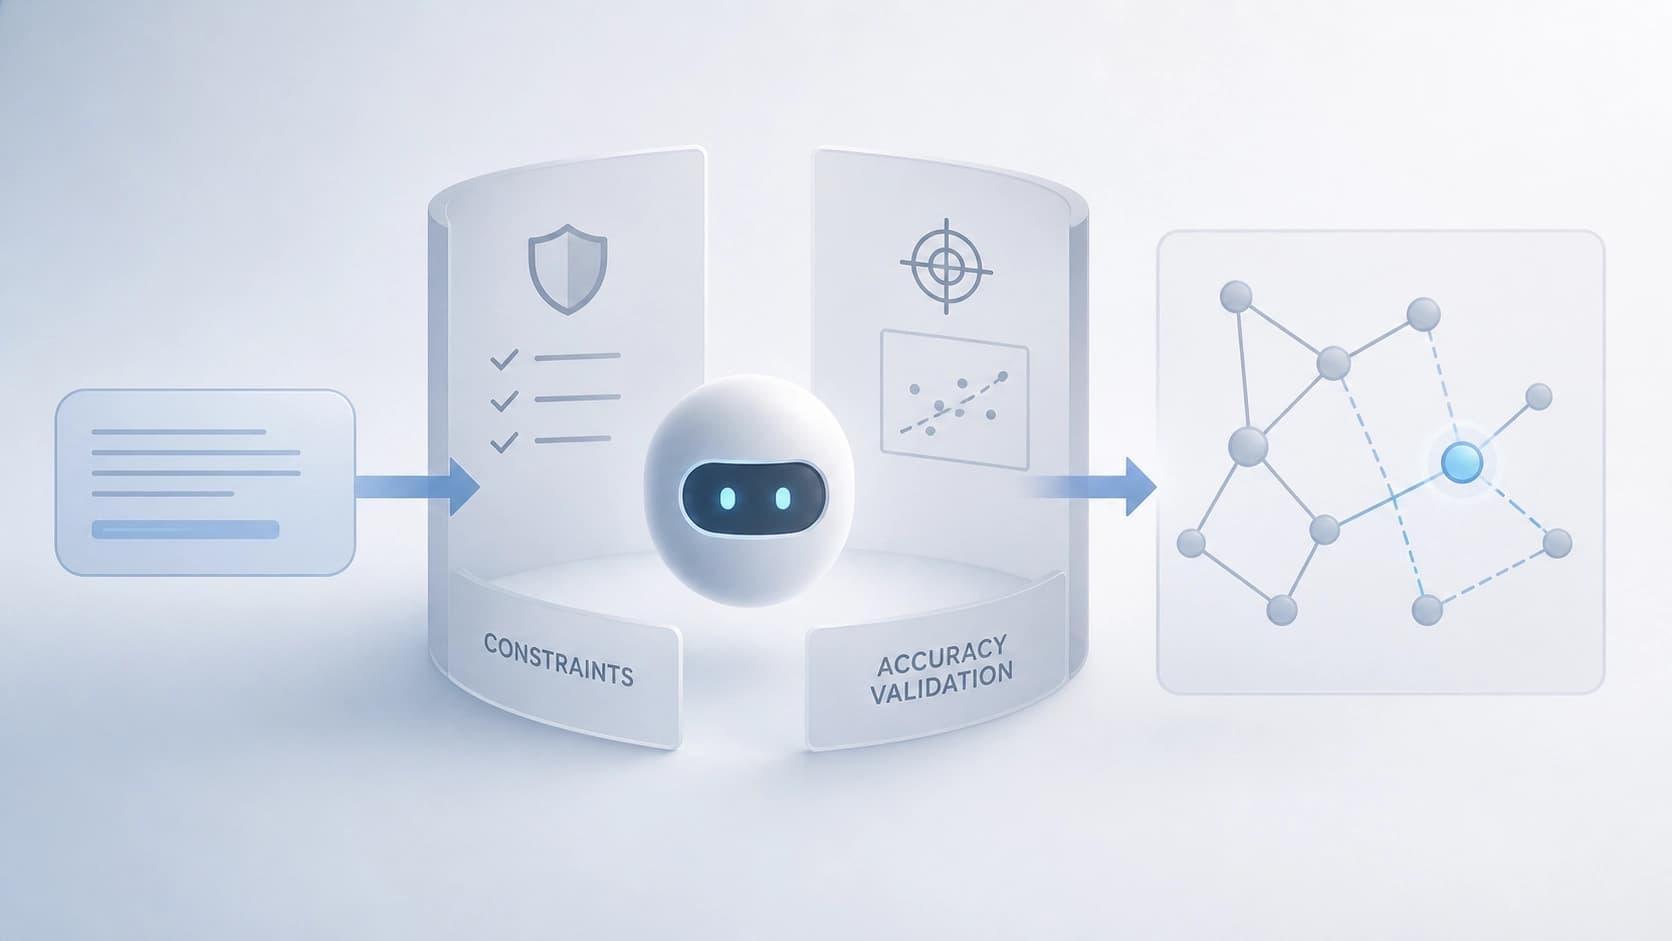
Le deuxième élément est le Synthesizer agent, que les auteurs décrivent comme un « coding agent sous harnais » (harnessed coding agent). Sa tâche consiste à traduire les requêtes portant sur les fonctions souhaitées, formulées en langage humain ordinaire, vers cette représentation abstraite à l'intérieur du simulateur.
Le mot clé ici est « sous harnais ». L'agent n'écrit pas ce qu'il veut : il travaille dans le cadre de contraintes spécifiques au simulateur concerné, et son résultat passe une validation de fidélité de la modélisation (fidelity validation). Sans cette étape, l'entreprise se transformerait en générateur de code plausible mais erroné. Autre détail important : l'agent fait évoluer un simulateur commun, plutôt que d'en multiplier un nouveau pour chaque fonctionnalité — sinon nous n'aurions obtenu que le même zoo de forks incompatibles, mais créé automatiquement.
Dans quelle mesure cela fonctionne
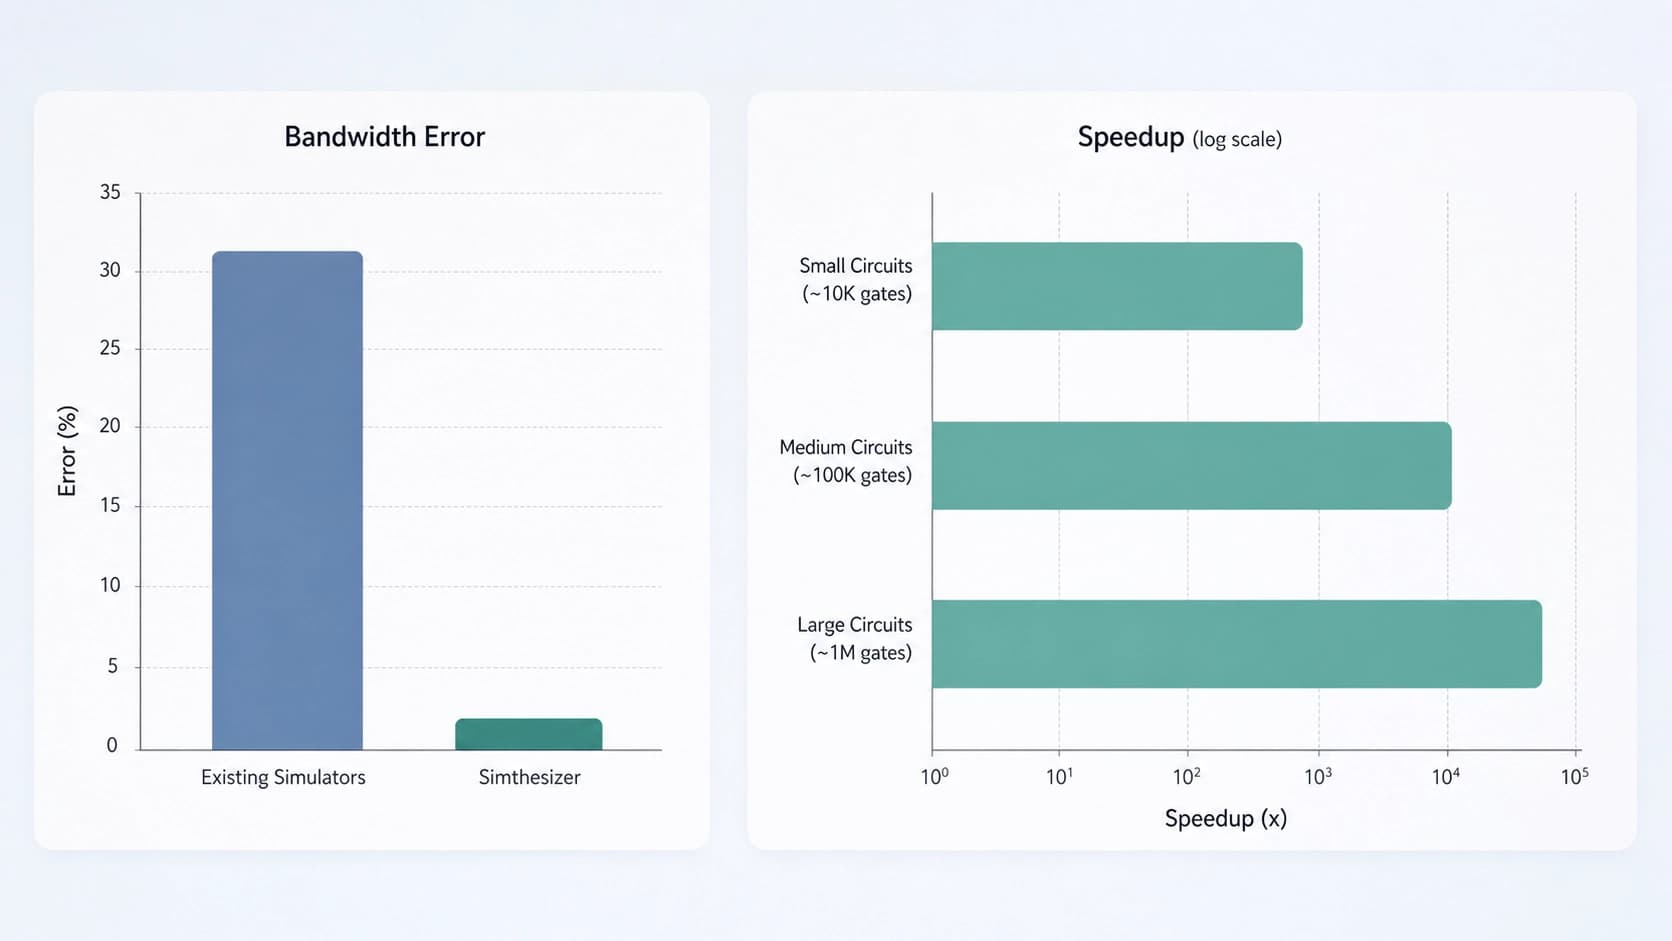
Les auteurs ont vérifié l'approche non pas sur des données synthétiques, mais par comparaison avec la réalité. Les extensions construites sur Simthesizer reproduisaient un système basé sur vLLM avec une erreur moyenne de débit de 2,51 %. Pour les extensions sur les simulateurs existants, la même métrique est de 6,03 %. L'écart est de plus du double, et pourtant le même coding agent avec le même harnais a été utilisé : c'est donc bien l'architecture du simulateur qui apporte le gain, et non un heureux choix de modèle exécutant.
La vitesse impressionne tout autant. Sur des charges de travail identiques, Simthesizer modélisait jusqu'à 284,96 fois plus vite que LLMServingSim2.0, et jusqu'à 23,19 fois plus vite que Vidur. De tels ordres de grandeur changent la nature même de la recherche : au lieu de « lancer une exécution et attendre », on peut désormais parcourir des dizaines de configurations et comparer les scénarios entre eux.
Ce que cela change et ce qu'il faut garder en tête
Si l'approche s'impose, le changement ne se produira pas seulement dans les chiffres, mais aussi dans le rôle de l'outil lui-même. Le simulateur cessera d'être un artefact figé qui rattrape la réalité avec un à deux ans de retard, et deviendra un système que l'on peut adapter à une nouvelle tâche en une seule conversation. Pour ceux qui conçoivent l'infrastructure d'inférence, cela signifie un cycle de vérification des hypothèses moins coûteux : plus besoin de monter un banc d'essai pour comprendre si une idée sera rentable.
Mais il y a aussi des questions que les auteurs laissent de côté. Dans quelle mesure la validation de fidélité détecte-t-elle les erreurs subtiles de l'agent — par exemple lorsqu'un nouveau nœud fonctionne formellement, mais modifie discrètement le comportement sous une certaine combinaison de charge et de timings ? Comment l'approche se transpose-t-elle aux éléments spécifiques au matériel, comme les accélérateurs non standard ? Et enfin, la question de la confiance reste ouverte : quand le simulateur s'écrit de plus en plus lui-même, quelqu'un doit être capable de lire ce qui en résulte.
Pour l'instant, le résultat est simple et clair : la combinaison « architecture composable plus agent aux droits limités » offre une modélisation à la fois plus précise et nettement plus rapide que les simulateurs soigneusement polis mais rigides de la génération précédente. C'est exactement le cas où il était plus juste de changer non pas le modèle, mais la conception de l'outil.