
Le problème du budget uniforme des experts
Les transformeurs MoE à activation parcimonieuse fixent un nombre identique d'experts routés dans toutes les couches. Cela ignore l'hétérogénéité documentée de la redondance entre les couches.
MAPLE est un framework plug-and-play. Il redistribue le budget d'experts routés entre les couches de n'importe quel LLM MoE préentraîné. La méthode ne modifie pas les poids et ne nécessite pas de réentraînement.
Propriétés clés :
- Distribution hétérogène du budget par couche.
- Aucune modification des poids du modèle.
- Aucun réentraînement.
- Applicabilité à un LLM MoE préentraîné.
Critère pratique : l'approche est nécessaire lorsqu'il faut modifier la répartition des experts sans modifier les poids ni réentraîner.
Sensibilité des couches et formule fermée
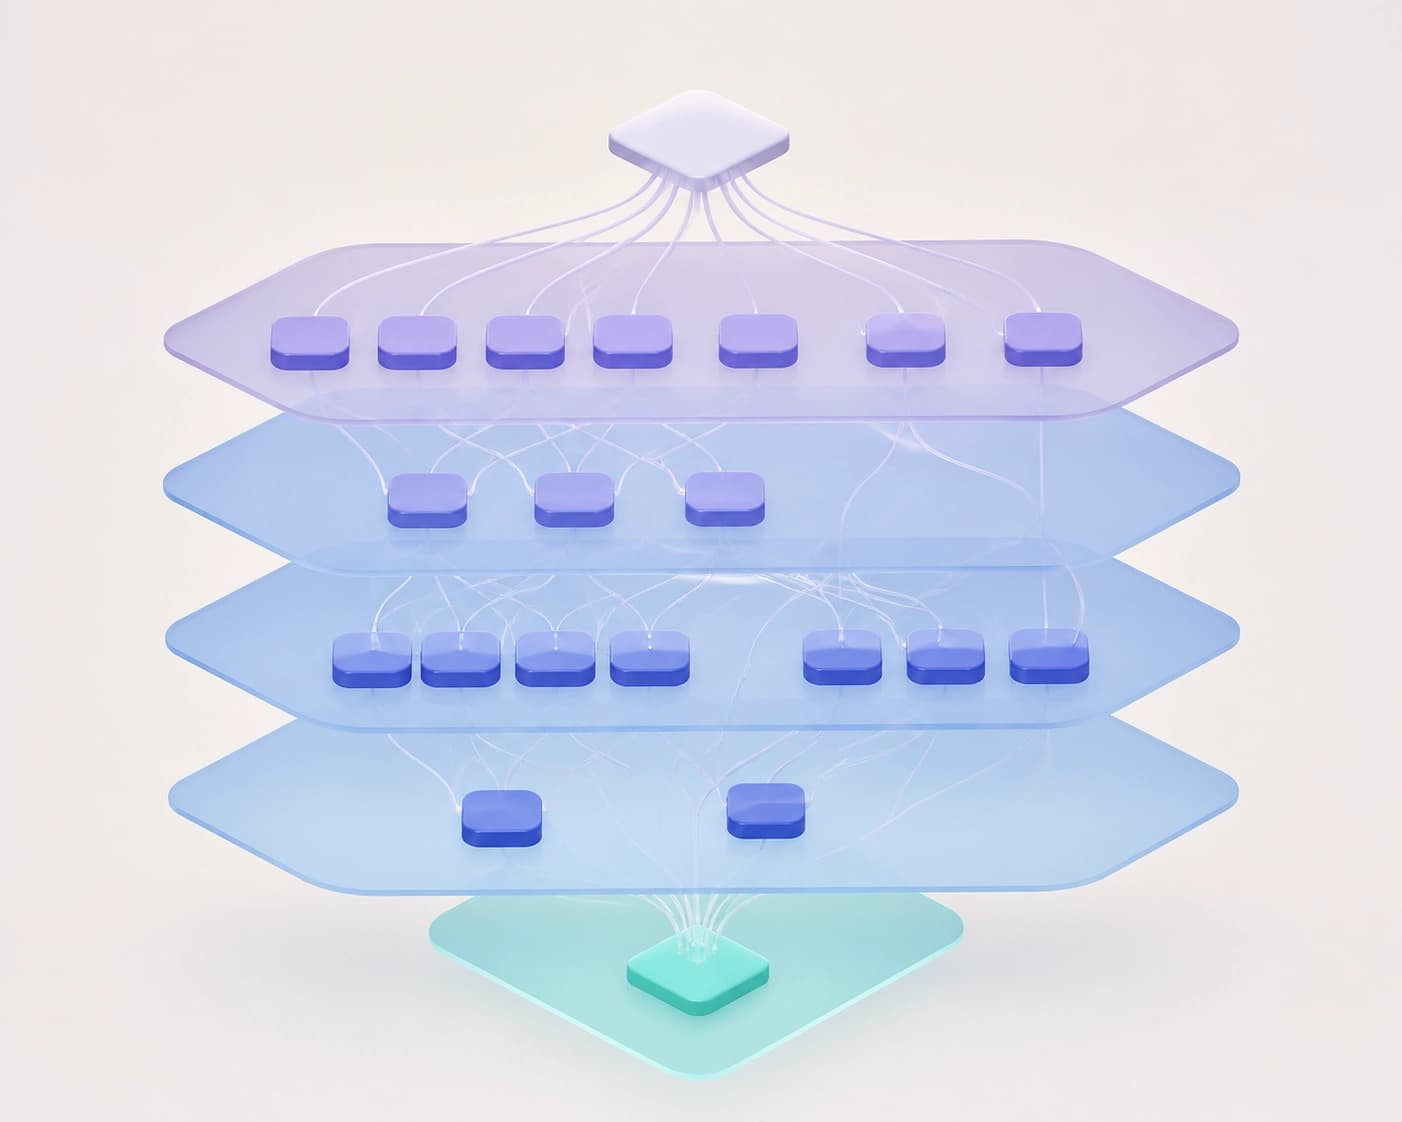
MAPLE sonde chaque couche. La méthode vérifie la réaction de la couche au changement du nombre d'experts. La sensibilité est quantifiée par trois mesures.
Étapes du transfert de budget :
- Sondage de chaque couche.
- Évaluation de la réaction au changement du nombre d'experts.
- Quantification de la sensibilité par trois mesures.
- Déduction d'une répartition analytiquement optimale du budget.
- Affinage par recherche génétique avec contrainte de sensibilité.
La répartition analytique dirige la capacité vers les couches sensibles. Dans les couches redondantes, la réduction du budget est absorbée. La recherche génétique utilise la sensibilité par couche comme a priori. Cela donne une convergence plus rapide et une meilleure qualité de répartition.
Conclusion : le transfert de budget s'appuie sur une sensibilité mesurable, et non sur une règle uniforme.
Comparaison avec les approches uniformes et de pruning
MAPLE surpasse les baselines uniformes et basées sur le pruning sur quatre modèles MoE d'échelle et d'architecture différentes. La comparaison se fait à 75 % de budget d'experts routés.
| Variante | Budget d'experts routés | Résultat |
|---|---|---|
| Baseline uniforme | 75 % | Inférieur à MAPLE |
| Baseline basée sur le pruning | 75 % | Inférieur à MAPLE |
| MAPLE | 75 % | Surpasse les deux baselines |
| Baseline uniforme | 100 % | Inférieur à MAPLE à 75 % sur DeepSeek-MoE-16B pour ARC-E, ARC-C et BoolQ |
Sur DeepSeek-MoE-16B, MAPLE n'utilise que 75 % des experts. Il dépasse néanmoins la baseline uniforme à 100 % sur ARC-E, ARC-C et BoolQ.
Gain de précision :
- ARC-E : de 65,09 à 71,40.
- ARC-C : de 48,49 à 51,50.
- BoolQ : de 80,03 à 82,38.
Conclusion : une répartition hétérogène peut être plus efficace que la simple activation d'un plus grand nombre d'experts.
Efficacité du service dans SGLang
L'implémentation de MAPLE dans SGLang réduit la latence de service de bout en bout sur une seule GPU de 32,2 %. Le débit augmente de 47,4 %.
La méthode ne modifie pas les poids. Elle peut donc être intégrée à la pile de service MoE existante. Cela fait du transfert de budget un levier pratique pour l'inférence.
Critère pratique : pour le service sur une seule GPU via SGLang, la méthode apporte une réduction de la latence et une augmentation du débit.
Critères de choix
MAPLE mérite d'être envisagé dans plusieurs cas :
- Il faut réduire le budget d'experts routés sans réentraînement.
- Le modèle est un LLM MoE préentraîné.
- Il faut tenir compte de l'hétérogénéité par couche plutôt que d'une règle uniforme.
- Il faut améliorer l'efficacité de l'inférence MoE.
Conclusion : la répartition hétérogène des experts devient un axe fondamental et pratique d'amélioration de l'efficacité des MoE.


