
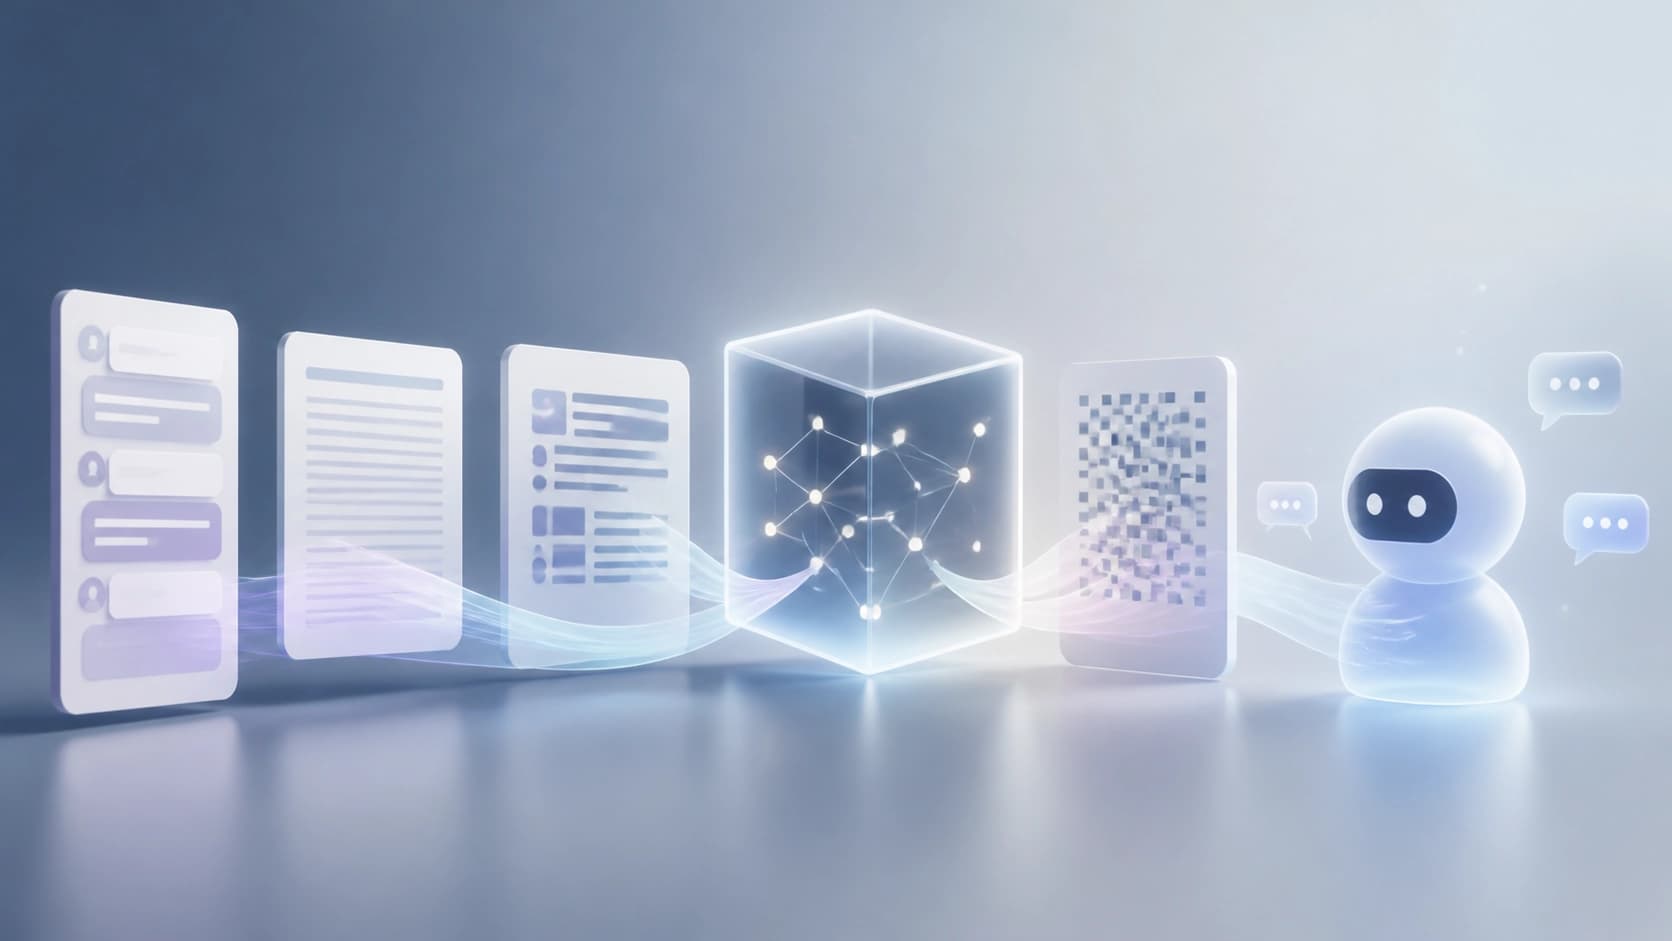
Pourquoi le format de présentation n'est pas un détail d'implémentation
Quand on évalue la mémoire d'un modèle de langage ou la qualité d'un pipeline RAG, on s'intéresse généralement à une seule chose : le modèle a-t-il atteint le fait recherché. Quant à la forme sous laquelle ce fait s'est retrouvé dans le contexte d'entrée — une entrée de mémoire distincte, un résumé compressé, un enregistrement structuré avec des champs ou un extrait brut de conversation —, on a tendance à la reléguer aux affaires internes du système. La logique est simple : si le fait est là, peu importe comment il est emballé.
Les auteurs du préprint arXiv:2608.23568 proposent de ne pas être d'accord. Leur travail « RENDER: Controlling Reader-Facing Evidence in LLM Memory Evaluation » (Yuan Si, Simeng Han, Daming Li, Jialu Zhang ; v1 du 5 juin 2026) s'attaque à l'idée même qu'il existerait une évaluation unique, honnête et universelle de la mémoire. Ils proposent plutôt de la mesurer comme on mesure d'autres propriétés sensibles à la configuration : fixer une variable et faire varier les valeurs de l'autre.
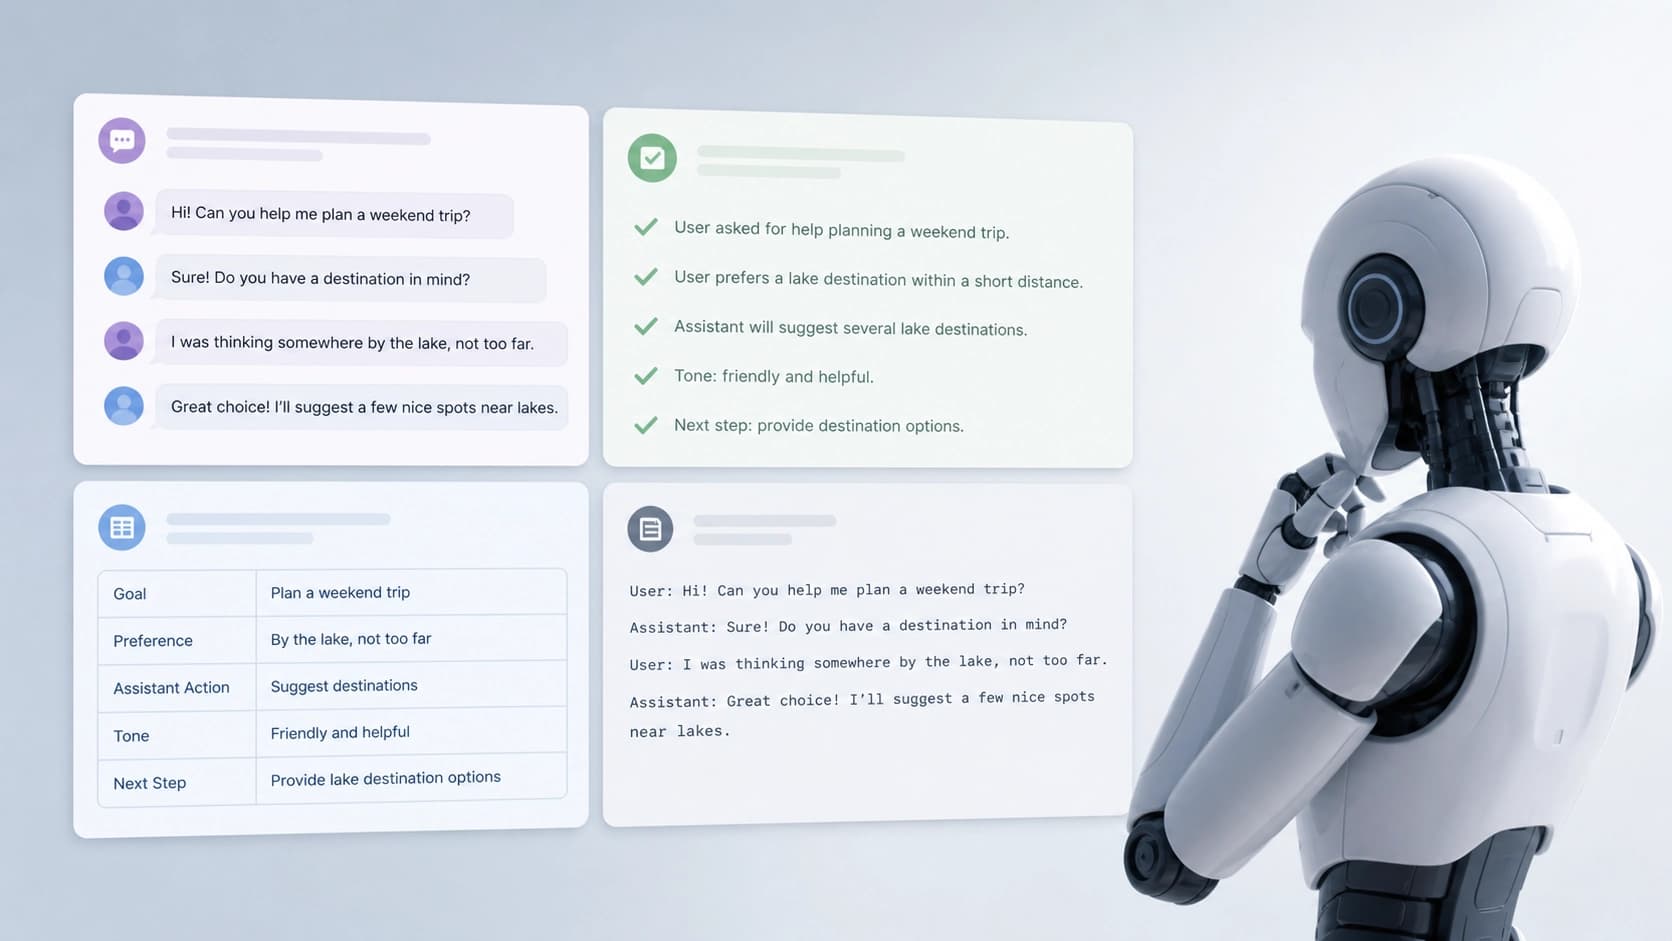
Ce que RENDER contrôle exactement
Le dialogue ne change pas. Seul change l'artefact tourné vers le lecteur : ce que le modèle répondant voit effectivement devant lui. C'est précisément cette couche — le reader-facing artifact — que RENDER érige en variable contrôlée.
Une échelle à cinq niveaux
Le cœur de la méthode, c'est le five-level packet ladder. Ce n'est pas un simple ensemble de formats, mais une échelle qui localise le moment où le contenu porteur de la réponse entre dans l'entrée du modèle qui répond. L'idée est de distinguer deux échecs fondamentalement différents : le système n'a pas trouvé le fait recherché, et le système l'a trouvé mais n'a pas su le transmettre sous une forme exploitable. Sans une telle échelle, ces cas se fondent en une seule ligne de rapport, et les conclusions erronées commencent — par exemple, que le modèle « se souvient mal », alors qu'en réalité il n'a simplement pas décodé l'emballage.
Quatre modèles de présentation
Le deuxième élément, ce sont des modèles déterministes qui approximent les manières typiques de présenter l'historique à l'utilisateur. Il y en a quatre :
- des entrées dans le style ChatGPT — des blocs soignés, semblables à ce qu'une personne voit dans l'interface d'un chatbot ;
- des résumés dans le style LangChain — des reformulations compressées qui perdent les formulations mais conservent l'essentiel ;
- des entrées typées dans le style MemGPT — une structure avec des champs et des catégories, pratique pour le traitement machine ;
- le dialogue brut — les répliques telles quelles, sans balisage ni réemballage.
Les modèles sont déterministes : une même entrée produit chaque fois le même texte. C'est important, car sinon on ne pourrait pas distinguer l'effet du format de la dispersion aléatoire de la génération.
Ce que les chiffres ont montré
L'expérience s'appuie sur 500 questions issues de LongMemEval et neuf modèles. Il faut s'y arrêter : ce n'est ni un seul lancement ni un seul passage pour un joli chiffre, mais une grille « modèle × format de présentation », qui permet justement de voir l'effet.
Résultat principal : les matched-budget resolved packets dépassent le recency-truncated raw dialogue de 42,4 à 72,6 points. Autrement dit, si l'on ramène les formats à un budget comparable et que l'on donne au modèle un contenu qui porte réellement la réponse, l'écart avec la manière de présenter la plus naïve — le dialogue brut tronqué par fraîcheur — n'est pas cosmétique, mais vertigineux.
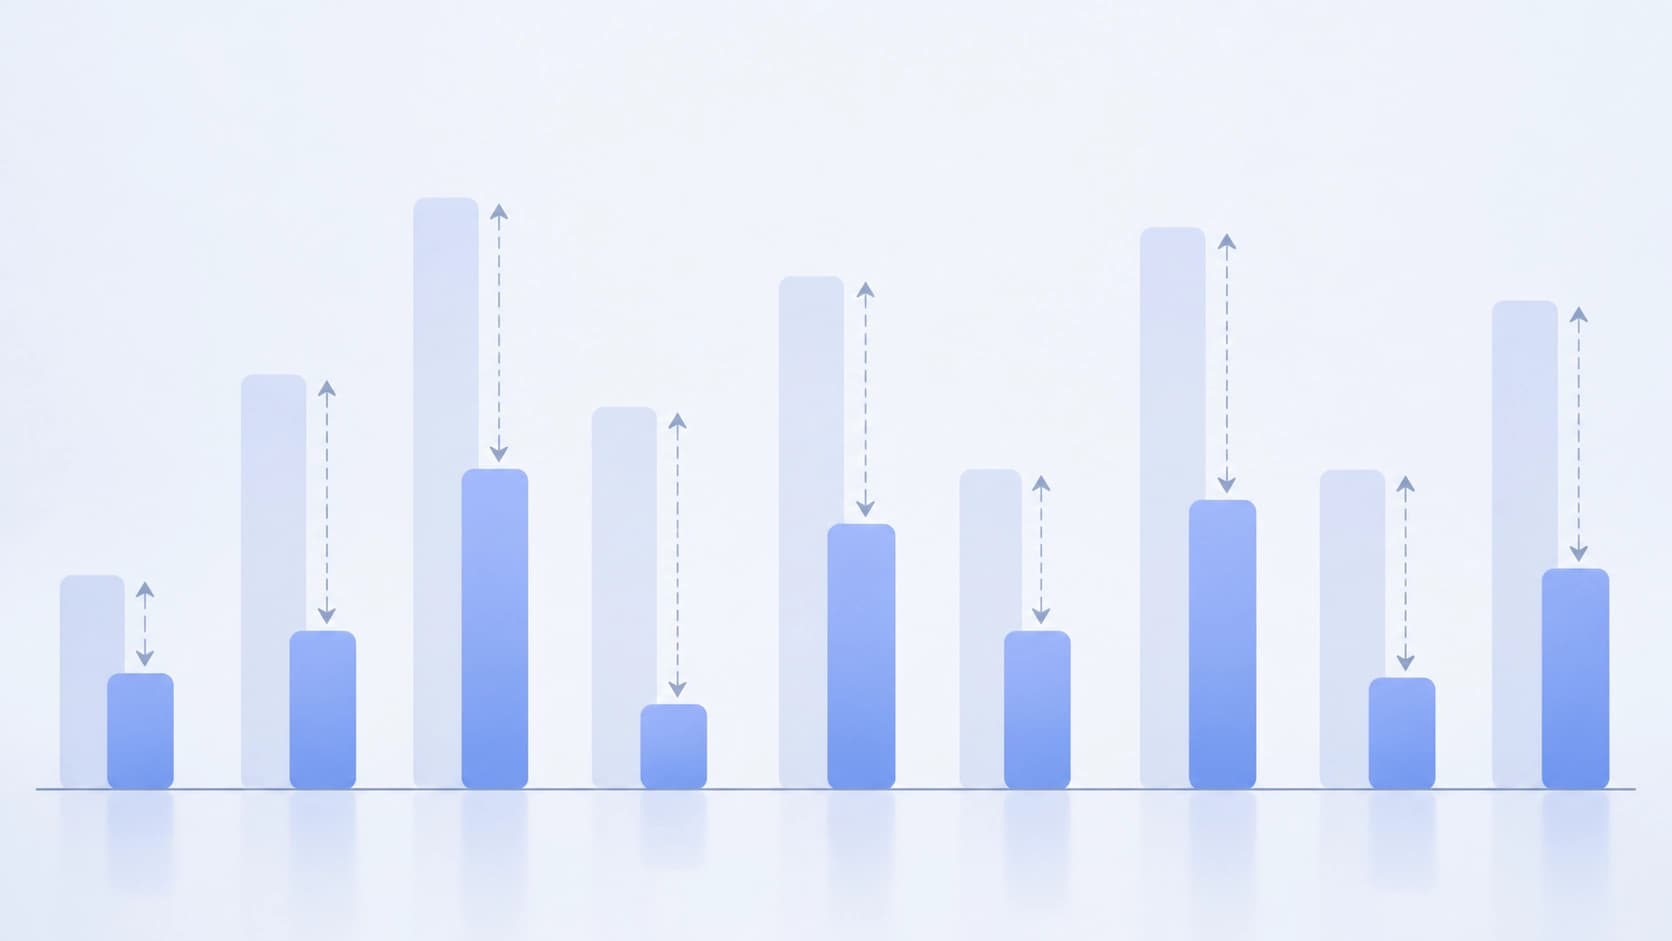
Dans les modèles de style déployé, le tableau est plus doux, mais reste massif : l'écart entre le meilleur et le pire format atteint 24,6 à 48,8 points pour chacun des neuf modèles. Autrement dit, au sein d'un même modèle, sur les mêmes questions, avec le même budget, on peut « perdre » ou « gagner » des dizaines de points simplement à cause de l'apparence de la preuve.
Autre détail issu du scoring primaire : chez 7 des 9 modèles, les entrées dans le style ChatGPT obtiennent des scores ponctuels plus élevés que le dialogue brut. C'est sans doute la conclusion la plus gênante pour ceux qui bâtissent des métriques sur un historique de conversation « pur ».
Le juge non plus n'est pas la vérité révélée
Un autre volet : que se passe-t-il si l'on recalcule les évaluations non pas avec un scorer automatique, mais avec un modèle-juge (judge rescoring). L'effet positif agrégé du format se maintient, mais la significativité par modèle devient mitigée. En clair : la tendance à l'échelle de tout l'échantillon ne disparaît pas, mais les affirmations ponctuelles du type « le modèle X gagne précisément grâce au format Y » ne sont plus aussi fiables après le re-jugement.
Ce n'est pas une raison pour renoncer aux juges LLM, mais c'est un bon rappel : toute évaluation de la mémoire est elle-même un instrument de mesure avec sa propre sensibilité au format d'entrée. Et si le système et le juge réagissent différemment à l'emballage des preuves, la différence peut se dissoudre dans le bruit ou, à l'inverse, produire un faux signal.
Le résultat le plus parlant : zéro contre cinquante
S'il ne fallait retenir qu'un chiffre de l'article, ce serait celui-ci. Trois modèles, qui affichaient 0 % sur les formal ledger packets, répondaient aux mêmes faits issus de natural-language entries avec une précision de 45,4 à 53,4 %.
Pas « un peu mieux », pas « dans la marge d'erreur » — de zéro absolu à une atteinte confiante dans près de la moitié des cas, sur un contenu identique. Un tel écart est difficile à expliquer par un manque de connaissances du modèle ou une mauvaise recherche : les faits étaient là, seule changeait la manière de les présenter. L'enregistrement formel, lisible par machine, s'avérait inexplicablement infranchissable pour le modèle, tandis que la même information énoncée en langage ordinaire se lisait sans problème.
Pour un ingénieur, c'est un signal pratique : si votre pipeline range la mémoire dans des blocs structurés rigides, vous pouvez systématiquement sous-estimer les capacités du modèle — et en même temps surestimer le bénéfice de la formalisation.
Dans quelle mesure cela tient
L'effet ne s'effondre pas quand les conditions se compliquent : il se maintient sous retrieval noise, c'est-à-dire quand des fragments superflus sont mélangés au contexte. Mieux, il se transpose à HotpotQA — un autre jeu de données construit autour de questions à plusieurs étapes. C'est important, car cela écarte le soupçon que tout tienne à la spécificité d'un seul benchmark de mémoire longue.
Les limites aussi doivent être gardées en tête : les modèles approximent les manières réelles de présenter, sans les reproduire littéralement, et les conclusions par modèle après le re-jugement sont mitigées. Il ne s'agit donc pas de recettes toutes faites, mais de la nécessité de simplement remarquer cette variable.
Que faire de tout cela en pratique
La conclusion des auteurs est assez directe : les rapports d'évaluation memory/RAG doivent soit indiquer quel reader-facing artifact a été utilisé, soit le contrôler explicitement. Voici à quoi cela ressemble de manière appliquée :
- Fixez le format dans la description du test. « Nous avons fait tourner le modèle sur LongMemEval » est une description insuffisante si l'on ne précise pas sous quelle forme l'historique arrivait en entrée.
- Faites tourner au moins deux ou trois formats. Un bon et un naïf (par exemple, un dialogue brut tronqué) donneront déjà une idée de la sensibilité de votre système.
- Ne comparez pas les modèles entre eux sur des emballages différents. Un écart de 20 à 30 points peut appartenir entièrement au format, et non au modèle.
- Vérifiez vos schémas de mémoire structurés. Un zéro sur un enregistrement formel alors que les mêmes faits reçoivent des réponses assurées en texte ordinaire — c'est un bug de présentation, pas de mémoire.
- Testez séparément le canal « modèle-juge ». Si l'évaluateur est lui-même sensible au format, la métrique devient biaisée.
- Tenez compte du coût du format. Les résumés et les enregistrements typés économisent des tokens ; cela a désormais un revers mesurable, qu'il vaut la peine de peser en connaissance de cause.
L'idée principale de RENDER est simple, et donc gênante : « l'évaluation de la mémoire d'un modèle » sans indication du mode de présentation des preuves est une affirmation incomplète. Un même dialogue, les mêmes questions, un même modèle, mais des réponses différentes. La différence tient à la manière dont vous lui avez montré ce qu'elle doit se rappeler.


