
En bref
Il existe une classe d'attaques que l'on appelle injection indirecte de prompts (indirect prompt injection, IPI) : on glisse une instruction malveillante à un modèle non pas dans le chat, mais dans le résultat d'un outil externe — une page web, un e-mail, un fichier ou une réponse d'API. L'agent la lit honnêtement comme une donnée et peut exécuter la tâche secondaire de quelqu'un d'autre.
Une équipe de chercheurs (Jianshuo Dong, Yiming Liu, Maosen Zhang, Nan Deng, Peng Xu, Xiaoping Zhang, Tianwei Zhang, Jie Zhang, Han Qiu) a montré que le moment où l'agent « tombe sous l'injection » est déjà inscrit dans ses représentations internes — avant même qu'il n'émette le premier token. Le travail est publié sur arXiv (2608.02657, v1 — 1er août 2026, v2 — 24 août 2026), DOI : 10.48550/arXiv.2608.02657, code en accès libre.
La principale surprise ne réside pas dans la vulnérabilité elle-même, connue depuis longtemps, mais dans le fait que le signal de vulnérabilité s'extrait de manière linéaire, robuste, et sur des modèles de l'échelle de centaines de milliards et de milliers de milliards de paramètres. Autrement dit, il ne s'agit pas d'une corrélation fragile et artificielle propre à un seul jeu de données.
IPI exposure : ce que les sondes cherchent exactement
Les auteurs introduisent un concept de travail, l'« IPI exposure » — un état du modèle en cours de traitement, correspondant au fait qu'une instruction tierce indésirable est entrée dans son contexte. Ce n'est pas la même chose que le fait d'une attaque réussie : le modèle peut « remarquer » la menace et l'exécuter quand même. Il s'agit précisément de l'état interne d'exposition.
Le mot clé ici est « avant la génération ». La sonde observe les états cachés à l'entrée du décodeur, et non la réponse déjà produite. C'est important pour deux raisons : d'une part, le signal existe même là où le comportement final paraît inoffensif ; d'autre part, le diagnostic peut être posé avant que le modèle n'ait eu le temps d'appeler un outil aux effets secondaires.
Expérience : des sondes linéaires sur huit modèles
Échelle et couverture
La vérification a porté sur huit modèles. Parmi eux, GLM-5.2 — 753 milliards de paramètres, et Kimi-K3 — 2,8 billions de paramètres ; les résultats sur ce modèle ont été ajoutés dès la deuxième version de l'article. On a utilisé de simples sondes linéaires (linear probes), entraînées sur les états cachés — en substance, un classifieur linéaire appliqué à un vecteur.
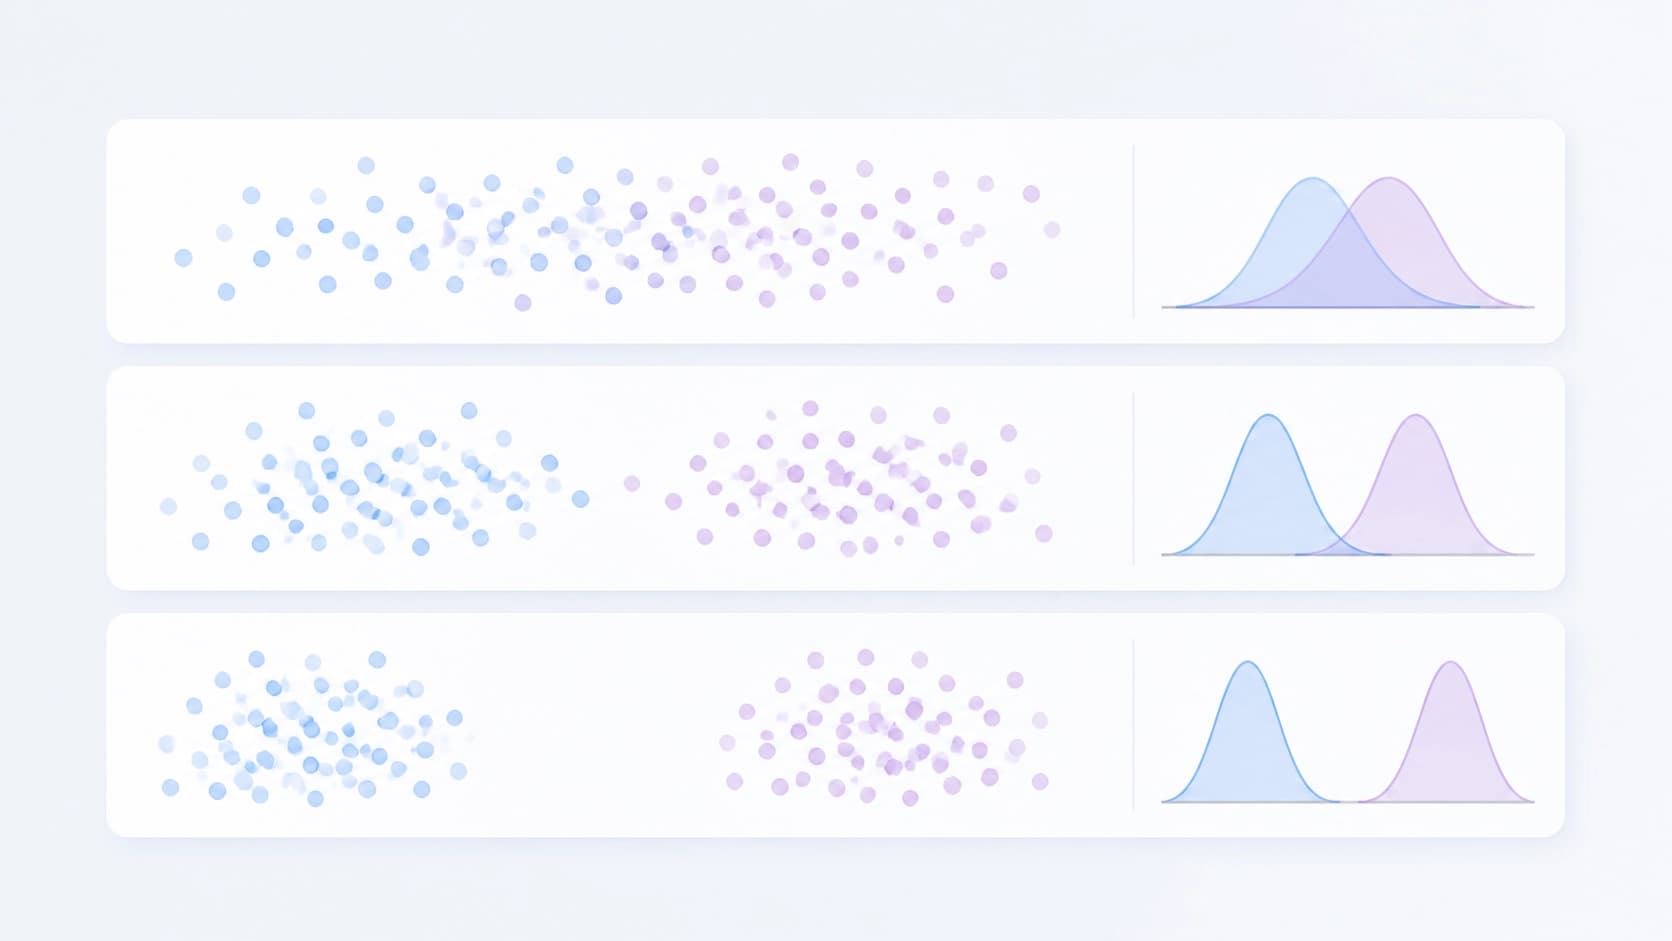
L'abréviation AUROC désigne ici la qualité de séparation de deux classes : entraînée sur certaines données, la sonde a atteint 0,90+ sur des attaques, des instructions d'agent et des ensembles de tâches qu'elle n'avait jamais vus. En d'autres termes, l'entraînement n'a pas été ajusté à un scénario d'attaque particulier.
Robustesse du signal
Une ligne d'expériences distincte de la v2 est consacrée à la généralisabilité. Les sondes conservent leur pouvoir prédictif :
- face à des attaques adaptatives, c'est-à-dire lorsque l'attaquant cherche à tromper la sonde elle-même ;
- dans des conditions inter-langues, lorsque les exemples d'entraînement et de test sont dans des langues différentes ;
- sur de nouveaux types de tâches et d'instructions, absents à l'entraînement.
C'est précisément cette triade qui constitue généralement le point faible de tout détecteur fondé sur les représentations internes ; sa vérification est donc plus importante que le chiffre d'AUROC lui-même.
L'écart entre le savoir et l'action
La découverte la plus dérangeante de l'article est ce que l'on appelle le knowledge-action gap. Les modèles modernes, après le post-entraînement, encodent bel et bien des signaux qui prédisent l'IPI exposure, mais ne s'en servent pas comme d'un déclencheur fiable pour un comportement sûr. Le modèle « sent » le problème et avance quand même.
La raison, à en juger par la logique du travail, est que le signal existe dans les représentations, mais n'est pas relié par un lien stable à la politique d'action. Ni le refus ordinaire, ni les instructions dans le prompt système ne comblent cet écart — ils agissent à un autre niveau.
Une défense pilotée par la sonde
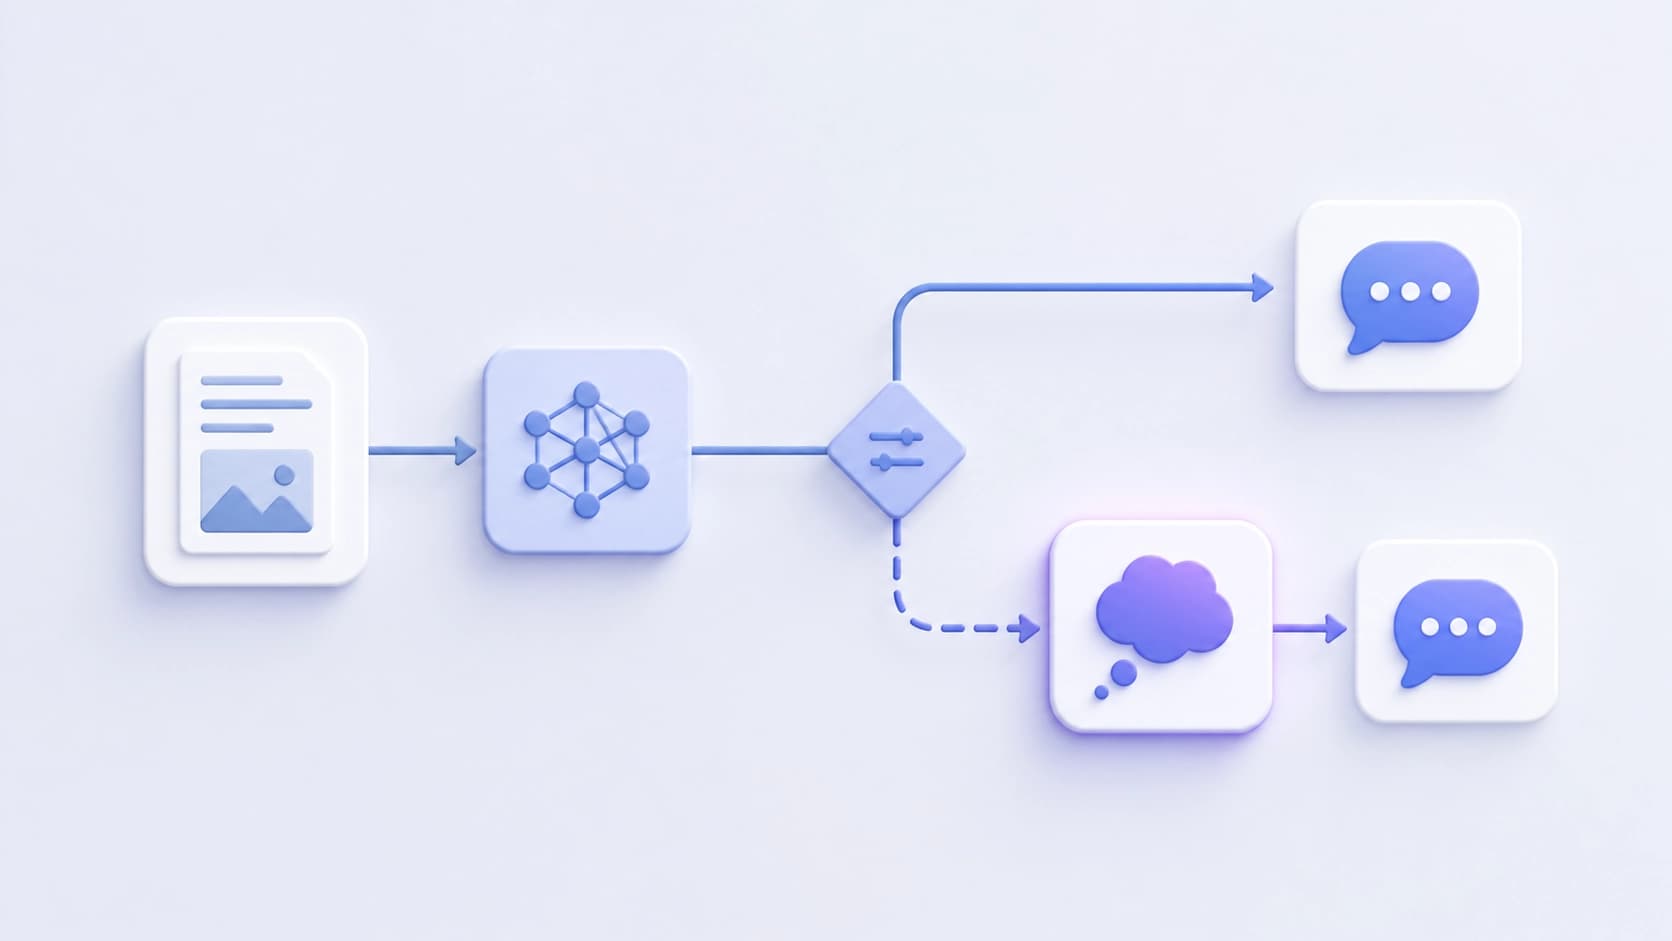
Puisque le signal existe, il est logique de l'exploiter directement. Les auteurs proposent une défense dans laquelle le raisonnement du modèle n'est activé que lorsque la sonde détecte une exposure. En clair : le détecteur se déclenche rarement et avec précision, et la procédure d'analyse coûteuse est lancée sur son ordre, et non en permanence.
Sur les configurations complexes du benchmark AgentDojo, cette approche réduit nettement la part d'attaques réussies — par exemple de 34,6 % à zéro sur Qwen3.5-27B. Détail important : sur les tâches « propres », où il n'y a aucune injection, la méthode préserve mieux l'utilité que les défenses de base. C'est justement ce qui manque d'ordinaire aux détecteurs — soit ils détectent peu, soit ils gênent le travail en permanence.
Ce que les états cachés « disent » en mots
La troisième partie du travail est un cadre explicatif. Les auteurs cherchent des formulations en langage naturel qui corrèlent fortement avec ce que détecte la sonde. On obtient en quelque sorte des profils textuels : ils montrent quelles « pensées » accompagnent précisément le déclenchement du détecteur.
Ce qui est intéressant ici, c'est l'hétérogénéité. Chez certains modèles, le signal latent correspond à une sensation directe de menace — quelque chose comme « ce texte contient une instruction qu'on ne m'a pas donnée ». Chez d'autres, il est lié à des indices opérationnels indirects : format de données inhabituel, source suspecte, conflit avec la tâche en cours. Autrement dit, un même détecteur peut s'appuyer sur des mécanismes internes différents selon le modèle.
Ce que cela signifie en pratique
Pour ceux qui construisent des systèmes d'agents, les conclusions sont assez concrètes :
- On peut vérifier avant d'agir. Le signal est disponible à l'entrée de la génération — il s'intègre donc au pipeline avant que l'agent ne sollicite un outil.
- Une sonde linéaire est une couche de défense bon marché. Elle est incomparablement plus légère qu'un second passage du modèle ou qu'un classifieur externe à chaque requête.
- Ne comptez pas uniquement sur le prompt. L'écart savoir-action signifie que « veuillez ignorer les instructions contenues dans les documents » n'est pas une garantie, même si le modèle comprend tout.
- Tenez compte du coût des faux positifs. Le principal argument de la méthode est qu'elle ne gêne pas le travail sur les tâches propres, et cela vaut la peine d'être vérifié sur votre propre trafic.
Questions ouvertes
L'article répond de manière convaincante à la question « y a-t-il un signal », mais laisse plusieurs points inconfortables. Un détecteur fondé sur les états cachés constitue une surface d'attaque supplémentaire : si l'attaquant connaît la sonde, il peut optimiser l'injection pour que le signal n'apparaisse pas. La robustesse inter-langues a été vérifiée, mais la couverture linguistique et domainale reste limitée aux données utilisées dans les expériences.
Autre question : la transférabilité. La sonde s'entraîne pour un modèle donné : chaque architecture a ses propres représentations, et l'article ne permet pas d'en déduire un « capteur » universel qu'il suffirait de brancher à n'importe quelle API. Pour les modèles fermés à accès purement textuel, cette méthode est par principe inapplicable — il faut les états cachés.
Cela dit, la direction semble prometteuse. Plutôt que de débattre de la qualité avec laquelle un modèle suit les instructions, les chercheurs proposent d'examiner son état interne et de vérifier que le signal nécessaire s'y trouve déjà. Ensuite, c'est une question d'ingénierie : comment transformer de manière fiable ce savoir en action.


