
Entraînement complémentaire de modèles génératifs d’images : prise en compte conjointe des préférences et des catégories
L’article décrit une méthode de post-entraînement de modèles text-to-image en domaine ouvert, où le signal des préférences humaines est complété par des vérifications fondées sur une grille d’évaluation, portant sur la conformité au prompt et les propriétés souhaitées. Les résultats montrent que la moyenne pondérée des récompenses est moins performante que la méthode proposée et que, sur le snapshot d’Arena, Flux2dev et Ideogram-4 après entraînement affichent une hausse notable de leur Elo.
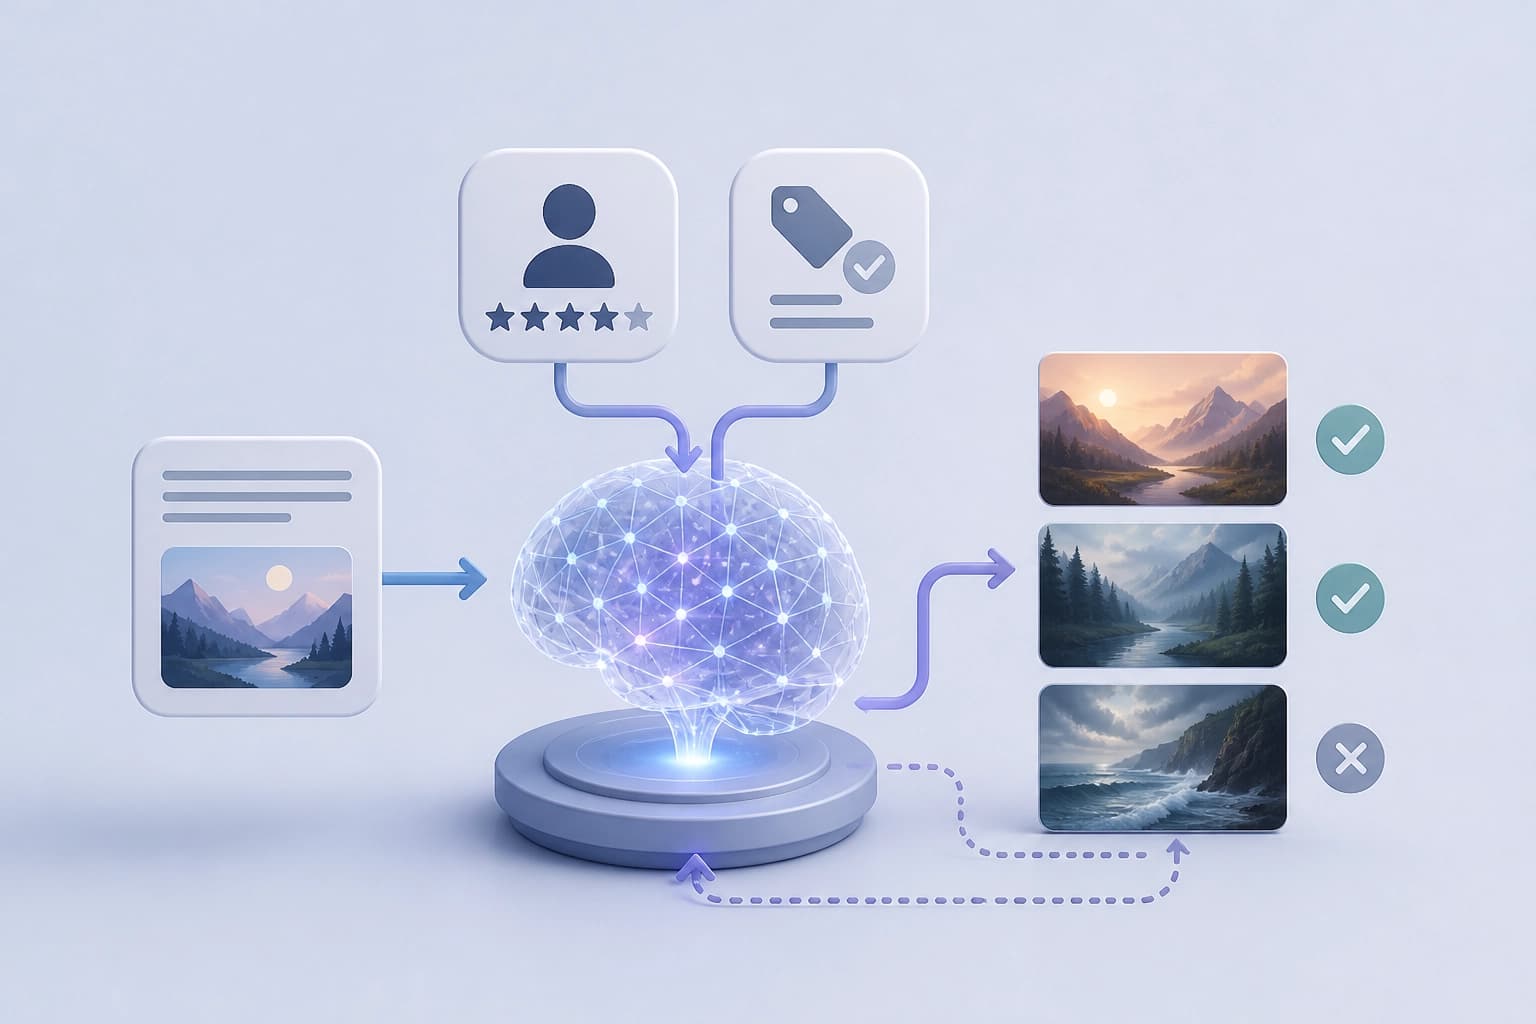
Tâche : domaine ouvert et deux signaux
La génération d’images à partir de texte en domaine ouvert doit répondre à différentes exigences. Il s’agit notamment de la conformité au prompt et des préférences humaines. Un seul signal de récompense ne couvre pas ces deux types d’exigences. L’article « Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards » propose un post-entraînement combinant des signaux complémentaires.
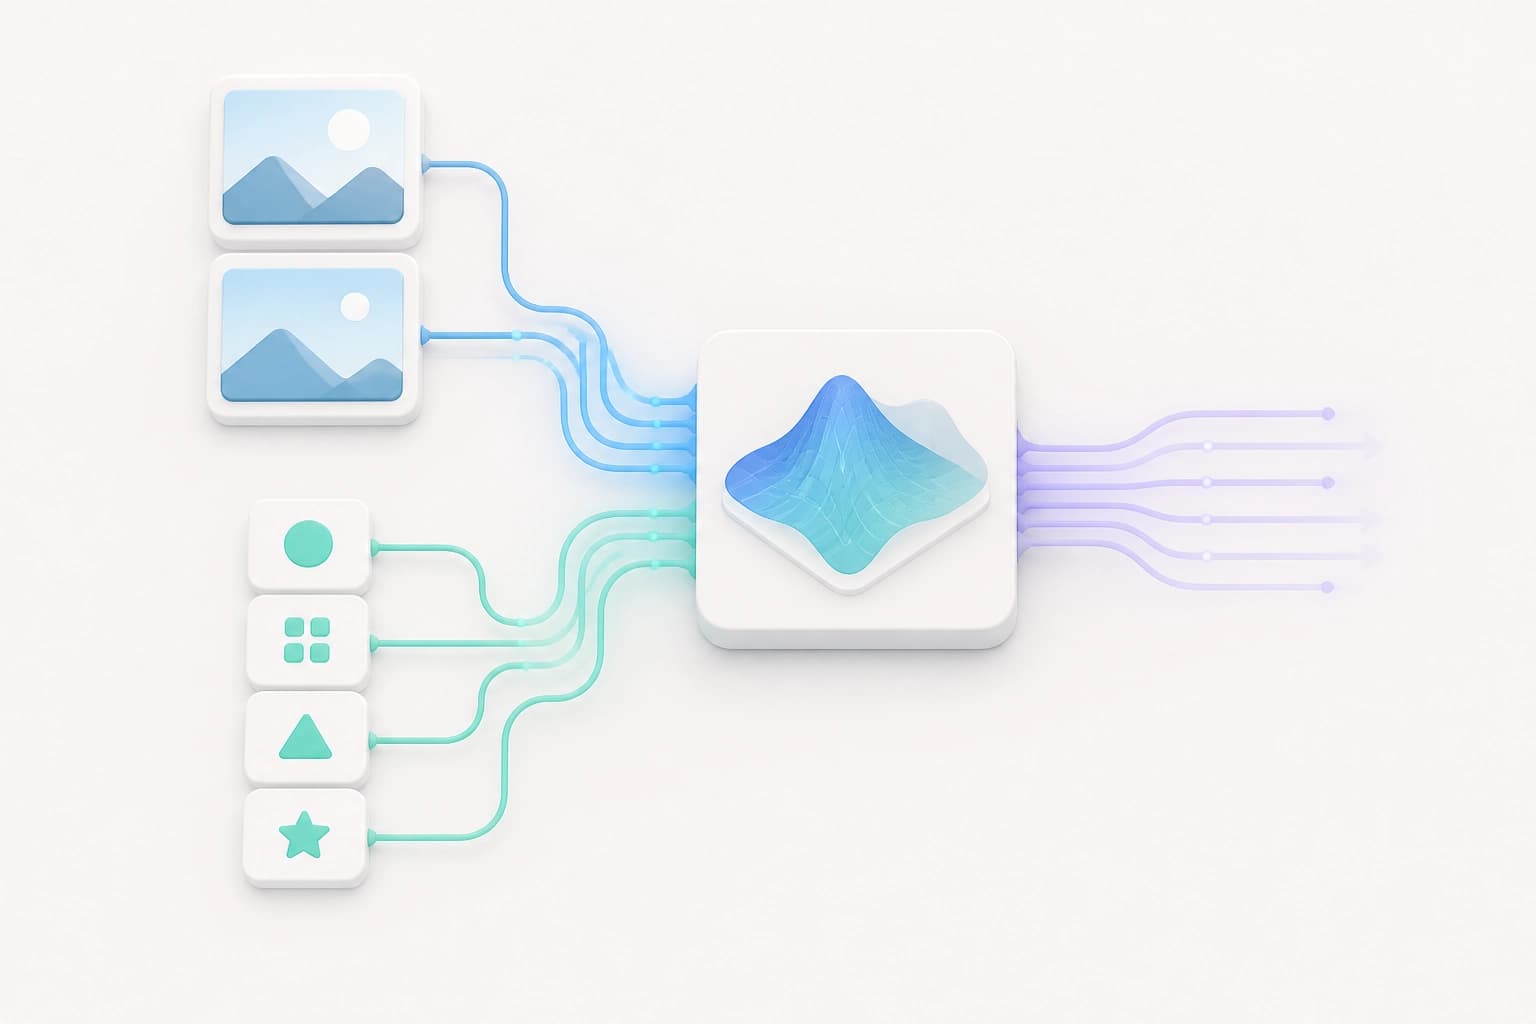
La méthode combine une récompense fondée sur les préférences et des récompenses fondées sur des grilles d’évaluation. Le premier signal reflète les préférences humaines. Le second vérifie la conformité au prompt et d’autres propriétés souhaitables. Cette combinaison couvre différentes dimensions de la requête. Conclusion : en domaine ouvert, le critère de sélection est la présence de plusieurs signaux complémentaires, et non d’un seul. Ils doivent couvrir à la fois le choix subjectif et l’exécution de la tâche.
Fonctionnement du système de récompenses
Le système comprend deux composants principaux. La récompense fondée sur les préférences est entraînée à partir d’un vaste ensemble de données de préférences humaines. L’entraînement s’appuie sur l’objectif Bradley-Terry. Ce signal reflète les choix des personnes.
Les grilles d’évaluation mesurent la conformité au prompt et d’autres propriétés souhaitables. Elles protègent également contre le reward hacking. Les composants remplissent des fonctions différentes et se complètent.
| Composant | Fondement | Ce qu’il évalue | Rôle |
|---|---|---|---|
| Récompense fondée sur les préférences | Vaste ensemble de données de préférences humaines, objectif Bradley-Terry | Les choix des personnes lors de la comparaison des résultats | Optimisation des préférences |
| Récompenses fondées sur des grilles d’évaluation | Grilles avec des critères | Conformité au prompt et autres propriétés souhaitables | Protection contre le reward hacking |
Les auteurs énoncent les exigences auxquelles doivent répondre des récompenses efficaces. Elles doivent couvrir largement les intentions des utilisateurs. Elles doivent résister à l’exploitation au cours de l’optimisation.
Conclusion : le critère de sélection est que les grilles d’évaluation complètent les préférences, au lieu de s’y substituer. Un système sans grilles d’évaluation perd sa protection contre le reward hacking. Un système sans préférences ne s’appuie pas sur les choix humains.
Combiner plutôt que calculer une simple moyenne
Les auteurs signalent un problème avec la moyenne pondérée naïve. Lors de l’optimisation, ce calcul de moyenne entraîne un comportement non optimal. L’article propose une stratégie de combinaison des récompenses. Elle équilibre plus efficacement l’optimisation des préférences et le respect des grilles d’évaluation.
| Approche | Ce qui se passe lors de l’optimisation |
|---|---|
| Moyenne pondérée naïve | Le comportement devient non optimal |
| Stratégie de combinaison | L’optimisation des préférences et le respect des grilles d’évaluation sont équilibrés plus efficacement |
La stratégie de combinaison constitue une partie distincte de la méthode. Conclusion : le critère de sélection est la présence d’une stratégie de combinaison, et pas seulement d’un ensemble de récompenses. Les poids des signaux ne garantissent pas à eux seuls le comportement souhaité.
Résultats dans le classement Arena text-to-image
Dans le classement Arena text-to-image, le modèle Flux2dev a obtenu un score Elo supérieur de 69 points à celui du modèle de base. Le modèle a été entraîné par RL. Après son post-entraînement, le modèle Ideogram-4 a surpassé tous les modèles open source. Son score Elo était de 1223.5.
Ces données montrent l’effet du post-entraînement dans le cadre du classement. Elles ne décrivent pas d’autres scénarios d’utilisation.
| Modèle | Résultat | Comparaison |
|---|---|---|
| Flux2dev entraîné par RL | Score Elo supérieur de 69 points | Modèle de base |
| Ideogram-4 post-entraîné | Score Elo de 1223.5 | Tous les modèles open source |
Conclusion : le critère d’évaluation consiste à examiner le modèle de base et les conditions d’entraînement. Pour Flux2dev, les auteurs indiquent le gain par rapport au modèle de base. Pour Ideogram-4, ils précisent sa position parmi les modèles open source.
Limites du classement et des données
Les affirmations concernant les résultats de pointe se rapportent à un instantané d’Arena daté du 4 septembre 2026. Cet instantané fixe l’état du classement à cette date. Les auteurs ont publié Arena-T2I-Training, un sous-ensemble de données d’entraînement de 1K.
Il permet de reproduire une partie des améliorations obtenues avec l’entraînement complet. Une partie des améliorations reste hors de ce sous-ensemble. Pour vérifier la méthode, il est important de distinguer le résultat complet de la partie reproductible.
Conclusion : le critère de sélection consiste à tenir compte de la date de l’instantané et des limites de reproductibilité. Une affirmation dépourvue de ces précisions reste incomplète.
Foire aux questions
Matériaux connexes
Tous matériaux
Benchmark Zero2Repo : les limites de la création autonome d’un projet à partir d’un répertoire vide
Une étude propose d’évaluer les agents de programmation sur une compilation complète du dépôt : en entrée, une spécification, un contrat d’interface et un environnement vierge ; la vérification repose sur des tests cachés, sans évaluateur LLM. Même les agents les plus performants réussissent rarement tous les tests, et la plupart des échecs sont dus à des exigences particulières qui ont été omises.
13 novembre 2026
FedSocket : des modèles échangeables dont l’exécution doit être possible chez le destinataire en contexte d’hétérogénéité multimodale
FedSocket est une approche selon laquelle le modèle échangé doit pouvoir être exécuté du côté du destinataire, tandis qu’une interface de prédiction commune Q relie des modèles privés hétérogènes. L’article décrit une agrégation tenant compte de l’appartenance, la transmission des seuls paramètres de Q accompagnés de compteurs, ainsi que des expériences menées sur six jeux de données, qui démontrent une amélioration de la précision en présence de modalités manquantes et la supériorité de l’inférence conjointe par rapport aux ensembles indépendants.
13 novembre 2026
CyberArena : les matchs en duel entre agents d’IA révèlent les limites des benchmarks de cybersécurité statiques
Le benchmark place deux agents dans des environnements isolés où les services évoluent en continu, puis agrège leurs actions au fil d’une série de manches en évaluations multidimensionnelles de leurs compétences offensives et défensives. Sur 466 matchs opposant 12 modèles récents, il a mis en évidence des différences de capacités là où les tests unilatéraux atteignent leurs limites, notamment en matière de planification sur plusieurs coups et de création de portes dérobées.
13 novembre 2026