
Ce qui a été publié en open source
Les discussions sur « quel modèle est le meilleur » se heurtent presque toujours au même problème : personne n'a vérifié les chiffres. Les mesures sont faites sur une autre machine, avec une autre quantification, dans une autre version du runtime — et les comparer entre elles n'a aucun sens. L'entreprise Liquid AI a proposé de remédier à cela par l'ouverture et la reproductibilité : elle a publié Pipette, une plateforme de benchmarking de modèles fondamentaux sur les edge devices. La méthodologie a été validée indépendamment par Artificial Analysis.
L'idée principale sur laquelle repose toute la construction : le comportement sur un appareil est une propriété du système déployé, et non du modèle isolé. Par conséquent, l'unité de mesure ne doit pas être le « modèle », mais la configuration complète : les poids, plus le schéma de quantification, plus l'environnement d'exécution, plus le matériel concret. De cette thèse découlent à la fois la structure du jeu de données et la manière de lire toutes les comparaisons ci-dessous.
Ce qui figure dans le jeu de données initial
- cinq métriques de performance sur l'appareil ;
- plus de mille configurations dans la combinaison modèle × quantification × environnement d'exécution × appareil × longueur de contexte ;
- plus de 30 modèles et plusieurs formats de quantification ;
- des builds de llama.cpp pour macOS, iOS, Windows et Android ;
- des longueurs de contexte de 256 à 8 192 tokens.
Les premières mesures publiées ont été réalisées sur un MacBook Pro avec M5 Max, un iPhone 17 Pro et un Galaxy S26 Ultra. Pour l'AMD Ryzen AI Max+ 395 et le Radeon 8060S, les résultats sont encore marqués « coming soon » — autrement dit, la plateforme est annoncée d'emblée comme multiplateforme, mais la couverture matérielle est encore en cours d'extension.
Quatre enseignements des premiers passages
Des paramètres identiques — un comportement différent sur un contexte long
Une bonne illustration de la raison d'être d'une telle mesure. Deux modèles de 350M paramètres, avec le même Q4_K_M sur le même téléphone, se comportent différemment à mesure que les tokens d'entrée augmentent : Granite-4.0-H-350M conserve 78,4 % de son débit de décodage en passant de 256 à 4 096 tokens d'entrée, tandis que Granite-4.0-350M n'en conserve que 33,8 %. Le nombre de paramètres ne nous apprend rien ici : la différence réside dans l'architecture et dans la manière dont elle s'articule avec un runtime et une puce donnés.
Une activation creuse économise du calcul, mais pas de la mémoire
LFM2.5-8B-A1B, sur le même téléphone avec 2 048 tokens d'entrée, décode 2,4 fois plus vite que Qwen3.5-4B, et 2,6 fois plus vite que Ministral-3-3B-Instruct-2512. Le secret réside dans l'activation creuse : environ 1,5B des 8,5B de paramètres sont mobilisés par token. Mais la consommation mémoire de pointe atteint 5,29 GiB, car tous les poids des experts doivent de toute façon résider intégralement en mémoire. Conclusion pratique : les architectures de type MoE gagnent en temps, mais ne sauvent pas le budget RAM — et sur un téléphone, la limite se heurte souvent précisément à la mémoire.
Plus rapide ne veut pas dire de meilleure qualité
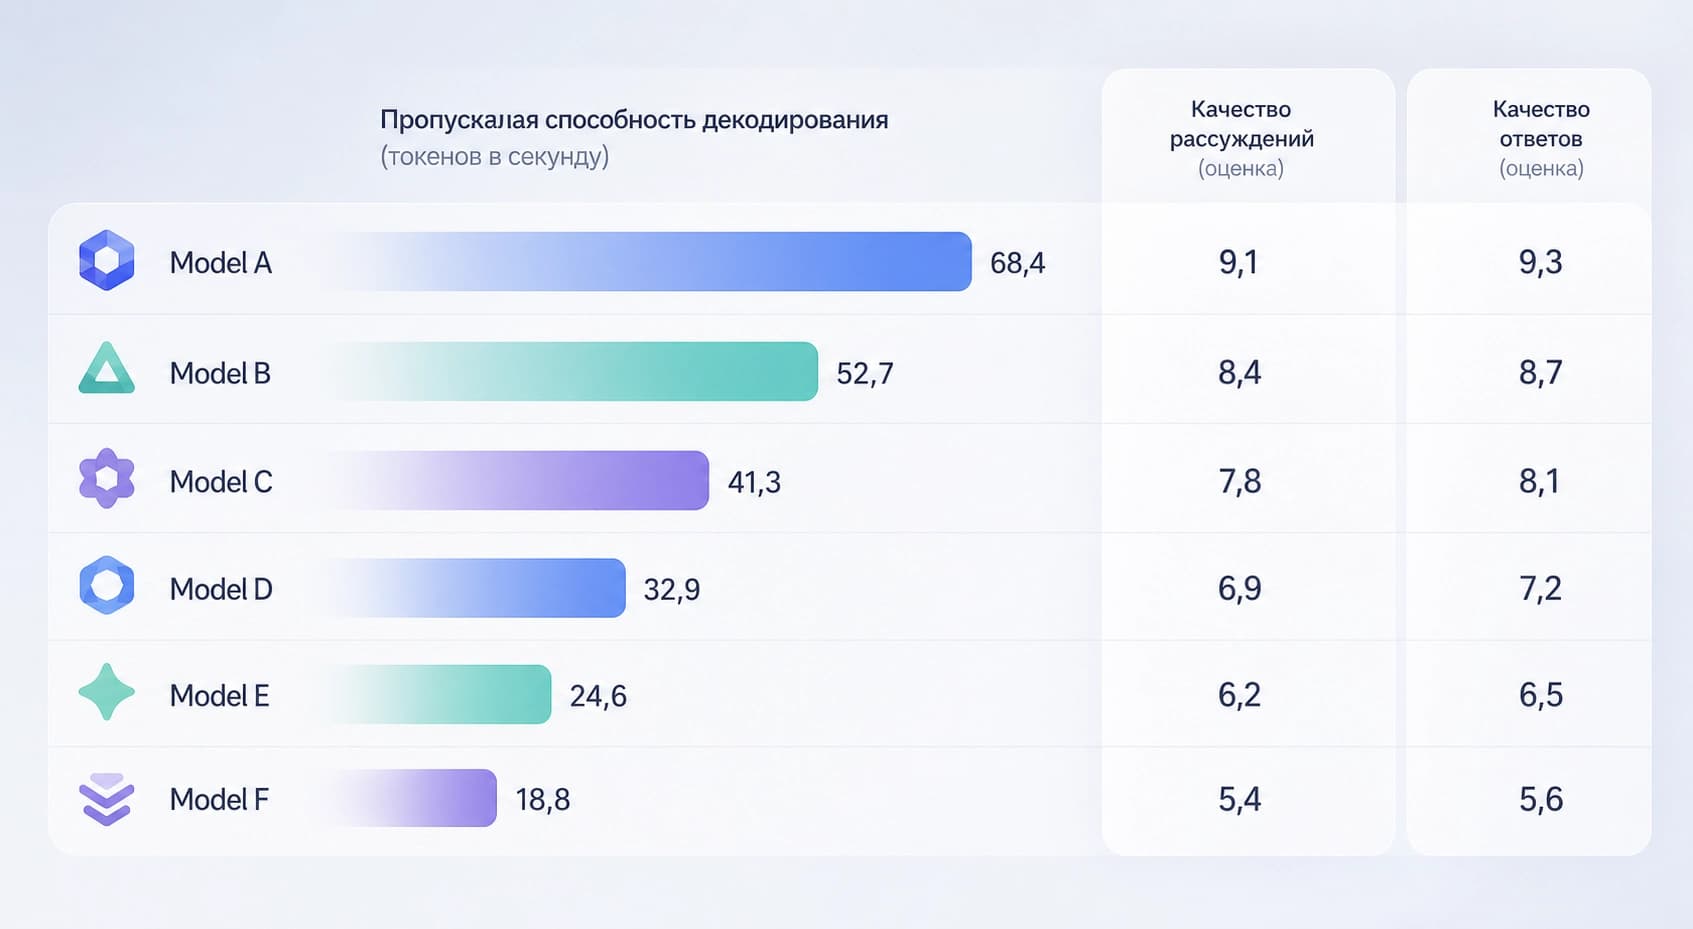
Sur l'iPhone 17 Pro avec Q4_K_M, MiniCPM5-1B exécute une charge de 2 048 tokens d'entrée / 256 de sortie en 3,47 s, tandis que LFM2.5-1.2B-Instruct met 4,12 s, soit une première 15,8 % plus rapide. Cependant, sur les mêmes artefacts, LFM obtient 9,0 points de plus sur MATH-500. Le débit et la qualité sont des axes différents, et choisir un modèle sur un seul chiffre dans un tableau n'a aucun sens.
Des profils système presque identiques peuvent masquer un renversement sur les tâches
Sur le M5 Max avec Q4_K_M et 2 048 tokens d'entrée, Granite-4.1-8B et Ministral-3-8B-Instruct-2512 ne diffèrent que de 2,4 % en débit de décodage et de 1,2 % en RAM de pointe. Mais sur les tâches, le tableau change : Granite gagne 7,3 points sur IFBench, tandis que Ministral le devance de 14,0 points sur GPQA Diamond. La différence de profil « matériel » est dans la marge de bruit, la différence de comportement est fondamentale.
Comment les mesures sont structurées
Les passages de performance reposent sur des formes de tokens fixes, un décodage glouton, un échauffement écarté et cinq répétitions mesurées. Avant chaque répétition, un readiness gating s'active : une vérification propre à la plateforme s'assure que les conditions thermiques et la charge en arrière-plan sont conformes à la norme. Les passages échoués ne sont pas publiés — c'est précisément ce qui distingue un benchmark reproductible d'un script ponctuel.
Un autre volet est celui de la qualité. Elle n'est pas mesurée par le même passage : on utilise pour cela IFBench, GPQA Diamond et MATH-500, et les scores proviennent d'exécutions d'évaluation de llama.cpp sur des systèmes de référence avec NVIDIA H100 80GB. Ils sont ensuite confrontés aux passages sur l'appareil pour le même modèle et la même quantification. Conséquence importante : le chiffre de qualité placé à côté du débit d'un téléphone n'a pas été obtenu sur le téléphone. C'est une métrique pratique pour comparer les modèles entre eux, mais ce n'est pas une mesure de ce qui se passe sur un smartphone concret.
Ce qui est précisément publié en open source
Pipette est fourni intégralement, sans liste d'attente :
- une infrastructure sous Apache 2.0 — les dépôts pipette-mgmt, pipette-clients et pipette-scores ;
- un jeu de données public de résultats ;
- un tableau de bord hébergé ;
- des applications natives de benchmarking sur iOS et Android.
La seule partie qui n'est pas encore prête pour un accès général est la publication des résultats envoyés par la communauté : elle est en bêta. Tout le reste peut être lancé de manière autonome, y compris le déploiement du pipeline au sein de son propre périmètre.
À qui et pourquoi cela s'adresse
La façon la plus simple de décrire le public cible : toute équipe qui déploie un modèle sur du matériel qu'elle ne possède pas elle-même. Ensuite, les variantes diffèrent selon l'échelle.
- Un développeur solo et une startup au stade seed se contenteront du tableau de bord et des applications mobiles — aucune infrastructure propre n'est nécessaire.
- Une équipe produit de taille moyenne peut déployer les clients sur un parc interne d'appareils et obtenir des mesures sur sa propre configuration.
- Les grands OEM, les fabricants de puces et les entreprises peuvent garder tout le pipeline derrière un pare-feu — ce qui lève les questions sur la destination des données de mesure.
Les cas d'usage typiques sont eux aussi évidents sans explications superflues : choisir un modèle et un format de quantification avant que les tâches du sprint ne soient figées ; justifier l'achat d'un SoC ou d'un équipement ; détecter une régression lors d'une mise à jour du runtime, de l'OS ou d'un pilote ; planifier la capacité en fonction de la longueur de contexte ; vérifier indépendamment les promesses publicitaires des fournisseurs. Les secteurs concernés — l'électronique grand public et les OEM de smartphones, l'automobile, l'industrie et la robotique, les dispositifs médicaux, les services financiers, la défense : partout où la latence, la confidentialité ou l'absence de connexion obligent à exécuter le modèle directement sur l'appareil.
Ce qu'il faut examiner avant de faire confiance aux chiffres
Trois choses que l'on oublie facilement à la lecture de n'importe quel tableau de mesures.
Premièrement, les chiffres de qualité et les chiffres de performance proviennent d'endroits différents. Le débit est mesuré sur l'appareil, la qualité — sur un système de référence avec H100, puis mise en correspondance. Pour comparer des modèles, c'est correct ; pour prédire le comportement dans une application concrète, non.
Deuxièmement, la quantification ne peut pas être mise entre parenthèses. Un même format, sur des modèles et des runtimes différents, donne un résultat différent, et la contrainte de mémoire devient souvent décisive — comme dans l'exemple de l'activation creuse, où la vitesse a augmenté mais où les 5,29 GiB n'ont pas disparu.
Troisièmement, une performance identique ne dit rien de la manière dont les modèles s'acquitteront de tâches concrètes. Le renversement de Granite et Ministral sur IFBench et GPQA Diamond avec des profils système presque identiques — c'est exactement le cas où il faut d'abord définir la tâche, et seulement ensuite regarder les tableaux.


