
Neptuna : comparaison d’architectures de ML pour des écoulements multiphasiques compressibles avec discontinuités
Découvrez Neptuna, un vaste benchmark regroupant 3 To de calculs pour étudier l’effondrement de bulles et la fragmentation de gouttes sous l’effet d’ondes de choc, qui met à l’épreuve des modèles convolutifs, spectraux, transformeurs et préentraînés pour les EDP. Conclusion : il n’existe pas de modèle universellement supérieur, tandis que les fonctions de perte composites et SoftAdapt aident à mieux préserver les interfaces et à reproduire le spectre avec davantage de précision.
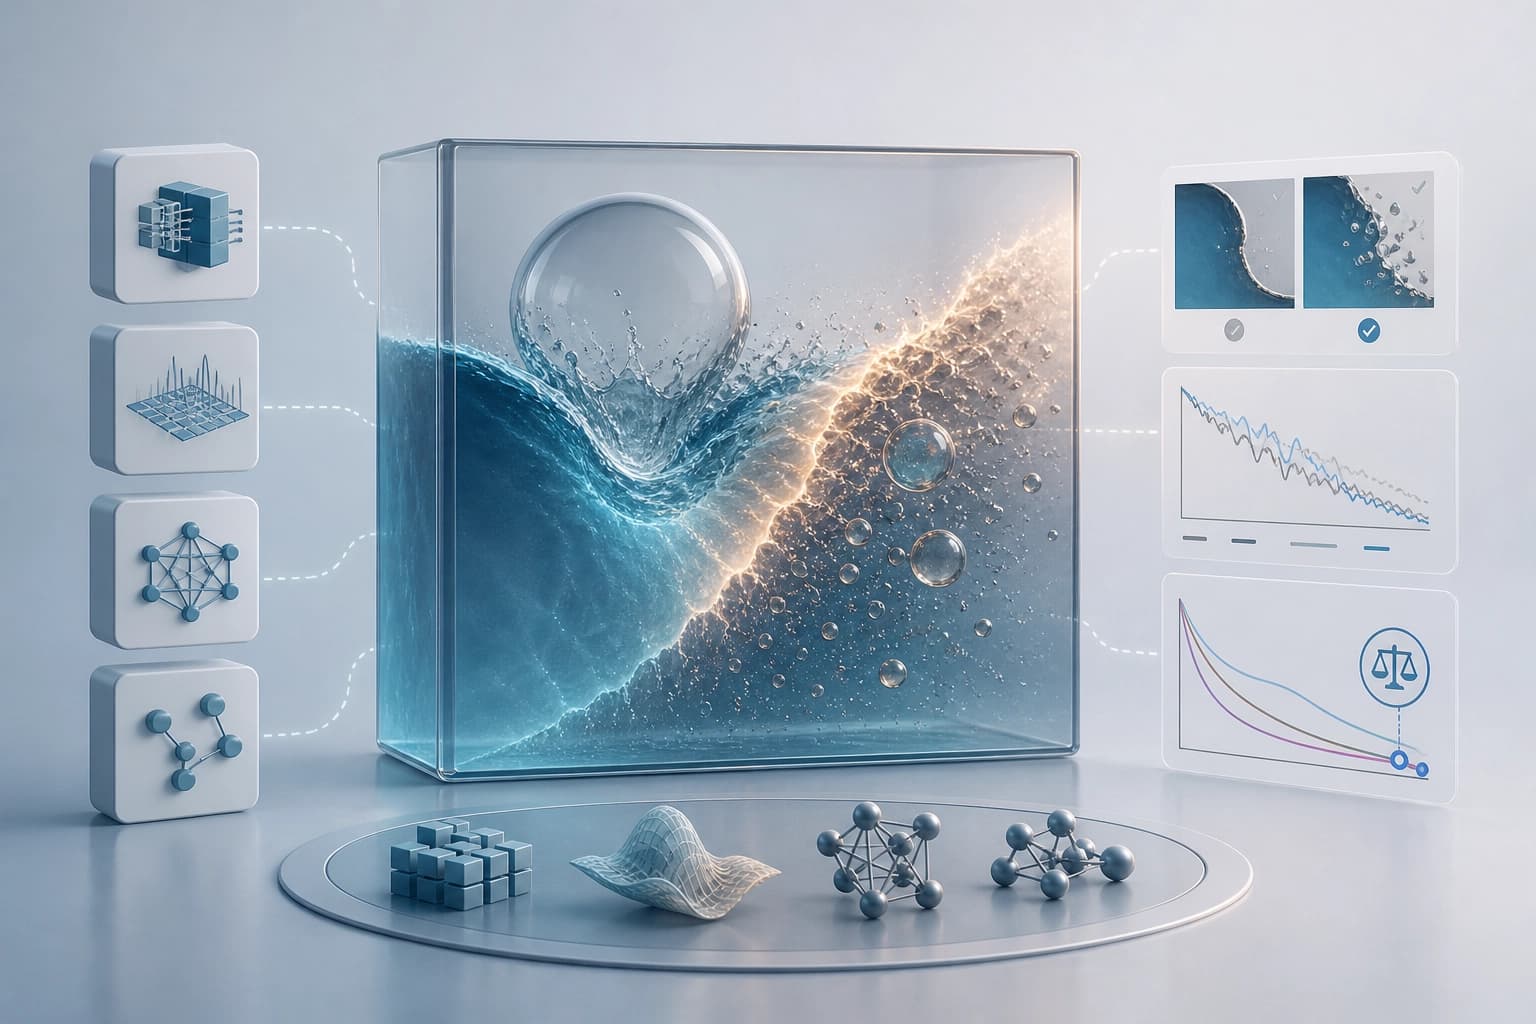
Objectif du benchmark
Neptuna est le premier benchmark à grande échelle consacré aux écoulements multiphasiques compressibles soumis à des ondes de choc. Il a été créé pour comparer des modèles de ML sur des données comportant des ondes de choc et des interfaces entre matériaux. Le benchmark évalue non pas une seule architecture, mais une combinaison d’architecture, de fonction de perte et de métriques.
| Composant de l’évaluation | Options |
|---|---|
| Architectures | convolutives, spectrales, transformers, modèles de fondation PDE |
| Fonctions de perte | MSE, fonctions composites, SoftAdapt, GradNorm |
| Métriques | ponctuelles, spectrales, orientées caractéristiques, structurelles, tenant compte de la physique |
Conclusion : le benchmark fournit un cadre commun pour des comparaisons reproductibles. Critère pratique : l’utiliser pour comparer des modèles sur les mêmes données et avec les mêmes métriques.
Données et physique
Le benchmark comprend 3 TB de données 2D et 3D de haute précision. Les données décrivent l’effondrement de bulles et la fragmentation de gouttes provoqués par des ondes de choc. Ces écoulements comportent des ondes de choc et des interfaces entre matériaux.
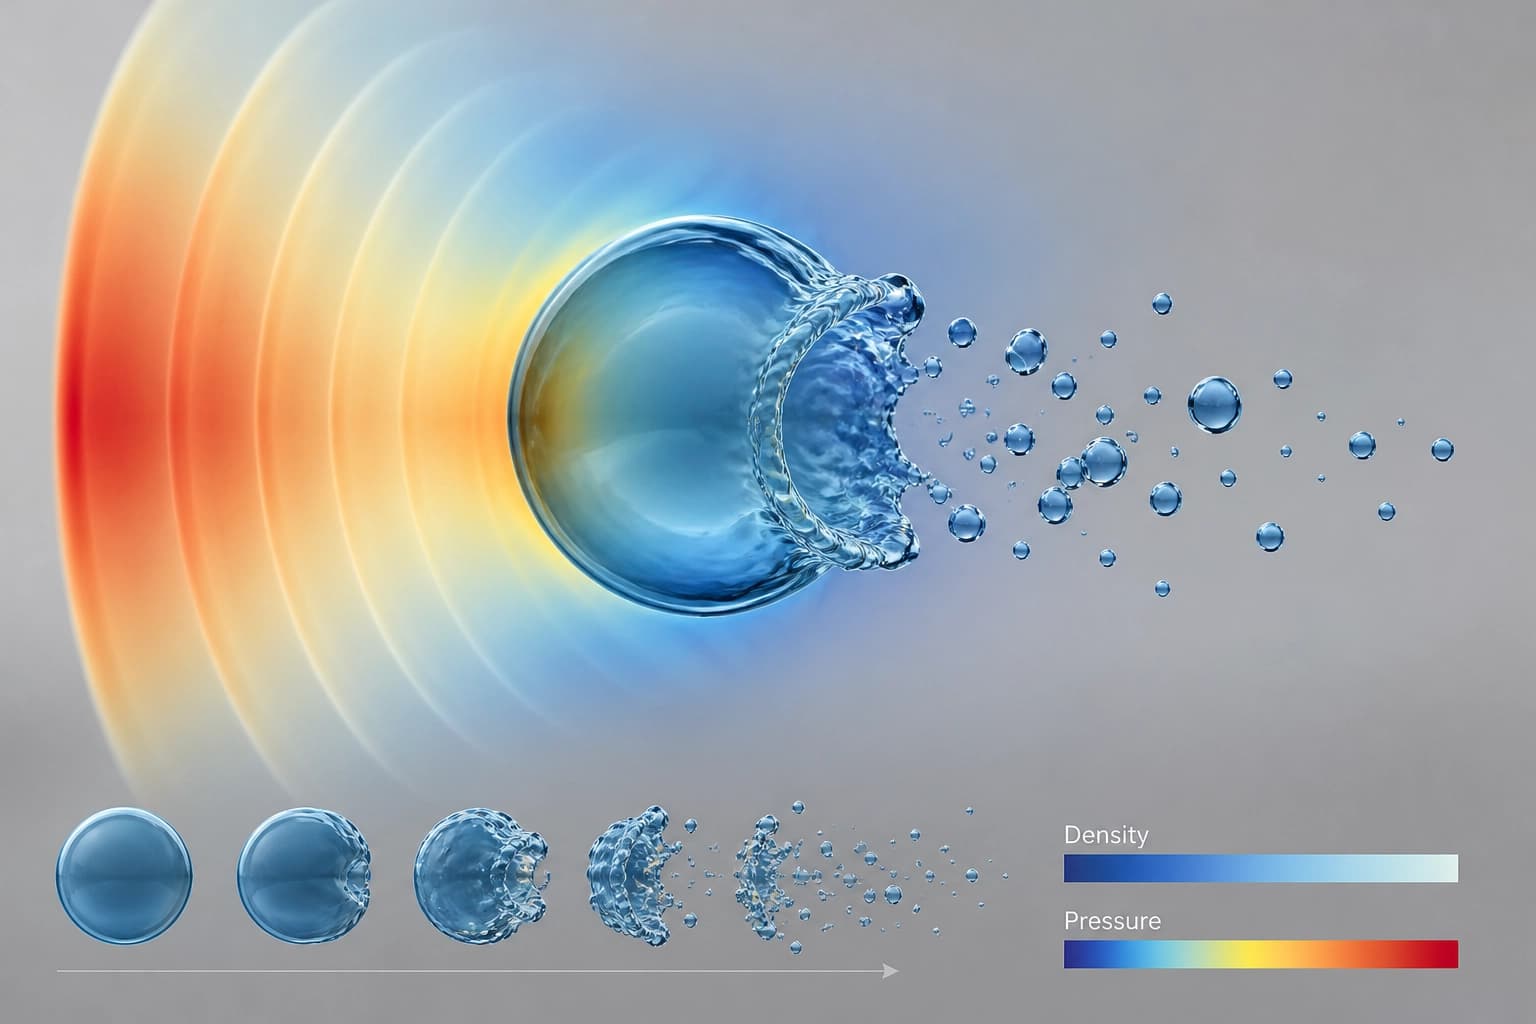
Les fortes interactions non linéaires entraînent une déformation complexe des interfaces, du mélange et une dynamique à plusieurs échelles. Trois facteurs compliquent la construction de modèles de substitution fiables :
- compressibilité ;
- discontinuités abruptes ;
- effets multiphasiques.
Ces facteurs sont présents simultanément.
Conclusion : les données mettent les modèles à l’épreuve face aux discontinuités et aux interfaces. Critère pratique : inclure dans l’évaluation des scénarios comportant des discontinuités et des interfaces.
Architectures comparées
Le benchmark a évalué des modèles convolutifs, spectraux et fondés sur des transformers. Des modèles de fondation PDE préentraînés ont également été inclus dans l’évaluation. Le benchmark teste ces familles sur des écoulements multiphasiques compressibles comportant des discontinuités.
La comparaison couvre différentes approches de construction de modèles de substitution. Elle ne se limite pas à une seule famille. Les architectures sont évaluées sur les mêmes données et avec les mêmes métriques.
Conclusion : le choix de l’architecture dépend de la tâche, et non du nom de sa famille. Critère pratique : évaluer l’architecture sur le jeu de données où elle sera utilisée.
Fonctions de perte
L’entraînement standard du benchmark utilise la MSE. Des fonctions de perte composites ont également été testées. Elles combinent la MSE avec des composantes Sobolev, tenant compte des interfaces et de la structure.
SoftAdapt et GradNorm ont été utilisés pour équilibrer les pertes de manière adaptative. Le benchmark inclut les deux options.
| Option | Composition |
|---|---|
| MSE | Fonction de perte de base |
| Fonctions composites | MSE + Sobolev + prise en compte des interfaces + prise en compte de la structure |
| SoftAdapt | Équilibrage adaptatif des pertes |
| GradNorm | Équilibrage adaptatif des pertes |
Conclusion : le choix de la fonction de perte dépend de la métrique cible. Critère pratique : pour évaluer l’équilibrage adaptatif, inclure SoftAdapt et GradNorm.
Métriques d’évaluation
L’évaluation comprend cinq groupes de métriques :
- ponctuelles ;
- spectrales ;
- orientées caractéristiques ;
- structurelles ;
- tenant compte de la physique.
L’ensemble de métriques est multidimensionnel. Conclusion : un modèle ne peut pas être jugé à l’aune d’une seule métrique. Critère pratique : déterminer à l’avance quel groupe de métriques est essentiel pour la tâche.
Résultats de la comparaison
Aucun modèle ne s’est révélé le meilleur sur tous les jeux de données et pour toutes les métriques. Ce résultat concerne différentes architectures et configurations. Les fonctions de perte composites améliorent considérablement la préservation des interfaces et la précision spectrale.
SoftAdapt apporte les améliorations les plus régulières, avec presque aucun coût de calcul supplémentaire par rapport à un entraînement utilisant uniquement la MSE. GradNorm a également été inclus dans l’évaluation. Aucun modèle ne s’impose comme vainqueur unique sur tous les critères.
| Éléments comparés | Conclusion |
|---|---|
| Architectures | Aucune n’est la meilleure sur tous les jeux de données et toutes les métriques |
| Fonctions de perte composites | Améliorent la préservation des interfaces et la précision spectrale |
| SoftAdapt | Améliorations les plus régulières, avec presque aucun coût supplémentaire |
Conclusion : le choix dépend du jeu de données et de la métrique. Critère pratique : déterminer la métrique essentielle, puis tester la fonction de perte et l’architecture sur le jeu de données cible.
Statut et accès
Les travaux sur Neptuna ont été acceptés à NeurIPS-2026 (Evaluations and Datasets Track). L’article a été soumis le 24 juillet 2026 (v1) ; la dernière révision date du 18 octobre 2026 (v3). arXiv:2607.22280.
Le dépôt du benchmark et le jeu de données sont accessibles via this https URL. Cela permet de reproduire l’évaluation et de comparer les modèles aux résultats du benchmark.
Conclusion : le benchmark est disponible pour une évaluation pratique. Critère pratique : utiliser le dépôt comme base pour des comparaisons reproductibles.
Foire aux questions
Matériaux connexes
Tous matériaux
Invariants polynomiaux canoniques pour le diagnostic des défaillances des simulateurs RL : où sont-ils vraiment utiles
Ce travail évalue la pertinence d’intégrer les lois physiques dans des modèles de dynamique entraînables : les invariants extraits des trajectoires et mis sous forme canonique à l’aide de bases de Gröbner n’apportent qu’un gain modeste en matière de prédiction, mais se révèlent très utiles pour le diagnostic — ils permettent de localiser la contrainte violée et d’identifier le paramètre erroné.
10 novembre 2026
AURA-Eval : comment vérifier qu’un agent LLM a reconnu le risque et modifié l’étape suivante
Le framework évalue le comportement des agents LLM non pas d’après leur verdict final, mais selon leur réaction au risque aux étapes clés : les trajectoires d’appels aux outils sont interrompues, puis le modèle doit poursuivre son raisonnement et son action, tandis qu’un panel de juges LLM examine la détection du risque, sa nature et la sécurité de l’étape. Sur 1 249 tâches issues de 157 trajectoires R-Judge, les actions dangereuses deviennent plus fréquentes chez 20 modèles en l’absence de voie sûre, et la levée de la supervision avant l’exécution fait basculer 52,3 % des cas initialement sûrs dans la catégorie des cas dangereux.
10 novembre 2026
Mémoire du réservoir de Chern-Simons : dynamique autonome de la connectivité et transfert de densité
L’article explique comment un réservoir conserve l’historique des signaux d’entrée à la fois dans la distribution de densité et dans les degrés de liberté géométriques. La comparaison de quatre mécanismes montre que le courant crée une composante de connectivité distincte, qui modifie la réponse ultérieure de la densité, tandis que la prise en compte de toutes les caractéristiques mesurées apporte un léger gain dans le décodage de l’ordre des impulsions.
10 novembre 2026