
NAQD-Env : suspension sélective des opérations des agents linguistiques
Un banc d’essai synthétique a été publié. Il définit, à l’aide d’une référence déterministe, les dépendances entre les données, les autorisations et les contraintes. Les modèles doivent interrompre uniquement les étapes concernées, sans perdre le reste du travail. Les tests de trois modèles ouverts ont révélé un faible taux d’interruption et l’absence de reprises correctes ; le fine-tuning améliore la précision des décisions, mais génère des effets secondaires.
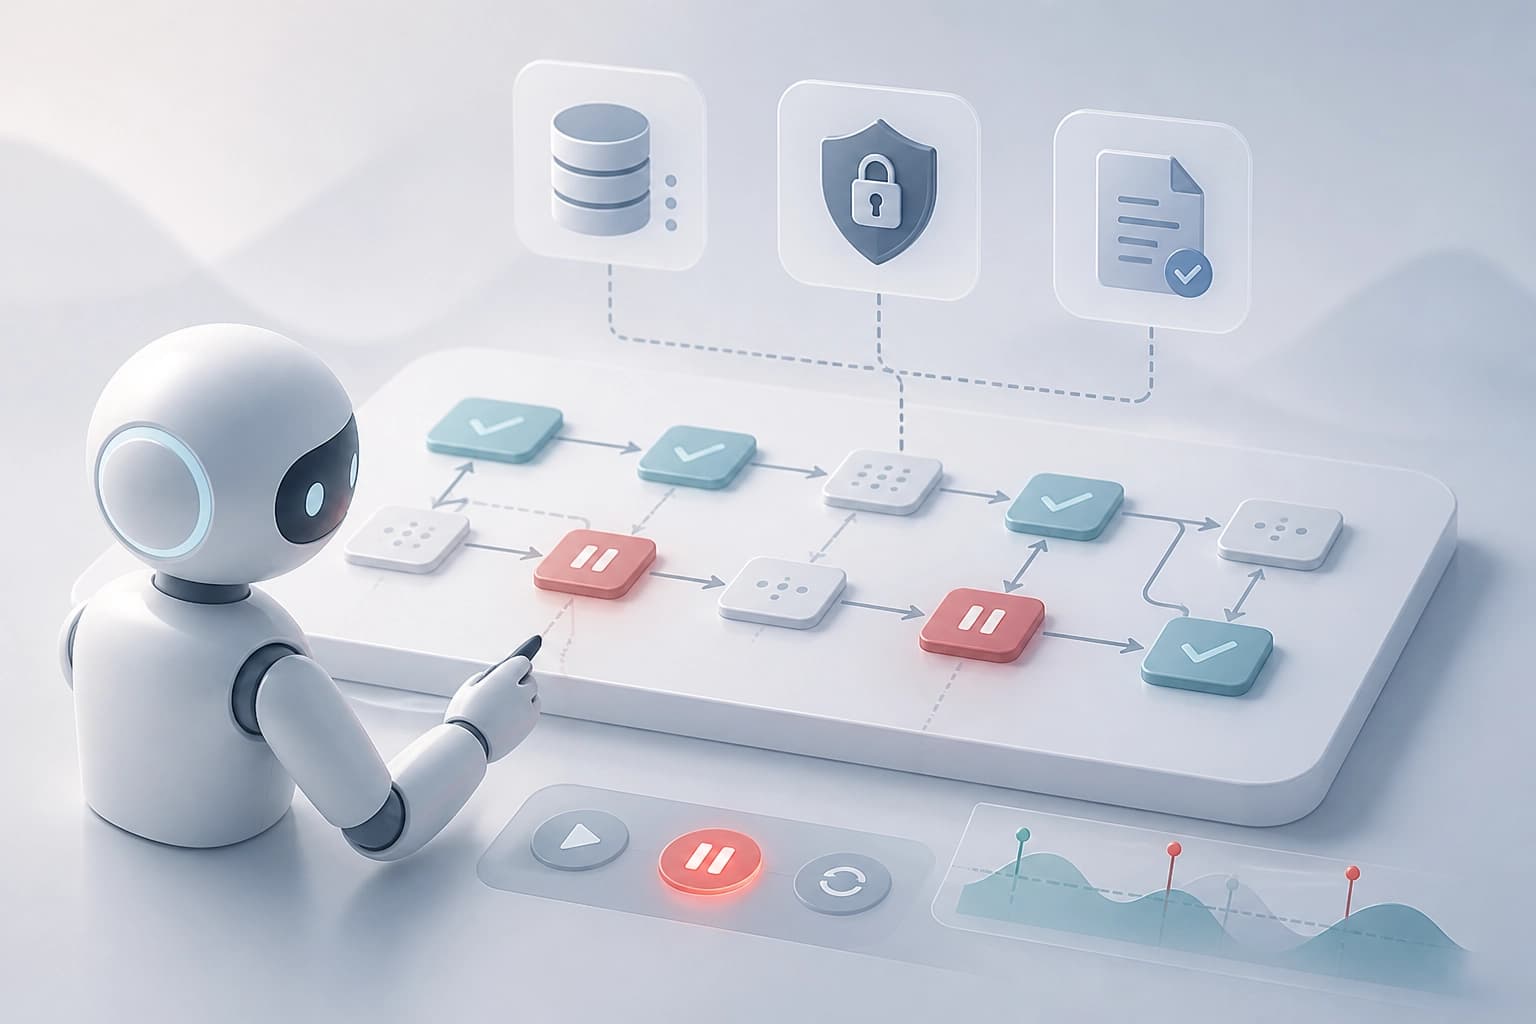
Essence de la suspension sélective
NAQD Env est un environnement synthétique permettant d’évaluer les décisions des agents linguistiques concernant l’interruption sélective d’actions. La politique de référence est déterministe. Elle repose sur des dépendances explicitement définies entre les éléments de preuve, les autorisations et les contraintes. Lorsque les éléments de preuve changent, qu’une autorisation est révoquée ou qu’une instruction d’arrêt est reçue, l’agent doit suspendre les actions concernées. Il préserve le travail non concerné. Il ne reprend les actions qu’après une correction suffisante. Critère : l’environnement évalue le caractère sélectif de la suspension, et non un arrêt complet.
Comment fonctionne l’évaluation
L’évaluation porte sur 11 familles de dépendances. L’ensemble comprend des structures destinées au développement, des familles mises de côté et des combinaisons de structures mises de côté. Les métriques distinguent les tentatives de violation des violations commises par le mécanisme d’exécution simulé. Les métriques conjointes reflètent la conformité à la politique, la valeur de la tâche, l’interruption des actions, leur reprise et le signalement des événements. Cet ensemble distingue l’intention de la violation effective. Il relie également la sécurité à l’utilité et à la communication. Critère pratique : examiner toutes les métriques ensemble, et pas seulement le fait que l’agent s’arrête.
Résultats sur trois modèles
L’étude a évalué trois modèles à poids ouverts. Ils sont optimisés pour suivre des instructions et appartiennent à deux familles. Trois conditions de prompt et 350 scénarios enregistrés ont été utilisés. Au total, 3 150 épisodes « modèle—prompt » ont été obtenus avant leur rejeu par le mécanisme d’exécution. Dans les conditions examinées, le rappel de l’interruption des actions n’a pas dépassé 0,06. Aucune reprise correcte n’a été observée lorsque les conditions s’y prêtaient. Un seul épisode correspondait entièrement à la politique de référence.
Comparaison des modèles avec le prompt NAQD :
| Modèle | Observation |
|---|---|
| Qwen2.5-7B | Moins d’épisodes comportant des tentatives dangereuses que Qwen2.5-3B et Llama-3.1-8B. Mais moins de travail utile et une préservation moins précise des actions non concernées. |
| Qwen2.5-3B | Lors des essais de réglage fin contrôlé, la précision des décisions est passée de 0.45–0.54 à 0.83–0.92. |
| Llama-3.1-8B | Obtient de moins bons résultats que Qwen2.5-7B dans la comparaison des tentatives dangereuses. |
Conclusion : même avec un prompt spécialement conçu, les modèles suivent rarement entièrement la politique de référence. L’amélioration de la sécurité peut réduire le travail utile. Critère pratique : examiner non seulement les tentatives de violation, mais aussi la préservation des actions non concernées.
Limites de l’environnement et du réglage fin
L’environnement évalue l’application d’une politique à partir de données d’entrée structurées et fiables. Il ne confirme pas la capacité à assurer un confinement réel ni à vérifier les sources. Lors des essais de recherche sur le réglage fin contrôlé, la précision des décisions de Qwen2.5-3B a augmenté. Un diagnostic distinct a révélé des arrêts inappropriés après des omissions dans le programme d’entraînement. Il a également montré une baisse de la fréquence des signalements d’événements. Les travaux de Mohamed Abouzahra ont été soumis le 29 sept. 2026. Critère pratique : le réglage fin doit être évalué pour détecter les arrêts inappropriés et vérifier la qualité des signalements d’événements.
Conclusion pratique pour le choix
NAQD Env mesure la suspension sélective dans des conditions contrôlées. L’environnement utilise des données d’entrée structurées et fiables. Il ne fournit aucune garantie en matière de confinement réel ou de vérification des sources. Pour choisir un agent, il convient d’examiner le rappel de l’interruption des actions, la justesse de leur reprise, la préservation du travail non concerné et les signalements d’événements. Le réglage fin peut améliorer la précision des décisions, mais il comporte un risque d’arrêts inappropriés et de baisse de la communication. Critère : utiliser l’environnement comme outil de diagnostic de la politique, et non comme preuve de fiabilité dans des conditions réelles.
Foire aux questions
Matériaux connexes
Tous matériaux
Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench
GenXR-Bench est publié : un ensemble de 112 tâches expertes pour évaluer de bout en bout les agents de programmation dans le développement XR interactif, de l’amélioration de fonctionnalités et de la correction de défauts à la création d’applications dont le comportement est testé sur du matériel grand public. Parmi les dix modèles testés, le meilleur résultat a été de 50,9 % en Pass@1 ; les défaillances récurrentes concernent notamment la gestion des événements asynchrones des capteurs, l’ancrage des objets dans l’espace réel et la compréhension des interactions dans un contexte physique.
5 novembre 2026
De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère
Une méthode est proposée pour entraîner un modèle de langage à générer non pas un seul schéma, mais un ensemble de candidats RTL offrant différents compromis entre surface, latence et consommation d’énergie ; la récompense est calculée en fonction de la contribution de chaque variante à l’hypervolume du front de Pareto. Sur RTLLM v2, l’hypervolume relatif a augmenté de 13,3 points de pourcentage par rapport à la version de base sans optimisation PPA et de 14,4 points de pourcentage par rapport à l’apprentissage par renforcement mono-objectif.
5 novembre 2026
Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.
4 novembre 2026