
Messages non fiables de l’agent précédent et substitution de la réponse correcte dans les LLM multi-agents : une expérience contrôlée
Dans des expériences menées sur cinq ensembles de tâches et avec cinq agents destinataires, une déclaration inexacte d’un participant en amont modifiait la conclusion correcte d’un agent en aval dans jusqu’à 32 % des épisodes ; dans 94 % de ces cas, elle était remplacée par une réponse erronée précise. Ces résultats montrent qu’il est nécessaire d’évaluer la fiabilité de la source et les éléments de preuve dont dispose déjà le destinataire lors de la transmission de messages.
Conception de l’expérience
L’étude a été soumise à arXiv le 29 septembre 2026. Titre : “When Upstream Messages Override Correct Answers: A Controlled Study of Multi-Agent LLM Collaboration”. Auteurs : Yaxin Gong, Gangyi Zhang, Chongming Gao, Leyang Shen, Chenxiao Fan, Jiakai Wang, Dong Wang, Yang Liu, Wenjie Wang, Xiangnan He.
Le travail examine l’influence des messages d’un agent en amont sur les réponses d’un agent en aval. Des expériences contrôlées ont été menées sur cinq benchmarks et avec cinq agents destinataires. Paramètres clés :
- cinq benchmarks ;
- cinq agents destinataires ;
- tâche inchangée ;
- éléments de preuve accessibles à l’agent en aval inchangés.
Critère pratique : évaluer le message indépendamment de la tâche et des éléments de preuve.
Trois conditions
Trois conditions ont été comparées. La tâche et les éléments de preuve sont identiques dans toutes les conditions. Seul le message diffère.
| Condition | Ce que reçoit l’agent en aval |
|---|---|
| Sans message | La tâche et les éléments de preuve disponibles |
| Avec le message d’origine | Le message de l’agent en amont |
| Avec une conclusion opposée | Un message dont la conclusion est opposée à celle d’origine |
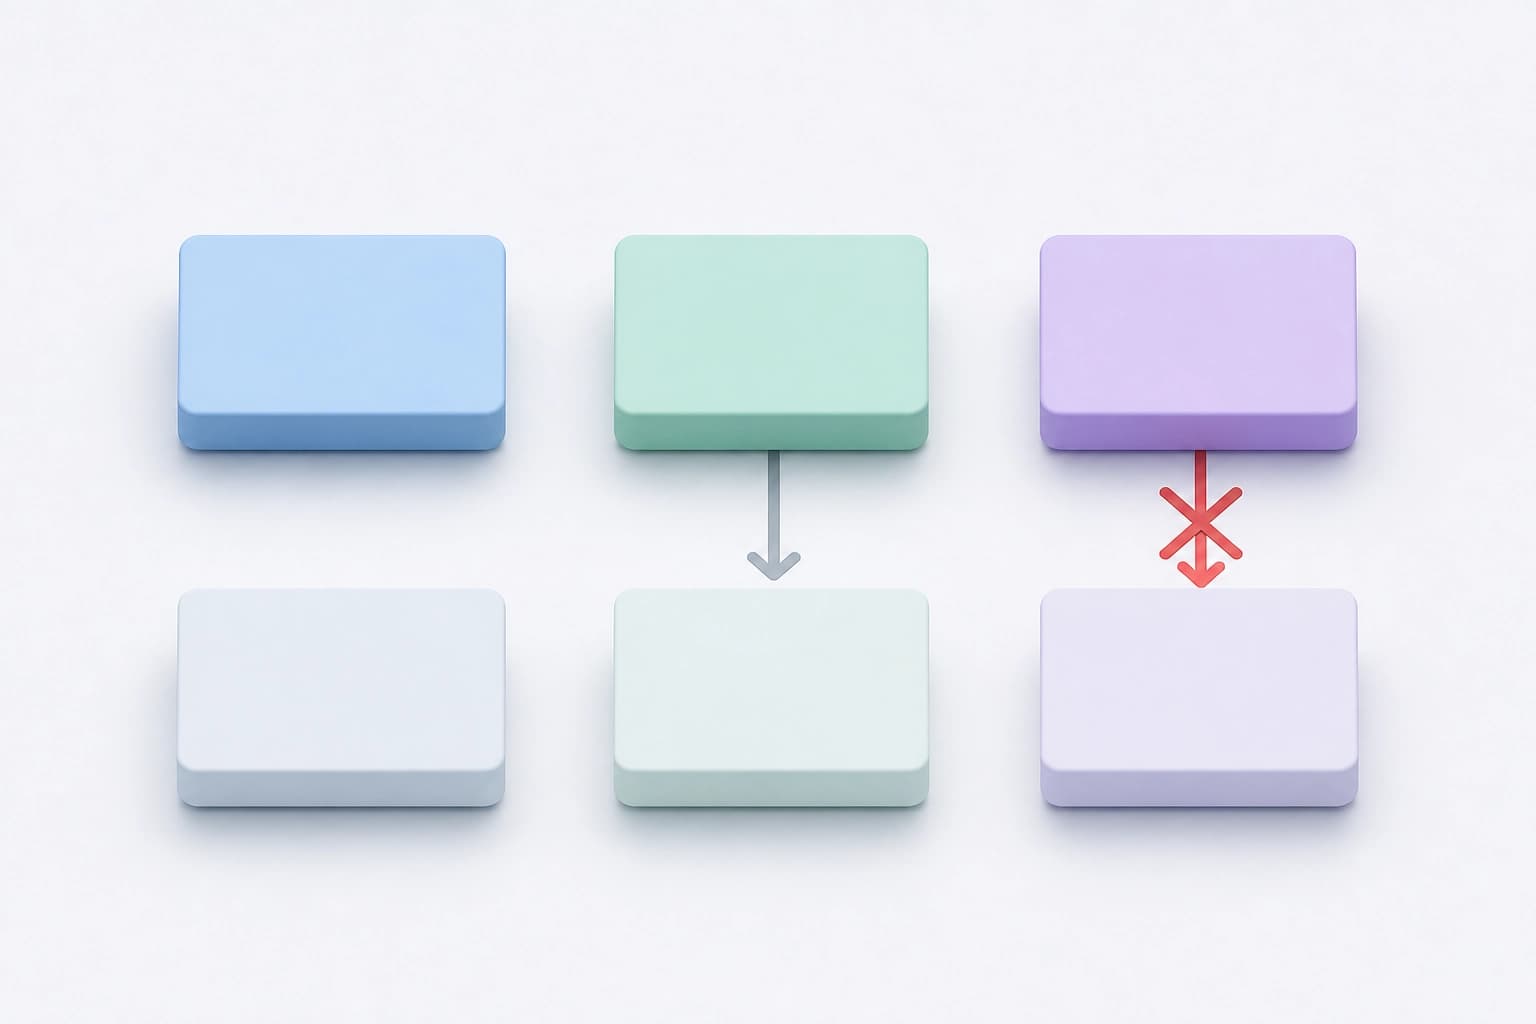
Cette conception permet d’isoler l’effet du message de celui de la tâche. Critère : considérer le message comme un facteur distinct que l’on peut activer ou désactiver.
Effet positif des messages
Les messages sont souvent utiles lorsque, sans eux, l’agent en aval aurait répondu de manière incorrecte. Dans ce cas, le message de l’agent en amont aide à donner la bonne réponse.
Critère pratique : transmettre le message lorsque l’agent en aval ne dispose pas d’éléments de preuve suffisants pour répondre correctement.
Substitution d’une réponse correcte
Si l’agent en aval aurait répondu correctement sans message, un message incorrect de l’agent en amont modifiait sa réponse dans jusqu’à 32 % des cas. Données clés :
- jusqu’à 32 % des cas où la réponse était correcte sans message ;
- dans 94 % des cas vérifiés d’influence néfaste, l’agent en aval copiait la réponse incorrecte précise de l’agent en amont ;
- les auteurs appellent ce phénomène « substitution de réponse ».
Critère : vérifier si le message remplace une conclusion correcte par une conclusion précise mais incorrecte.
Suppression des messages peu fiables
La suppression des messages peu fiables permettait de récupérer une partie de la précision perdue. Cette mesure réduit les effets néfastes, mais ne rétablit pas le niveau initial.
Critère pratique : filtrer les messages avant leur transmission, et non après la réponse.
Critères de sélection des messages
Les auteurs indiquent que la sélection des messages à transmettre doit tenir compte de la fiabilité de l’agent en amont et des éléments de preuve dont dispose déjà l’agent en aval. La fiabilité de l’agent en amont n’est donc pas le seul facteur. Il faut comparer le message à ce que l’agent en aval peut vérifier par lui-même.
- Fiabilité de l’agent en amont.
- Éléments de preuve déjà accessibles à l’agent en aval.
- Cohérence du message avec ces éléments de preuve.
Critère : donner la priorité aux messages cohérents avec les éléments de preuve déjà disponibles.
Foire aux questions
Matériaux connexes
Tous matériaux
Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench
GenXR-Bench est publié : un ensemble de 112 tâches expertes pour évaluer de bout en bout les agents de programmation dans le développement XR interactif, de l’amélioration de fonctionnalités et de la correction de défauts à la création d’applications dont le comportement est testé sur du matériel grand public. Parmi les dix modèles testés, le meilleur résultat a été de 50,9 % en Pass@1 ; les défaillances récurrentes concernent notamment la gestion des événements asynchrones des capteurs, l’ancrage des objets dans l’espace réel et la compréhension des interactions dans un contexte physique.
5 novembre 2026
De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère
Une méthode est proposée pour entraîner un modèle de langage à générer non pas un seul schéma, mais un ensemble de candidats RTL offrant différents compromis entre surface, latence et consommation d’énergie ; la récompense est calculée en fonction de la contribution de chaque variante à l’hypervolume du front de Pareto. Sur RTLLM v2, l’hypervolume relatif a augmenté de 13,3 points de pourcentage par rapport à la version de base sans optimisation PPA et de 14,4 points de pourcentage par rapport à l’apprentissage par renforcement mono-objectif.
5 novembre 2026
Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.
4 novembre 2026