
Interprétation comme dimension : le cadre mathématique MTI décrit l'incompréhension par l'entropie et la confusabilité
Blake Reynolds a présenté sur arXiv un noyau condensé de la « Théorie mathématique de l'interprétation » : la compréhension n'y est pas une propriété du texte, mais le résultat d'une mesure spectrale dépendant de l'observateur, de son accès et de la méthode choisie. Le travail introduit l'entropie rationnelle comme mesure de l'ambiguïté résiduelle et la confusabilité, qui passe d'une nuisance à une ressource de conception, ainsi qu'un certificat de qualité de lecture à quatre conditions avec des défaillances typées.
L'interprétation vit généralement dans la conversation comme une étiquette binaire : « compris » ou « pas compris ». Le travail de Blake Reynolds « A Mathematical Theory of Interpretation: Rational Entropy, Spectral Readout, and Confusability as a Resource » (arXiv:2608.23892, août 2026 ; noyau condensé de la thèse de 2026) propose de voir les choses autrement. La compréhension n'y est pas un état de conscience, mais le résultat d'une mesure dépendant de l'observateur. Et cette mesure ne se fait pas dans le vide, mais dans le cadre d'une structure d'accès : certains ont la clé des données, d'autres non, et « compris » sans précision sur l'accès perd son sens.
La publication est parue dans cs.IT avec un cross-listage dans cs.AI — et c'est en soi révélateur. L'auteur déplace la discussion sur l'interprétation du domaine de l'herméneutique vers celui de la théorie de l'information, où l'on trouve l'entropie, la capacité de canal et des modes de défaillance explicitement énumérés.
Quatre paramètres au lieu de l'intuition
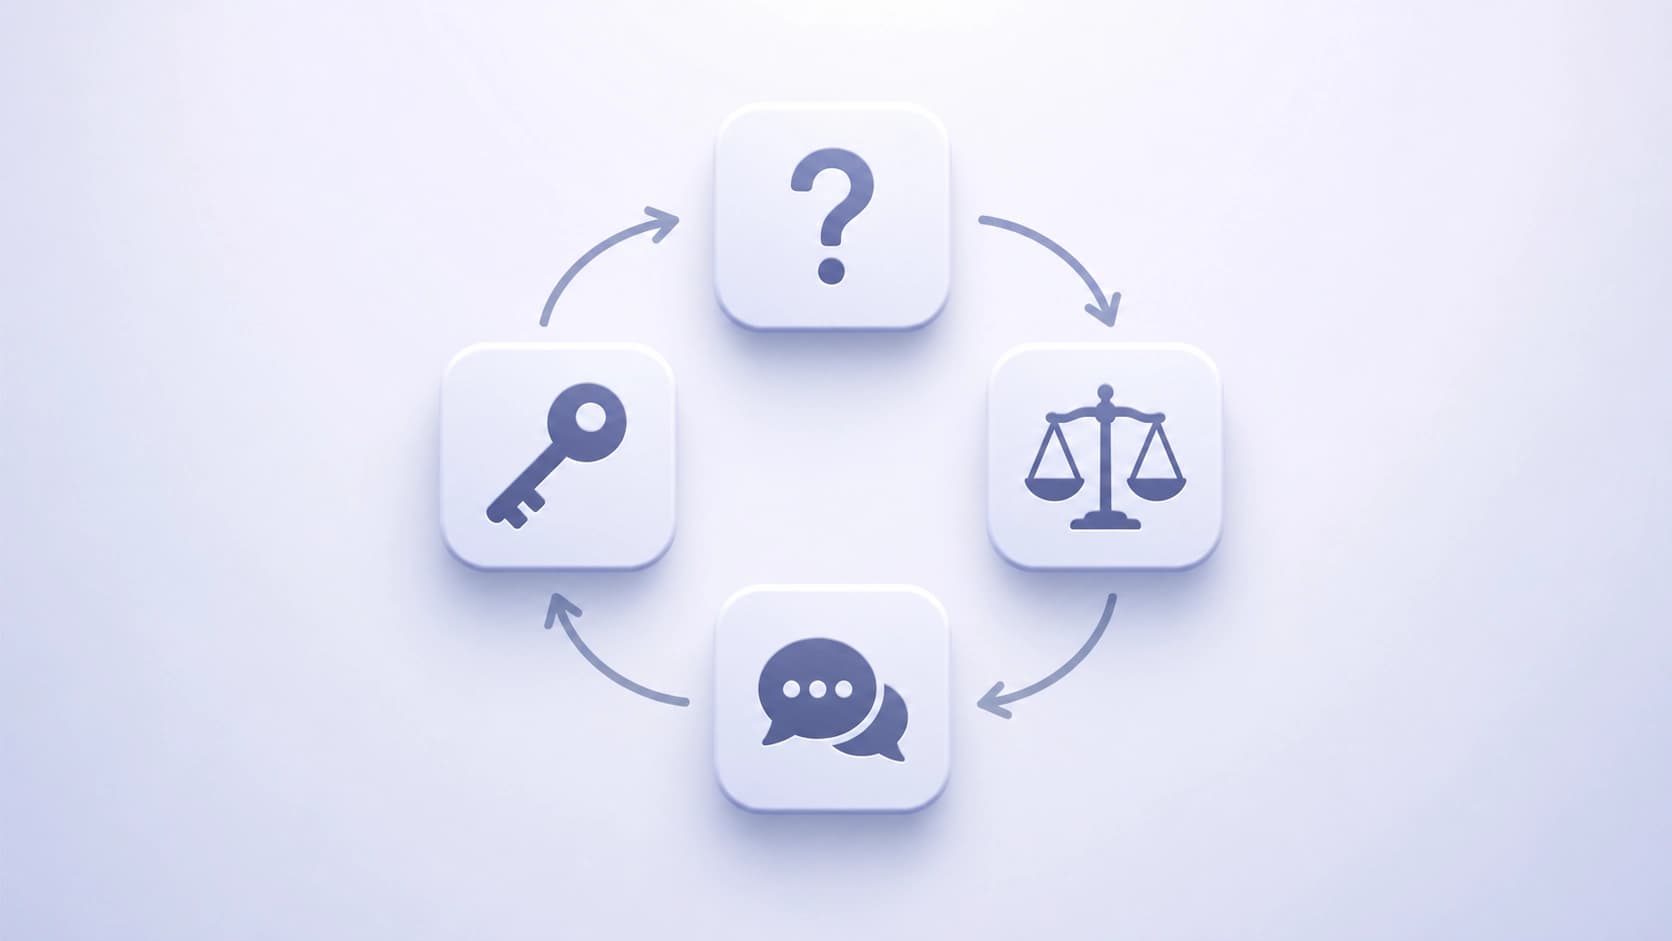
Le geste central de MTI est de transformer l'interprétation en un problème de conception de méthode. Au lieu de demander « que signifie ce signal », la théorie demande quelles possibilités s'offrent à l'observateur. Ces possibilités sont au nombre de quatre, et elles sont définies par les paramètres access, query, utility et medium :
- accès — auxquelles données l'observateur est-il seulement autorisé ;
- requête — quelles questions il a le droit de poser au système ;
- utilité — ce qui compte pour lui comme une bonne réponse ;
- support — dans quel environnement le signal se propage et se conserve.
De ce quatuor dépend ce que l'observateur peut choisir, identifier, transmettre à son tour ou, au contraire, refuser de recevoir. La conclusion pratique est assez tranchante : les débats sur la « bonne interprétation » se révèlent souvent être des débats sur des ensembles différents de ces quatre paramètres. Deux personnes peuvent regarder le même objet sans diverger dans leur logique — simplement, elles ont des quotas d'accès différents et des requêtes différentes.
Rational Entropy : combien d'incompréhension reste-t-il
La théorie passe ensuite à une grandeur mesurable. Dans l'implémentation hilbertienne learning-invariant est introduite la Rational Entropy — elle décrit l'incertitude résiduelle simultanément sur trois axes : connaissance, utilité et support. En termes simples, c'est la réponse à la question « combien reste-t-il à résoudre », et non pas en général, mais en tenant compte de ce que l'observateur sait déjà et de ce qu'il veut.
Détail important : en régime fini-effectif, les auteurs classifient l'ensemble nul de l'entropie rationnelle. Autrement dit, la théorie ne se contente pas d'introduire une mesure, elle décrit aussi quand celle-ci s'annule — quelles configurations d'accès, de requêtes et d'environnement donnent une certitude totale. Pour l'ingénierie, c'est l'endroit le plus intéressant : l'ensemble nul est la liste des conditions dans lesquelles l'incompréhension est constructivement impossible.
Pourquoi ce n'est pas une entropie ordinaire
L'entropie classique ne sait rien des objectifs de l'observateur. Ici, l'utilité entre dans la mesure elle-même, ce qui signifie que deux systèmes ayant la même statistique de signal peuvent avoir une entropie rationnelle différente — si les observateurs ont des tâches différentes. C'est gênant pour ceux qui cherchent une métrique universelle de la « compréhensibilité », mais cela décrit plus honnêtement la réalité.
La confusabilité comme ressource, et non comme défaut
Le résultat le plus contre-intuitif : la confusabilité par paire (quand deux états sont indiscernables) est équivalente à un uniform atomic collapse. Cela sonne comme une condamnation, mais le retournement commence ensuite. L'unique maximum d'utilité peut sélectionner un atome, même si tous les autres états restent non atomiques à coût nul.
Autrement dit, le rôle habituel de la confusabilité en théorie du codage se renverse. Là-bas, l'indiscernabilité est une source d'erreurs dont on se débarrasse. Ici, elle peut travailler en faveur de l'observateur : l'accord ne serait-ce que sur une direction exclut les lectures multi-atom non résolues, et l'étiquette conjointe préserve l'identification de l'objet. Si deux états « collent » dans une dimension mais se distinguent dans une autre, l'observateur retient malgré tout l'objet comme un tout.
Combien le design libre peut-il supporter
De cette logique naît une estimation quantitative. La capacité du design libre est égale au produit des budgets de toutes les directions, sauf la plus petite. La formule est courte, mais avec un accent inhabituel : la direction la plus faible n'entre pas dans le produit. Cela se lit comme une allusion au fait que le goulot d'étranglement dans l'interprétation est structuré autrement que le goulot d'étranglement dans un canal de communication — là-bas, c'est précisément le maillon le plus mauvais qui détermine le résultat, ici l'arithmétique est différente.
Un certificat en quatre conditions
Pour que les résultats ne restent pas théoriques, un certificat à quatre conditions est introduit. Il caractérise la lecture comme :
- sharp — nette, sans frontières floues ;
- decodable — permettant le décodage ;
- medium-faithful — fidèle au support, c'est-à-dire ne déformant pas l'environnement de transmission ;
- order-independent — indépendante de l'ordre des opérations.
Tout cela sur un secteur commutatif fini du code. Si au moins une condition est violée, la théorie ne renvoie pas un haussement d'épaules général, mais des obstructions typées : des indications précises sur le type exact de défaillance survenu. Pour la pratique, c'est sans doute la principale valeur du travail. Au lieu de « le modèle hallucine », un vocabulaire apparaît : ici la netteté est perdue, ici le support a déformé le signal, et ici l'ordre de traitement a brisé l'identification.
À quoi cela sert en dehors des mathématiques
MTI se présente comme un fondement théorique pour concevoir des méthodes d'interprétation avec des hypothèses explicites sur l'accès, des garanties et des modes de défaillance. Appliqué aux systèmes d'IA, c'est exactement ce qui manque souvent lors de l'évaluation des modèles : non pas une énième métrique de « qualité de réponse », mais un cadre qui oblige à formuler à l'avance qui a quel accès, quelles requêtes sont autorisées et ce qui est considéré comme utile. Alors la discussion sur l'incompréhension devient reproductible.
Ce qu'il faut garder en tête
C'est un préprint : version v1, noyau condensé de la thèse, sans cycle complet d'évaluation par les pairs. L'appareil mathématique de l'article est dense, et le résumé ne peut qu'en grossir les formulations — pour les définitions précises de l'implémentation hilbertienne et du secteur commutatif, mieux vaut se référer à la source originale.
Mais l'idée principale se transpose dans la pratique même sans les détails. L'incompréhension cesse d'être une propriété d'une personne ou d'un modèle et devient une grandeur mesurable, dépendant d'une configuration agencée d'accès, de requêtes, d'objectifs et d'environnement. La confusabilité cesse d'être uniquement un défaut et fonctionne parfois comme un appui. Et le certificat en quatre conditions donne un langage dans lequel une défaillance d'interprétation peut être nommée par son nom — au lieu de tout mettre sur le compte d'une « explication incompréhensible ».
Foire aux questions
Matériaux connexes
Tous matériaux
OpenCollab : coordination programmable d’agents, environnement d’exécution contrôlé et mesure du respect des règles
Le framework rassemble la définition de la structure d’interaction des agents, un environnement commun pour les expérimentations et une traçabilité détaillée des événements, tandis que l’indicateur Adherence introduit mesure dans quelle mesure l’exécution réelle respecte le schéma annoncé. Dans les benchmarks, la configuration Duo atteint un nouveau niveau SOTA, tandis que la variante mono-agent se distingue par la plus faible consommation de tokens.
11 novembre 2026
Toollery : sélection d’outils pour agents LLM parmi des dizaines de milliers d’options sans réentraînement
Toollery construit un index de recherche à partir des descriptions des compétences et des outils, puis ne transmet au modèle qu’un nombre limité de candidats pour chaque requête. Lors d’expériences menées sur des bibliothèques comptant jusqu’à plusieurs dizaines de milliers de fonctions, cette approche permet de maintenir la qualité de sélection avec un top-K fixe, même si l’effet final dépend du profil de charge et de la mise en cache côté fournisseur.
11 novembre 2026
WILSON : regroupement des grossissements et des lames du patient pour l’analyse pathomorphologique et la rédaction de comptes rendus
La prépublication présente WILSON, un modèle vision-langage qui encode des images de lames entières ainsi que des séries de prélèvements d’un même patient à différents grossissements, plutôt qu’une seule lame « optimale ». Sans entraînement supplémentaire pour une tâche donnée, il surpasse des modèles spécialisés et de plus grande taille dans plusieurs métriques, tout en nécessitant beaucoup moins de ressources de calcul, et ses descriptions diagnostiques ont obtenu de meilleures évaluations de la part des pathologistes.
11 novembre 2026