
Vérification des hallucinations des LLM via une vue SQL des sources, sans réentraînement
Ce travail évalue si un LLM peut mobiliser une compétence symbolique élémentaire — la création d’une base SQL à partir des documents sources — afin d’ancrer les réponses dans leurs sources sans supervision pour détecter les hallucinations. Sur RAGTruth et DiaHalu, ce pipeline neuro-symbolique se révèle plus précis que la prédiction directe et comparable aux méthodes de pointe, sans nécessiter de réglage fin spécifique au domaine.
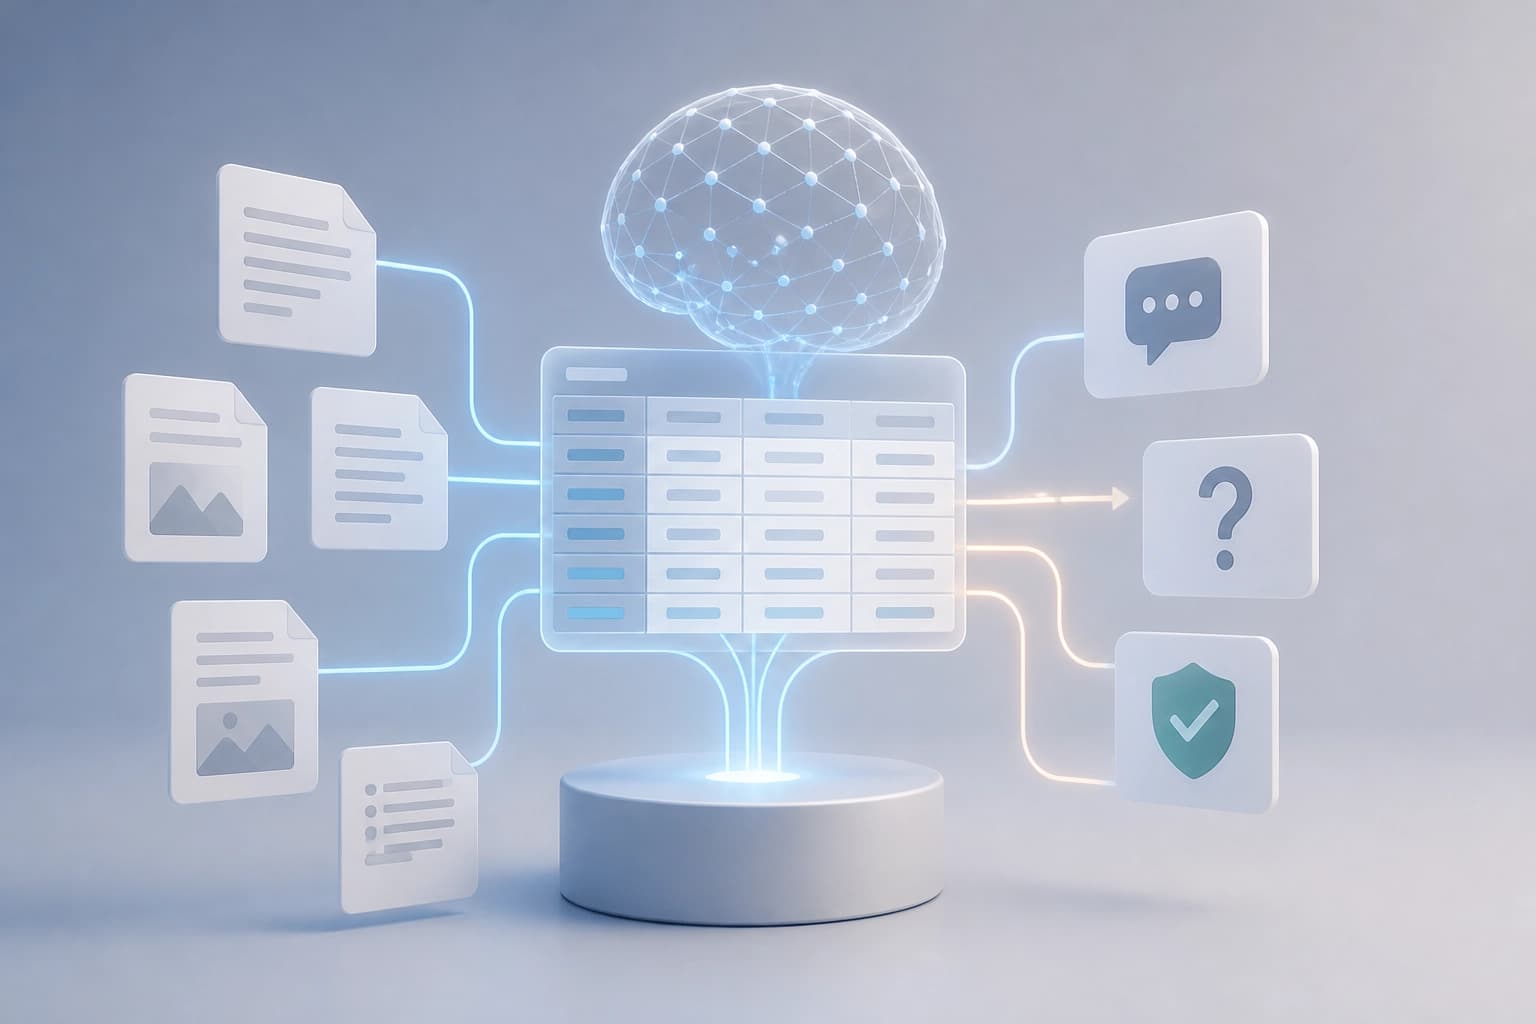
Tâche de détection des hallucinations
Une hallucination est une sortie d’un modèle de langue qui est factuellement incorrecte ou qui n’est pas étayée par la source. L’opacité du raisonnement des LLM rend difficile la détection de ces sorties. On comprend mal pourquoi la sortie du modèle peut être inexacte.
L’article étudie la détection des hallucinations sans supervision. L’approche vérifie la sortie à partir de la source, plutôt qu’en se fondant sur la confiance interne du modèle. Conclusion : la vérification nécessite un point d’ancrage externe — les documents sources.
Une base de données SQL comme représentation des sources
Les auteurs proposent de confier à un modèle de langue la création d’une base de données SQL à partir des documents sources. La base devient une représentation structurée des faits issus des sources. Elle est ensuite utilisée pour raisonner à partir de la source et de la réponse générée.
Conclusion : la représentation SQL fait passer la vérification dans le domaine des requêtes sur les données.
Pipeline neurosymbolique de vérification
Le pipeline de détection des hallucinations repose sur la base de données construite. Il permet une vérification neurosymbolique. Le pipeline combine un modèle de langue et des opérations symboliques sur la base de données SQL. La vérification s’effectue à partir de la source et de la réponse générée.
Conclusion : l’étape de vérification devient explicite et reproductible grâce aux requêtes.
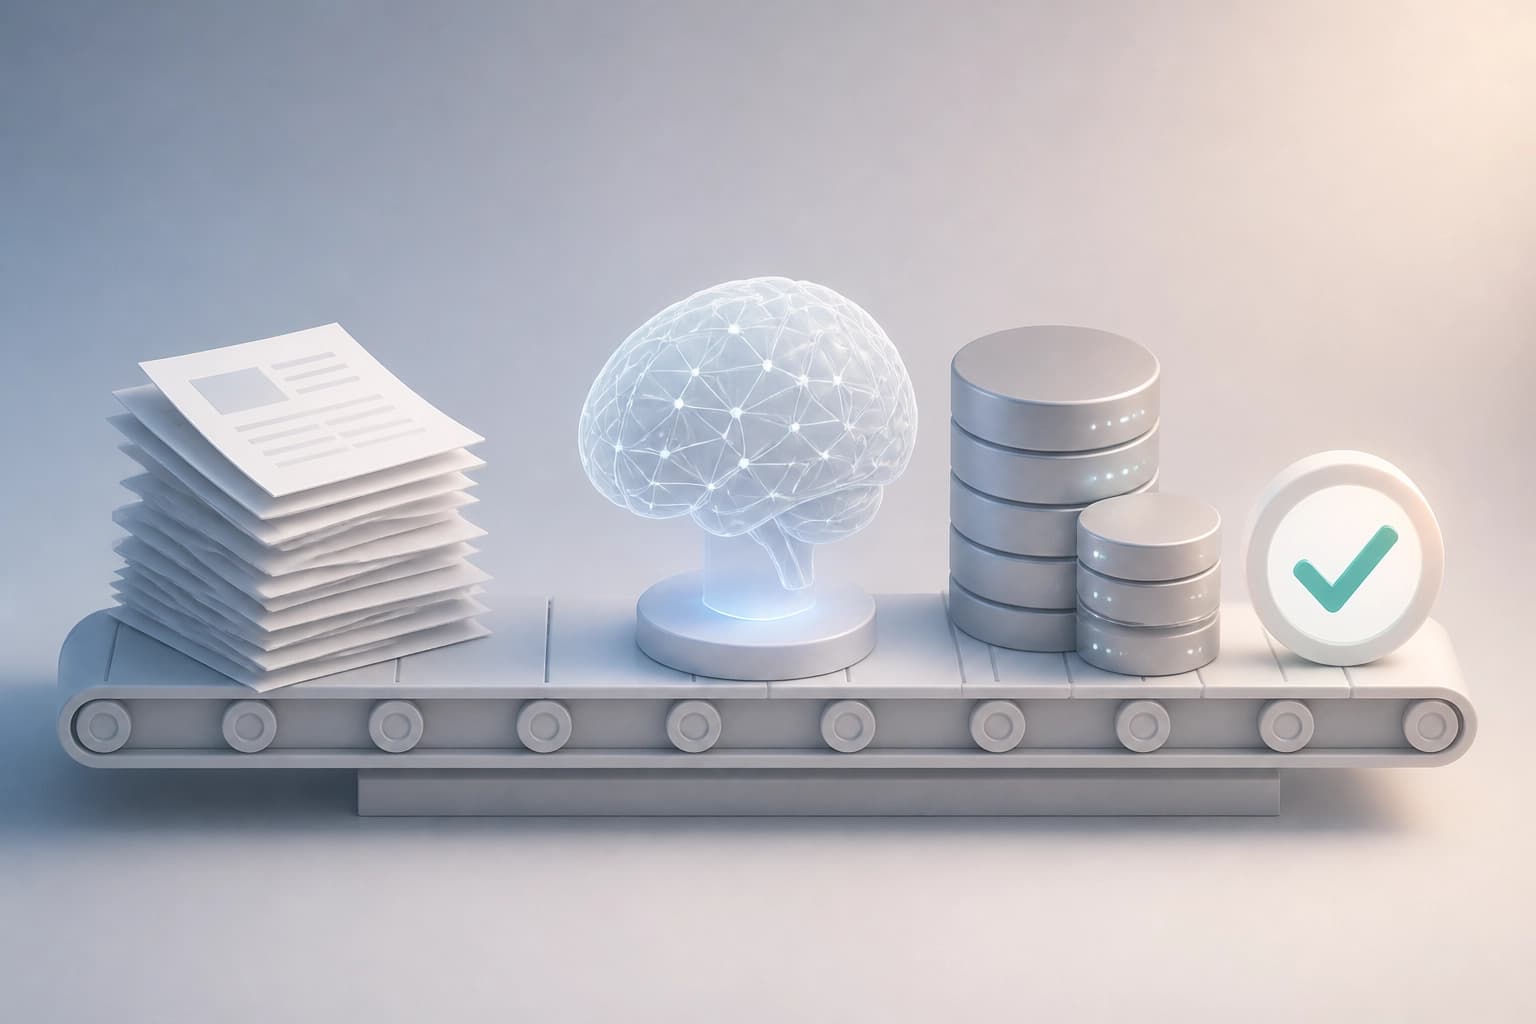
Comparaison avec la prédiction directe
Sur les jeux de données RAGTruth et DiaHalu, l’approche surpasse la prédiction directe. Elle rivalise avec les méthodes de pointe de détection des hallucinations. L’approche ne nécessite pas de réglage fin spécifique au domaine. Elle s’appuie sur les compétences générales de bas niveau déjà présentes chez les LLM.
| Critère | Prédiction directe | Approche par base de données SQL | | Ce qui est utilisé | Le LLM fournit directement une évaluation | Base de données SQL fondée sur les sources et vérification neurosymbolique | | Réglage fin spécifique au domaine | Non indiqué | Non requis | | Résultat sur RAGTruth et DiaHalu | Inférieur à l’approche SQL | Surpasse la prédiction directe et rivalise avec les méthodes de pointe |
Conclusion : l’approche SQL fournit un ancrage vérifiable dans la source. L’article a été accepté au GroundLM EMNLP 2026 Workshop.
Critère de choix pratique
Le critère de choix comprend plusieurs conditions :
- il existe des documents sources ;
- la source permet de construire une base de données SQL ;
- aucun réglage fin spécifique au domaine n’est nécessaire ;
- la vérification s’effectue à partir de la source et de la réponse générée.
L’approche s’appuie sur les compétences symboliques de bas niveau des LLM, par exemple en SQL. Conclusion : l’approche convient lorsque la vérification s’appuie sur la source et qu’aucun réglage fin spécifique au domaine n’est nécessaire.
Foire aux questions
Matériaux connexes
Tous matériaux
MathAdv : ce que cache la précision finale des preuves automatiques
Un ensemble de tâches diagnostiques couvrant 13 domaines des mathématiques universitaires et de troisième cycle évalue les systèmes de démonstration automatique dans Lean 4 non seulement sur le résultat final, mais aussi sur leur maîtrise des sujets, la qualité de leurs raisonnements informels et leur robustesse face aux reformulations des énoncés. L’analyse par composante montre que la formalisation des problèmes reste le principal obstacle et que la réussite dépend fortement du domaine mathématique et de la manière dont le problème est formulé.
9 novembre 2026
AffordanceWAM : les affordances comme intermédiaire entre la prédiction de scène et le contrôle du manipulateur
Ce travail présente un modèle génératif qui prédit simultanément les futures observations RGB, les champs scalaires, les cartes thermiques d’affordances et les commandes continues du robot, en s’appuyant sur des vidéos humaines pour diversifier les interactions sans annotations d’actions ni retargeting. Sur RoboCasa, CALVIN ABC→D et des tâches réelles, cette approche offre des gains constants par rapport aux modèles de référence entraînés uniquement sur des données RGB ou robotiques.
9 novembre 2026
L’édition de présentations sous forme d’opérations contrôlables : le framework EditPPT et le benchmark DeckEdit-Bench
Les auteurs décomposent l’édition de diapositives en objets précis, en actions autorisées et en vérifications visant à s’assurer que le contenu non concerné reste intact, plutôt que de générer librement du code. Pour évaluer la qualité, ils ont créé DeckEdit-Bench (183 tâches sur 28 présentations créées par des humains) ; la méthode multi-agents EditPPT, testée avec cinq modèles de base, réussit 66,7 à 74,9 % des tâches, avec un taux de préservation supérieur à 97 %.
8 novembre 2026