
AffordanceWAM : les affordances comme intermédiaire entre la prédiction de scène et le contrôle du manipulateur
Ce travail présente un modèle génératif qui prédit simultanément les futures observations RGB, les champs scalaires, les cartes thermiques d’affordances et les commandes continues du robot, en s’appuyant sur des vidéos humaines pour diversifier les interactions sans annotations d’actions ni retargeting. Sur RoboCasa, CALVIN ABC→D et des tâches réelles, cette approche offre des gains constants par rapport aux modèles de référence entraînés uniquement sur des données RGB ou robotiques.
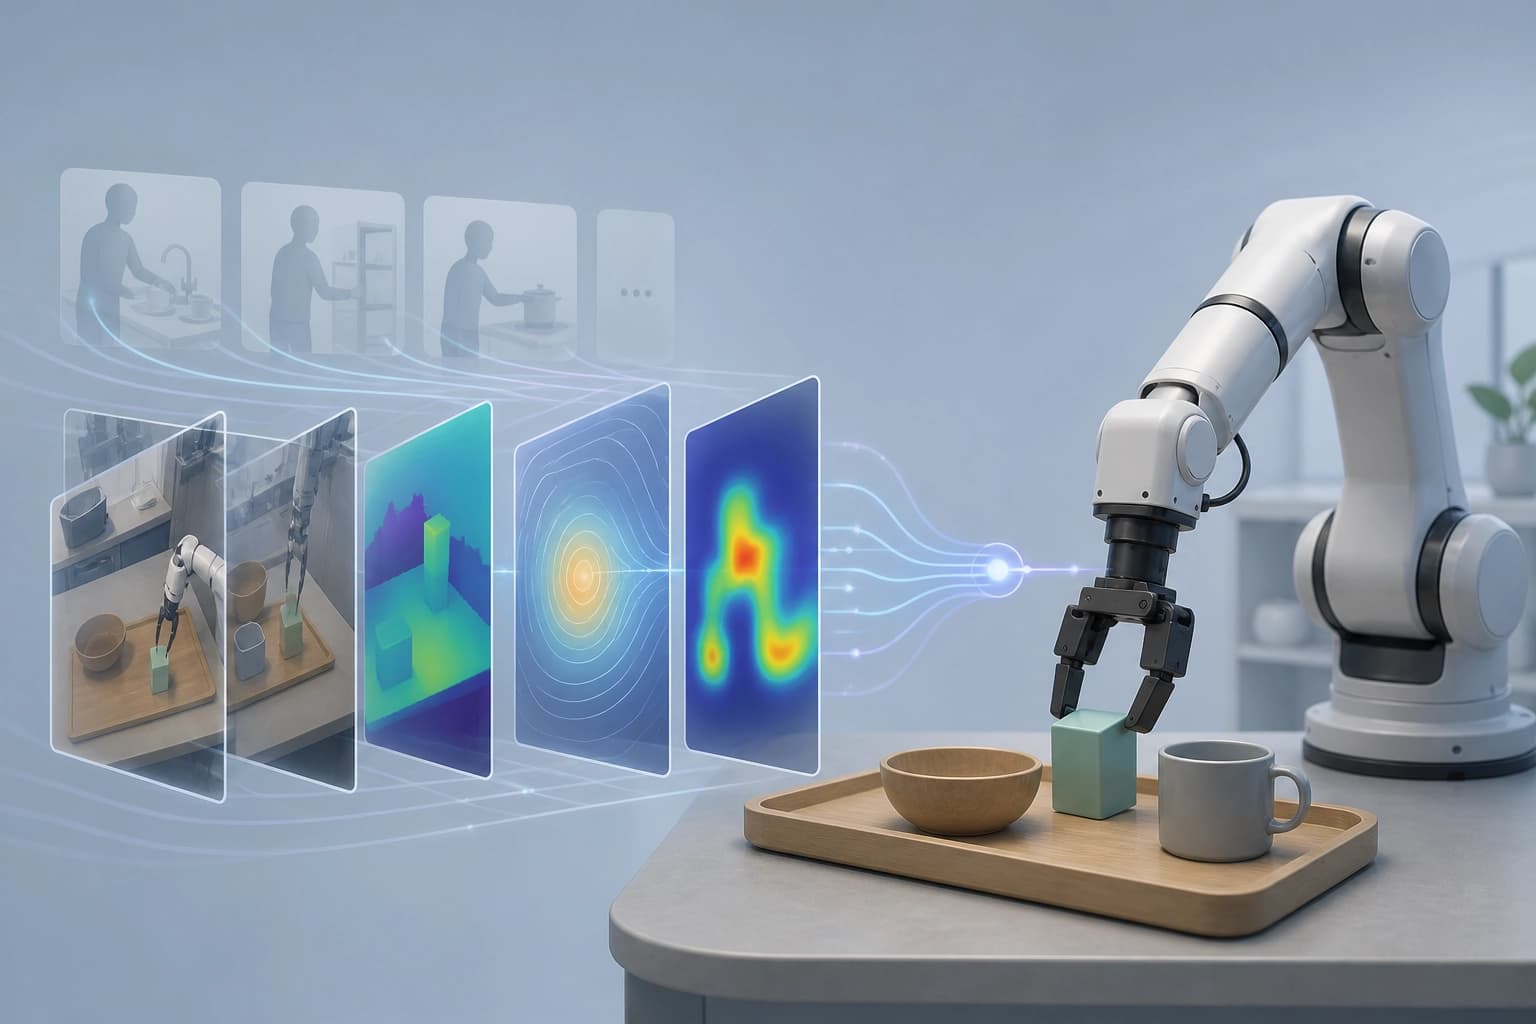
Ce que représente le modèle
L’article arXiv:2609.22332 présente AffordanceWAM, un modèle génératif World Action Model tenant compte des affordances pour la manipulation robotique. La première version a été soumise le 16 septembre 2026. La dernière version indiquée est la v3, révisée le 18 octobre 2026. Le modèle représente des affordances spatio-temporelles centrées sur les objets. Il utilise deux formats :
- Scalar Affordance ;
- Affordance Heatmap.
Ces représentations se trouvent dans le World futur généré. Les affordances relient la prédiction visuelle aux objets pertinents pour la tâche et aux zones d’interaction. Elles servent de fondement commun aux interactions dans les vidéos d’humains et de robots. Les affordances jouent ainsi le rôle d’intermédiaire entre la prédiction de la scène et le contrôle du manipulateur.
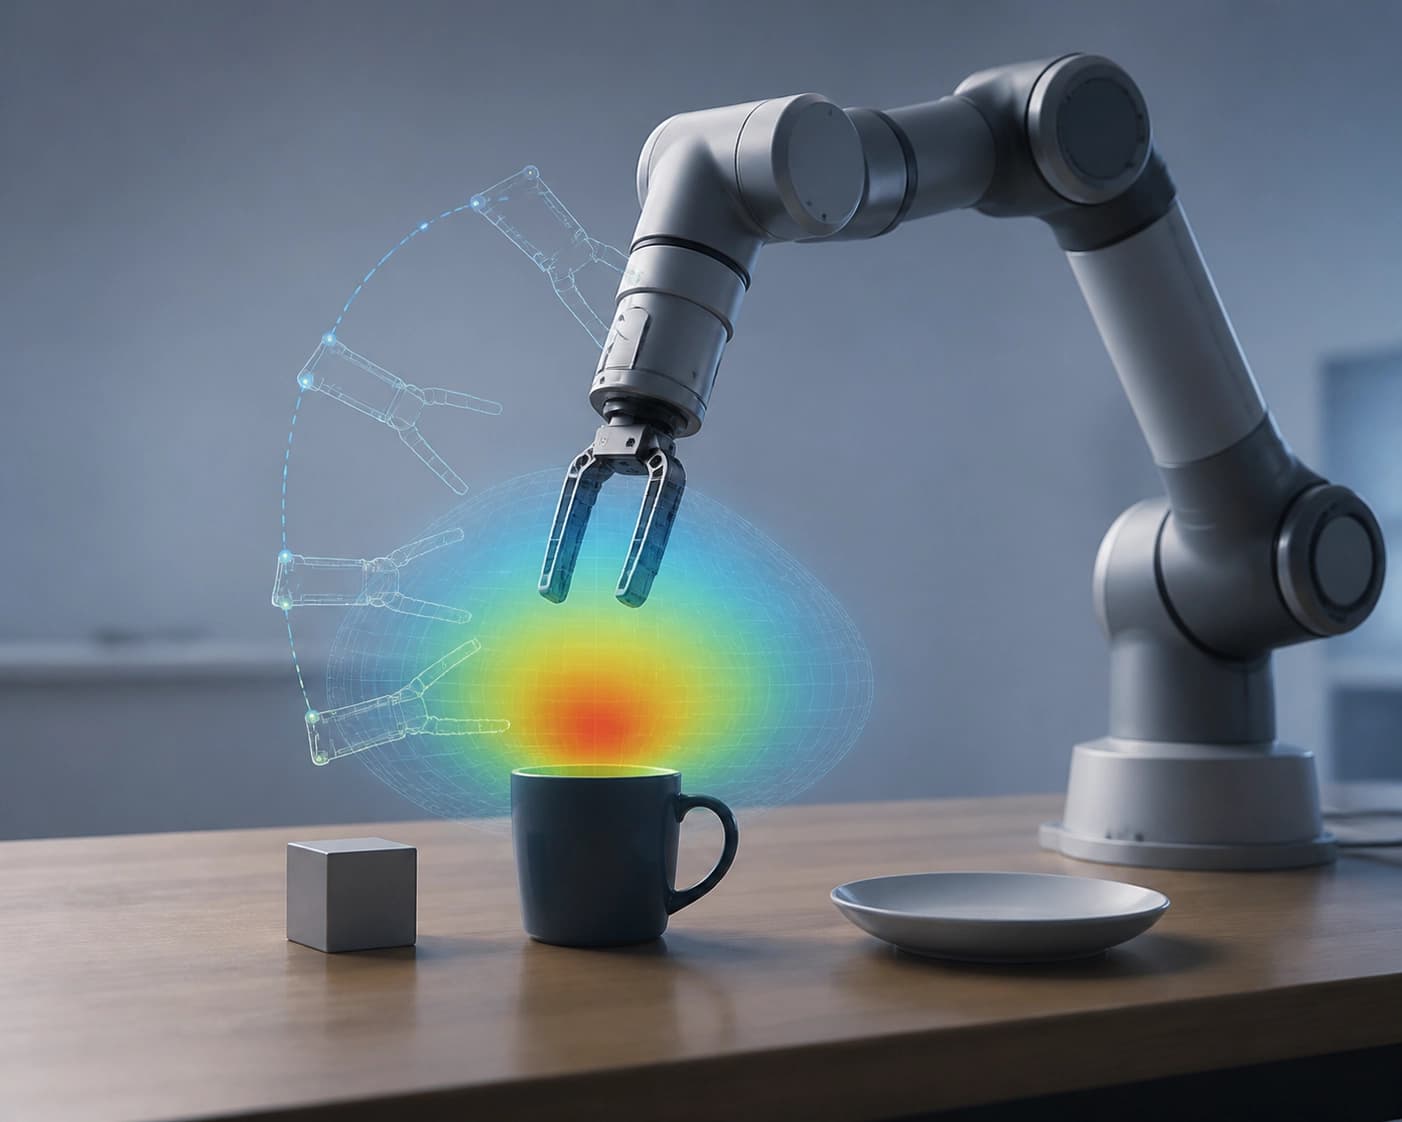
Conclusion : le modèle fournit un format explicite pour les objets et les zones d’action. Ce format relie la prédiction du futur au contrôle.
Architecture : deux experts et un objectif commun
AffordanceWAM repose sur un Transformer de diffusion vidéo préentraîné. Le modèle utilise un World Expert et un Action Expert à paramètres distincts. Ils sont reliés par la Masked Joint Self-Attention.
| Élément | Rôle selon la description de l’article |
|---|---|
| World Expert | expert du monde à paramètres distincts |
| Action Expert | expert des actions à paramètres distincts |
| Masked Joint Self-Attention | relie le World Expert et l’Action Expert |
| Objectif de flow matching commun | réunit la prédiction du RGB, des affordances et des actions |
Le modèle prédit conjointement les futures observations RGB, les champs Scalar Affordance, les Affordance Heatmaps et les actions robotiques continues. Tous ces résultats sont réunis par un objectif de flow matching commun. Les paramètres distincts des experts n’empêchent pas l’entraînement conjoint. Leur lien favorise la prédiction conjointe du monde et de l’action.
Conclusion : l’architecture sépare les paramètres du monde et des actions. Cependant, la Masked Joint Self-Attention et l’objectif commun préservent la prédiction conjointe.
Entraînement sur des vidéos d’humains et des trajectoires de robots
L’entraînement d’AffordanceWAM utilise des vidéos d’humains pour les trois flux du World futur. Les trajectoires de robots fournissent en outre une supervision des actions. Le transfert ne nécessite ni étiquettes d’actions humaines ni réajustement de trajectoire.
| Source de données | Apport à l’entraînement |
|---|---|
| Vidéos d’humains | entraînent les trois flux du World futur |
| Trajectoires de robots | fournissent en outre une supervision des actions |
Les affordances servent de fondement commun aux interactions dans les vidéos d’humains et de robots. Les vidéos d’humains peuvent donc être utilisées sans étiquettes d’actions humaines. Les auteurs présentent l’affordance comme une interface efficace pour le vision-language-action et le transfert de compétences de l’humain au robot.
Conclusion : les affordances fournissent une interface commune aux vidéos d’humains et de robots. Cela évite d’avoir besoin d’étiquettes d’actions humaines et de réajustement de trajectoire.
Expériences : gains et dépendance aux données
Les auteurs ont évalué AffordanceWAM sur RoboCasa, CALVIN ABC→D et dans des tâches de manipulation réelle. Les expériences montrent des gains constants par rapport aux méthodes de référence. Ces méthodes utilisent uniquement le RGB ou uniquement des données de robots.
Sur RoboCasa, les résultats s’améliorent de façon monotone à mesure que le volume de vidéos d’humains annotées avec des affordances augmente. Cela se produit à volume fixe de supervision robotique. Cet effet indique la contribution des affordances à l’entraînement.
| Condition | Résultat selon l’article |
|---|---|
| Référence utilisant uniquement le RGB | gains constants pour AffordanceWAM |
| Référence utilisant uniquement des données de robots | gains constants pour AffordanceWAM |
| Davantage de vidéos d’humains avec affordances à volume fixe de supervision robotique | amélioration monotone sur RoboCasa |
Le critère pratique de choix est le volume de vidéos d’humains annotées avec des affordances. À volume fixe de supervision robotique, l’augmentation de ce volume entraîne une amélioration monotone sur RoboCasa.
Foire aux questions
Matériaux connexes
Tous matériaux
Vérification des hallucinations des LLM via une vue SQL des sources, sans réentraînement
Ce travail évalue si un LLM peut mobiliser une compétence symbolique élémentaire — la création d’une base SQL à partir des documents sources — afin d’ancrer les réponses dans leurs sources sans supervision pour détecter les hallucinations. Sur RAGTruth et DiaHalu, ce pipeline neuro-symbolique se révèle plus précis que la prédiction directe et comparable aux méthodes de pointe, sans nécessiter de réglage fin spécifique au domaine.
9 novembre 2026
MathAdv : ce que cache la précision finale des preuves automatiques
Un ensemble de tâches diagnostiques couvrant 13 domaines des mathématiques universitaires et de troisième cycle évalue les systèmes de démonstration automatique dans Lean 4 non seulement sur le résultat final, mais aussi sur leur maîtrise des sujets, la qualité de leurs raisonnements informels et leur robustesse face aux reformulations des énoncés. L’analyse par composante montre que la formalisation des problèmes reste le principal obstacle et que la réussite dépend fortement du domaine mathématique et de la manière dont le problème est formulé.
9 novembre 2026
L’édition de présentations sous forme d’opérations contrôlables : le framework EditPPT et le benchmark DeckEdit-Bench
Les auteurs décomposent l’édition de diapositives en objets précis, en actions autorisées et en vérifications visant à s’assurer que le contenu non concerné reste intact, plutôt que de générer librement du code. Pour évaluer la qualité, ils ont créé DeckEdit-Bench (183 tâches sur 28 présentations créées par des humains) ; la méthode multi-agents EditPPT, testée avec cinq modèles de base, réussit 66,7 à 74,9 % des tâches, avec un taux de préservation supérieur à 97 %.
8 novembre 2026