
Fusion de modèles par groupes compatibles : GRAM réduit les interférences entre sous-espaces
La méthode GRAM détermine quels modèles affinés il convient de fusionner en analysant la géométrie des angles principaux entre leurs sous-espaces, puis effectue une fusion de faible rang au sein de groupes. Cette approche ne nécessite que les poids, réduit les pertes de projection et affiche de meilleurs résultats dans des expériences linguistiques, visuelles et médicales.
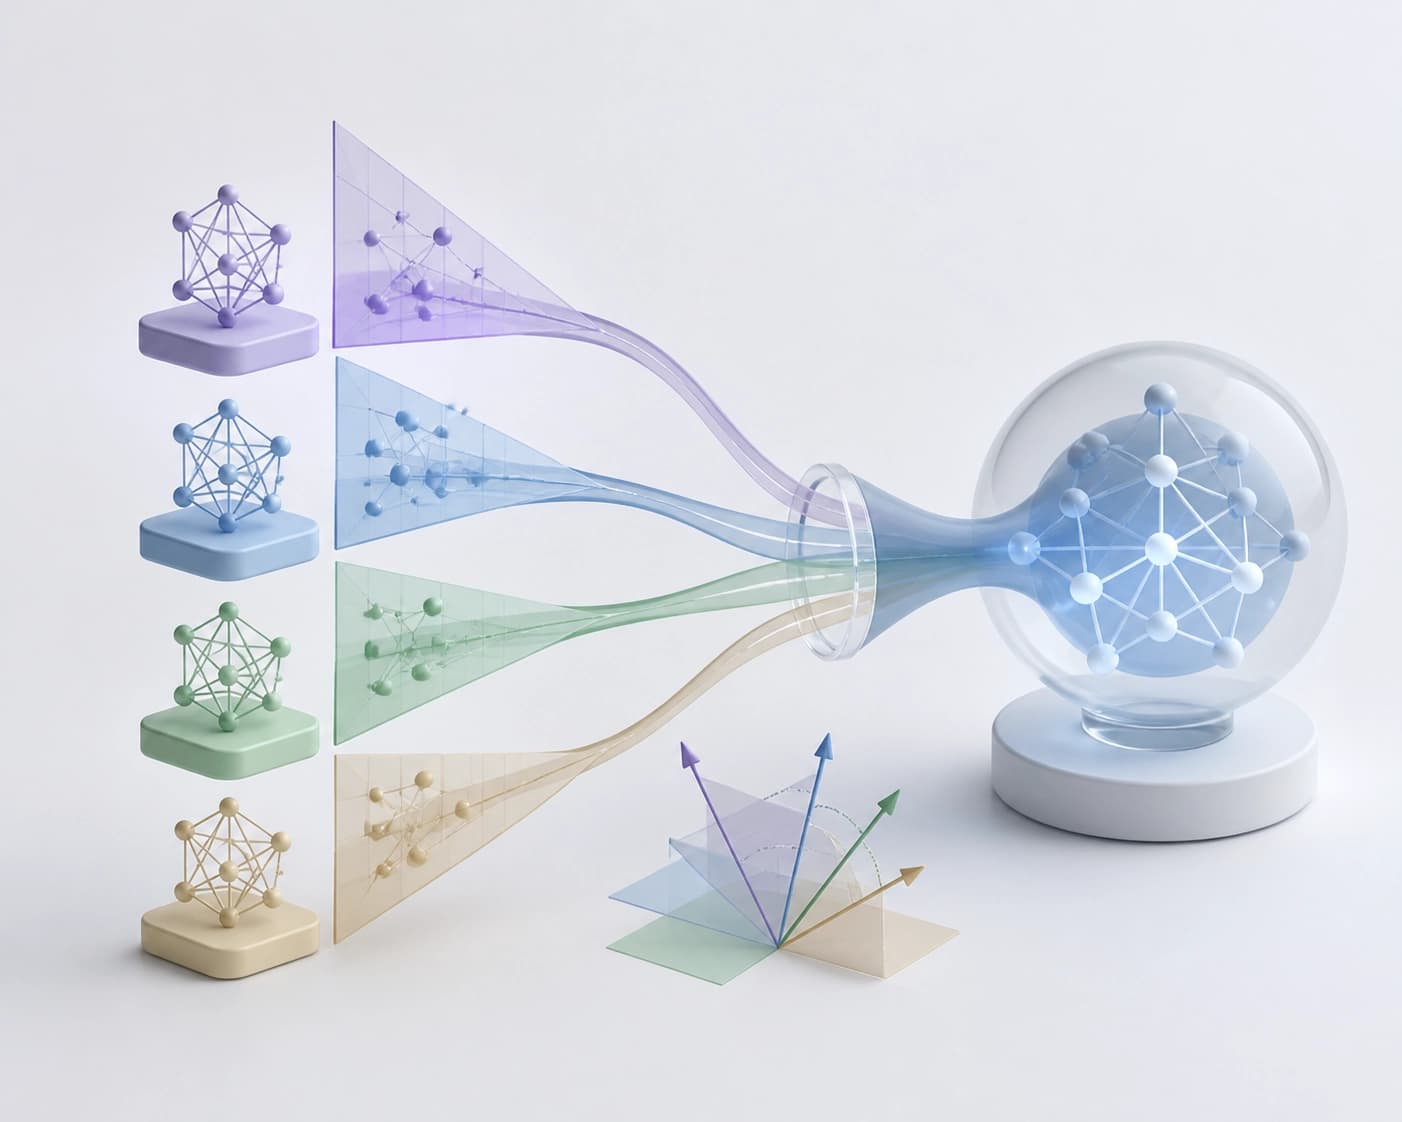
Problème d’interférence entre sous-espaces
La fusion de différents modèles en un seul est nécessaire pour un déploiement multitâche. Dans les domaines réglementés, comme la santé, les données restent souvent sur place. La fusion ne porte donc que sur les poids affinés.
Les méthodes antérieures appliquent la même fusion à toutes les tâches. Elles ne tiennent pas compte des relations géométriques entre les sous-espaces appris. Si les mises à jour des tâches occupent des sous-espaces non alignés, la projection sur une base commune de faible rang écarte des directions importantes. Les auteurs appellent ce phénomène interférence entre sous-espaces.
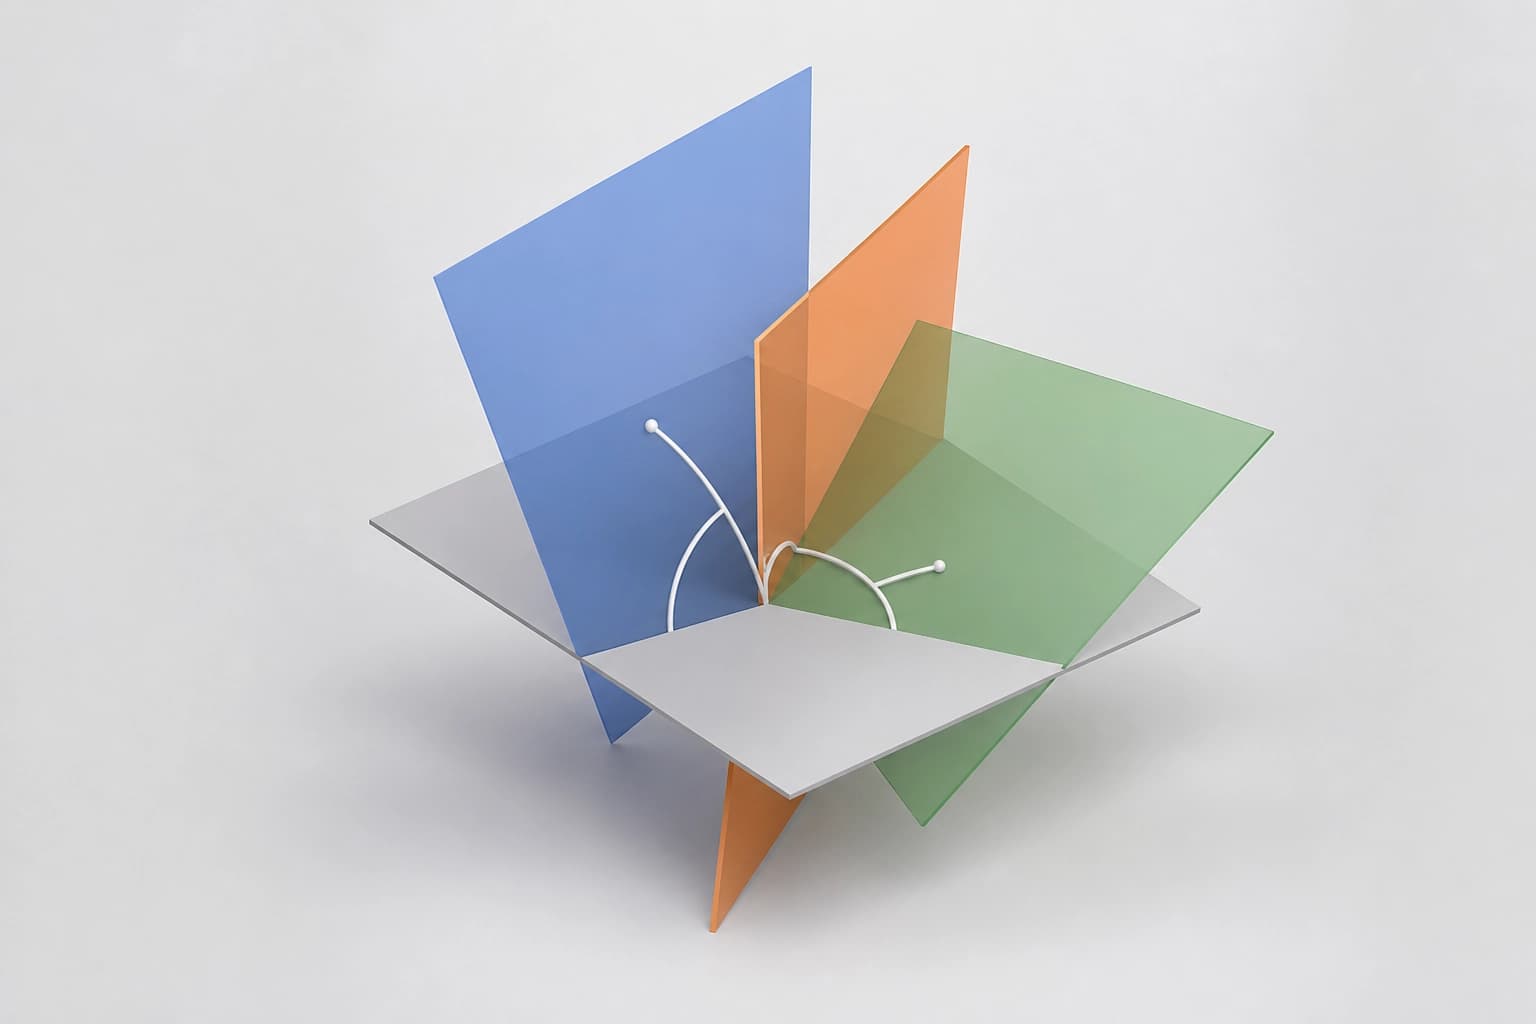
L’erreur de projection pour chaque tâche est déterminée par l’alignement des angles principaux. Celui-ci indique dans quelle mesure le sous-espace d’une tâche correspond au sous-espace commun. Conclusion : une fusion uniforme risque de faire perdre des directions importantes pour certaines tâches.
Mécanisme de GRAM : groupes fondés sur les angles principaux
GRAM (Group-wise Rank-Aware Model Merging) exploite la géométrie des angles principaux entre les vecteurs de tâches. La méthode se déroule en trois étapes :
- Calculer les angles principaux entre les vecteurs de tâches.
- Déterminer, à partir de ces angles, quelles tâches regrouper.
- Effectuer une fusion standard fondée sur la SVD au sein de chaque groupe.
Lors de la fusion, la méthode utilise uniquement les poids affinés. Elle ne nécessite pas d’accès aux données d’origine. Selon les auteurs, le regroupement de tâches géométriquement compatibles réduit de manière démontrable l’erreur de projection au sein de chaque groupe.
Critère pratique : GRAM convient lorsque les données ne peuvent pas être transférées et que les tâches peuvent occuper des sous-espaces non alignés. La méthode permet de répartir les tâches en groupes compatibles avant la fusion.
Ce qui change lorsque K=2
Le scénario dans lequel on ajoute un seul modèle (K=2) met en évidence l’effet de GRAM. Dans ce cas, la méthode réduit considérablement l’interférence entre sous-espaces. Elle surpasse systématiquement les méthodes de fusion antérieures lors des tests.
Les évaluations couvrent trois domaines :
- compréhension du langage — GLUE avec Flan-T5 ;
- vision par ordinateur — CLIP à 8 tâches ;
- ajustement instructionnel médical — Qwen2-7B-Instruct avec quatre LoRA médicaux anglais/chinois.
Conclusion : l’avantage apparaît dès la fusion de deux modèles. Pour le scénario minimal consistant à ajouter un seul modèle affiné, GRAM offre une méthode éprouvée pour réduire l’interférence.
Critères de choix
Le choix entre une fusion uniforme et une approche par groupes dépend des conditions de la tâche. Voici les critères qui ressortent de la description de GRAM.
| Critère | Éléments à prendre en compte |
|---|---|
| Accès aux données | Seuls les poids affinés sont disponibles pour la fusion. |
| Géométrie des tâches | Les tâches peuvent occuper des sous-espaces non alignés. |
| Risque d’interférence | La projection sur une base commune peut écarter des directions importantes. |
| Méthode de fusion | Le regroupement des tâches compatibles réduit l’erreur de projection au sein du groupe. |
| Scénario évalué | K=2 : ajout d’un modèle à un modèle existant. |
Conclusion pratique : si les données restent sur place et que les tâches présentent des géométries de sous-espaces hétérogènes, la fusion par groupes réduit le risque de perte de directions. Une fusion uniforme pour toutes les tâches ne tient pas compte de ce risque.
Foire aux questions
Matériaux connexes
Tous matériaux
Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench
GenXR-Bench est publié : un ensemble de 112 tâches expertes pour évaluer de bout en bout les agents de programmation dans le développement XR interactif, de l’amélioration de fonctionnalités et de la correction de défauts à la création d’applications dont le comportement est testé sur du matériel grand public. Parmi les dix modèles testés, le meilleur résultat a été de 50,9 % en Pass@1 ; les défaillances récurrentes concernent notamment la gestion des événements asynchrones des capteurs, l’ancrage des objets dans l’espace réel et la compréhension des interactions dans un contexte physique.
5 novembre 2026
De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère
Une méthode est proposée pour entraîner un modèle de langage à générer non pas un seul schéma, mais un ensemble de candidats RTL offrant différents compromis entre surface, latence et consommation d’énergie ; la récompense est calculée en fonction de la contribution de chaque variante à l’hypervolume du front de Pareto. Sur RTLLM v2, l’hypervolume relatif a augmenté de 13,3 points de pourcentage par rapport à la version de base sans optimisation PPA et de 14,4 points de pourcentage par rapport à l’apprentissage par renforcement mono-objectif.
5 novembre 2026
Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.
4 novembre 2026