Pourquoi les LLM se trompent en cas d’observations incomplètes
Les auteurs attribuent les erreurs des agents LLM dans les environnements partiellement observables à l’absence d’une distribution explicite des croyances concernant l’état caché. En général, l’agent agit selon une politique conditionnée par l’historique des actions et des observations.
L’article décrit trois erreurs caractéristiques :
- une décision prématurée face à un retour ambigu ;
- un biais en faveur d’une hypothèse erronée après une observation informative ;
- une dérive de la politique à mesure que l’historique s’allonge.
Le problème ne tient pas seulement à la qualité de la réponse à une requête donnée. L’agent ne dispose pas d’une représentation explicite de ce qu’il considère comme un état caché possible.
Comment fonctionne la boucle bayésienne externe
Belief-State Engine (BSE) est un module d’inférence externe au LLM. Il maintient une distribution a posteriori bayésienne sur les états cachés d’un modèle POMDP donné — un processus décisionnel markovien partiellement observable.
À chaque étape, la boucle fonctionne ainsi :
- BSE met à jour la distribution de croyance concernant l’état caché.
- Le LLM reçoit uniquement cette distribution.
- Le journal initial des actions et des observations reste inaccessible au LLM.
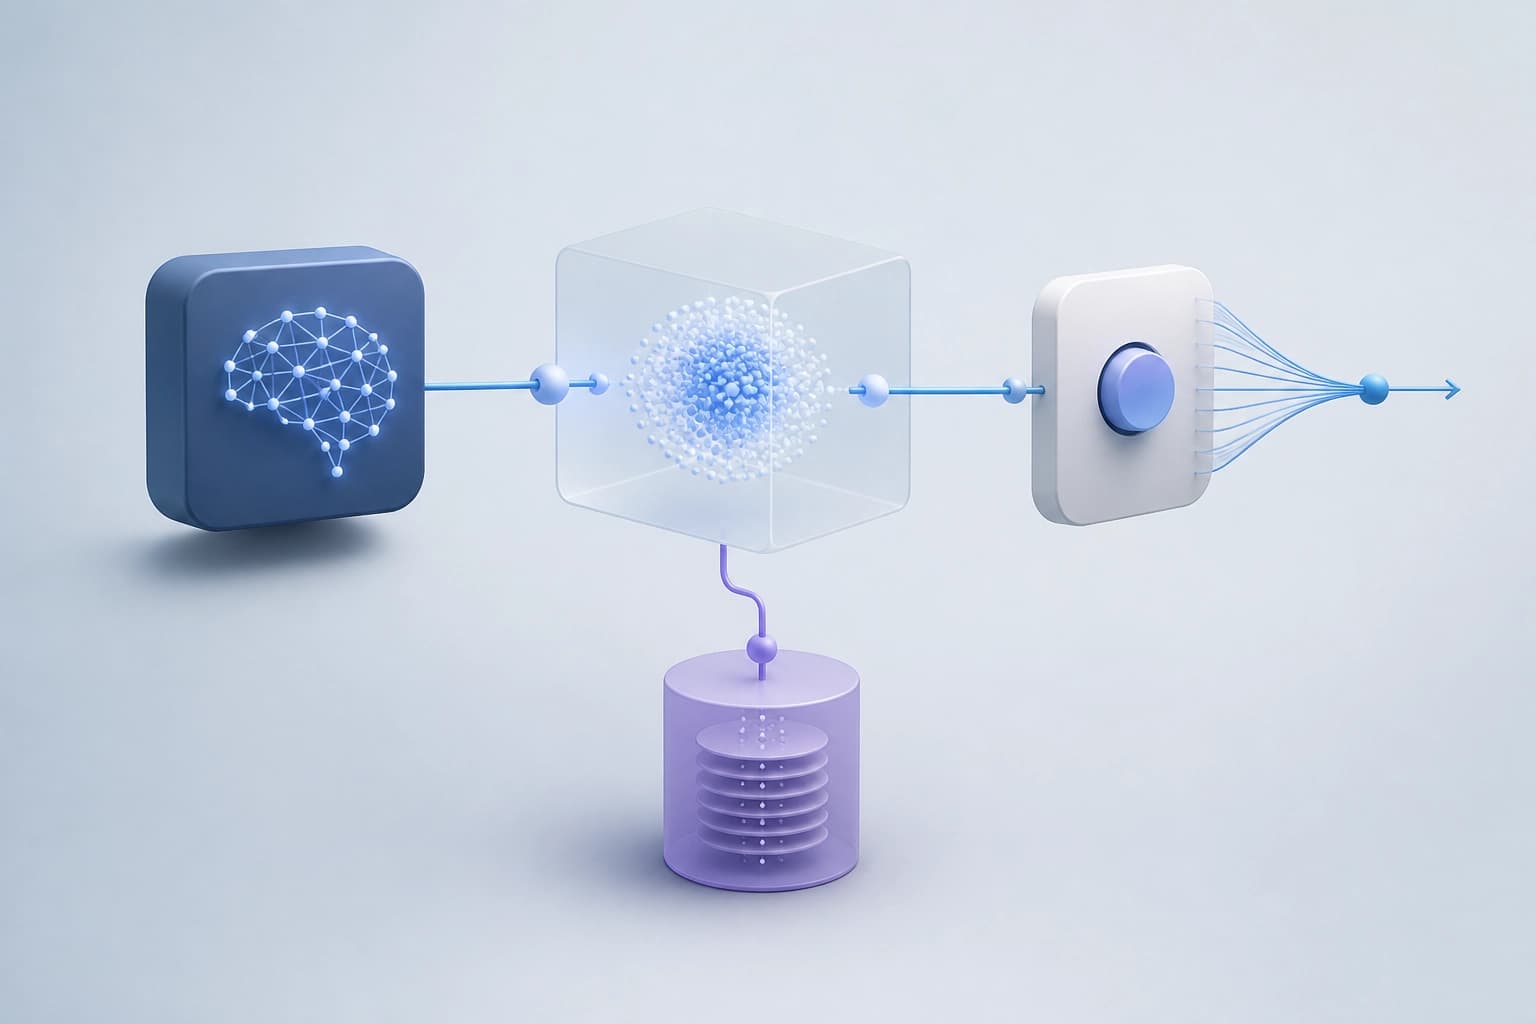
Cette approche dissocie la prise en compte de l’incertitude du modèle de langage. La condition essentielle de cette architecture est que le LLM ne reçoive pas l’historique initial.
Quelles garanties dépendent de l’architecture
Les auteurs définissent une spécification minimale composée de quatre axiomes pour un état interne cohérent avec les croyances. Le contenu des axiomes n’est pas détaillé ici.
Les auteurs démontrent que l’association d’un LLM et de BSE forme une politique markovienne correcte sur le belief MDP induit par le POMDP initial. À condition que le LLM n’ait jamais accès à l’historique initial, cette association hérite des garanties d’optimalité de Bellman issues de la théorie classique des POMDP.
Critère pratique : ces garanties concernent l’association décrite et dépendent de la restriction d’accès à l’historique. Elles ne peuvent être dissociées des conditions de l’architecture.
Ce que l’évaluation a montré
L’architecture a été testée sur le Tiger POMDP et sur une tâche de graphe d’attaque red team. La comparaison portait sur six méthodes de référence.
| Méthode de référence | Résultat de BSE dans les deux domaines |
|---|---|
| Reactive LLM | Retour de tâche plus élevé, meilleur calibrage des croyances et plus grande cohérence des décisions |
| Chain-of-Thought | Retour de tâche plus élevé, meilleur calibrage des croyances et plus grande cohérence des décisions |
| ReAct | Retour de tâche plus élevé, meilleur calibrage des croyances et plus grande cohérence des décisions |
| Natural-language belief tracker | Retour de tâche plus élevé, meilleur calibrage des croyances et plus grande cohérence des décisions |
| QMDP | Retour de tâche plus élevé, meilleur calibrage des croyances et plus grande cohérence des décisions |
| POMCP | Retour de tâche plus élevé, meilleur calibrage des croyances et plus grande cohérence des décisions |
Le résumé indique également que l’effet n’est pas propre à un seul modèle. Dix ablations ciblées visent à isoler la contribution de différents choix architecturaux.
Quand envisager cette approche
BSE prend en charge une distribution sur les états cachés d’un POMDP donné. La description de la tâche dans le cadre d’un tel modèle est donc un critère central pour déterminer si l’approche est applicable.
L’évaluation de l’article porte sur les deux domaines indiqués. Elle ne confirme pas que les résultats sont transposables à toutes les tâches impliquant des données incomplètes.
Ce qui est disponible pour vérification
Le préprint Belief-State Engine: Augmenting LLMs for Principled Planning Under Partial Observability est accompagné du code, des spécifications des environnements, de modèles de prompts et de journaux de seed.
L’article d’Arnab Chattopadhayay et Debdipta Halder a été soumis à arXiv le 9 septembre 2026. Il convient d’évaluer la conclusion pratique en tenant compte des environnements, des comparaisons et des conditions d’accès du LLM à l’historique décrits.