Problème : on évalue le modèle là où il n'est plus nécessaire de chercher
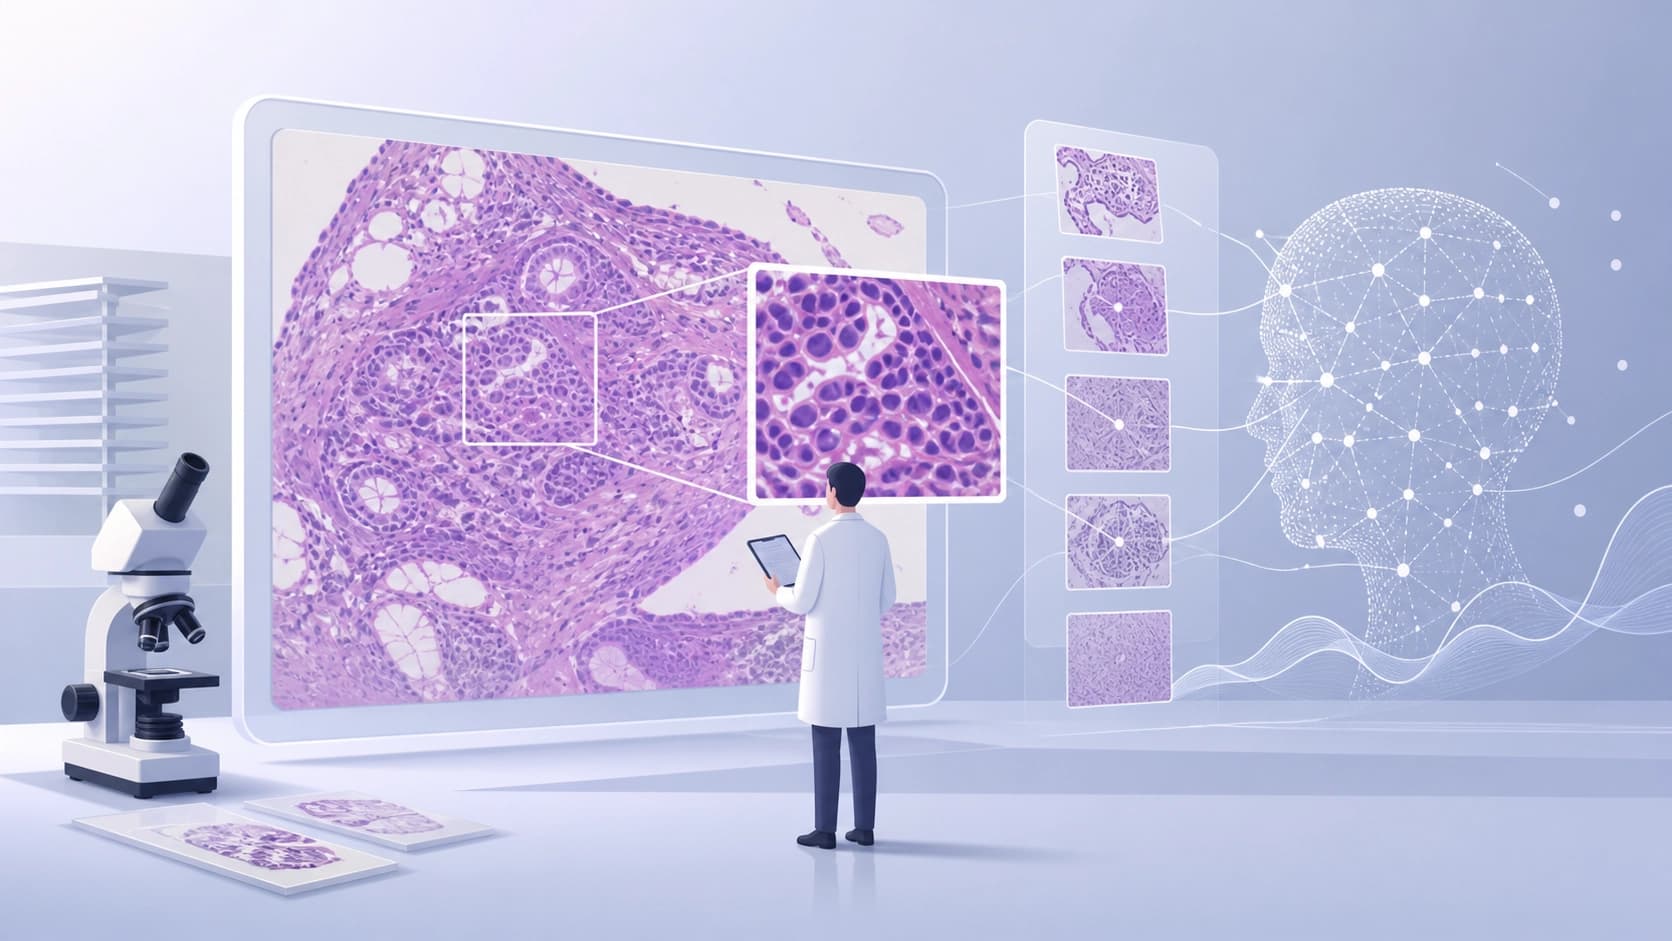
Une lame histologique est une image gigapixel. Pour poser un diagnostic, le pathologiste commence par examiner la préparation à faible grossissement, repère les zones suspectes, puis les observe de près, compare l'image à différentes échelles et ne formule qu'ensuite sa conclusion. Une part substantielle de ce travail ne consiste pas à observer, mais à chercher : où faut-il regarder, au fond.
La plupart des benchmarks existants pour l'IA en pathologie privent le modèle de cette part du travail. En entrée, on fournit soit un patch découpé à l'avance, soit des caractéristiques déjà extraites de la lame — autrement dit, quelqu'un d'autre a décidé à l'avance ce qui est important ici. Le modèle reçoit des preuves toutes prêtes et démontre sa capacité à raisonner à partir de celles-ci. Mais sa capacité à obtenir ces preuves de manière autonome reste presque entièrement non testée.
C'est précisément cette lacune que cible le travail EviPathBench. Ses auteurs — Dankai Liao, Tianyi Zhang, Yufeng Wu, Xinyue Zhang, Qiaochu Xue, Zeyu Liu, Dachun Zhao, Linghan Cai et Yueming Jin ; le preprint est apparu sur arXiv le 21 juillet 2026, et au 25 août il en était déjà à sa quatrième version (arXiv:2607.19261, cs.CV / cs.AI). Cette fréquence de révisions suggère en soi que les auteurs considèrent le sujet comme vivant et sujet à débat.
Comment le benchmark est conçu
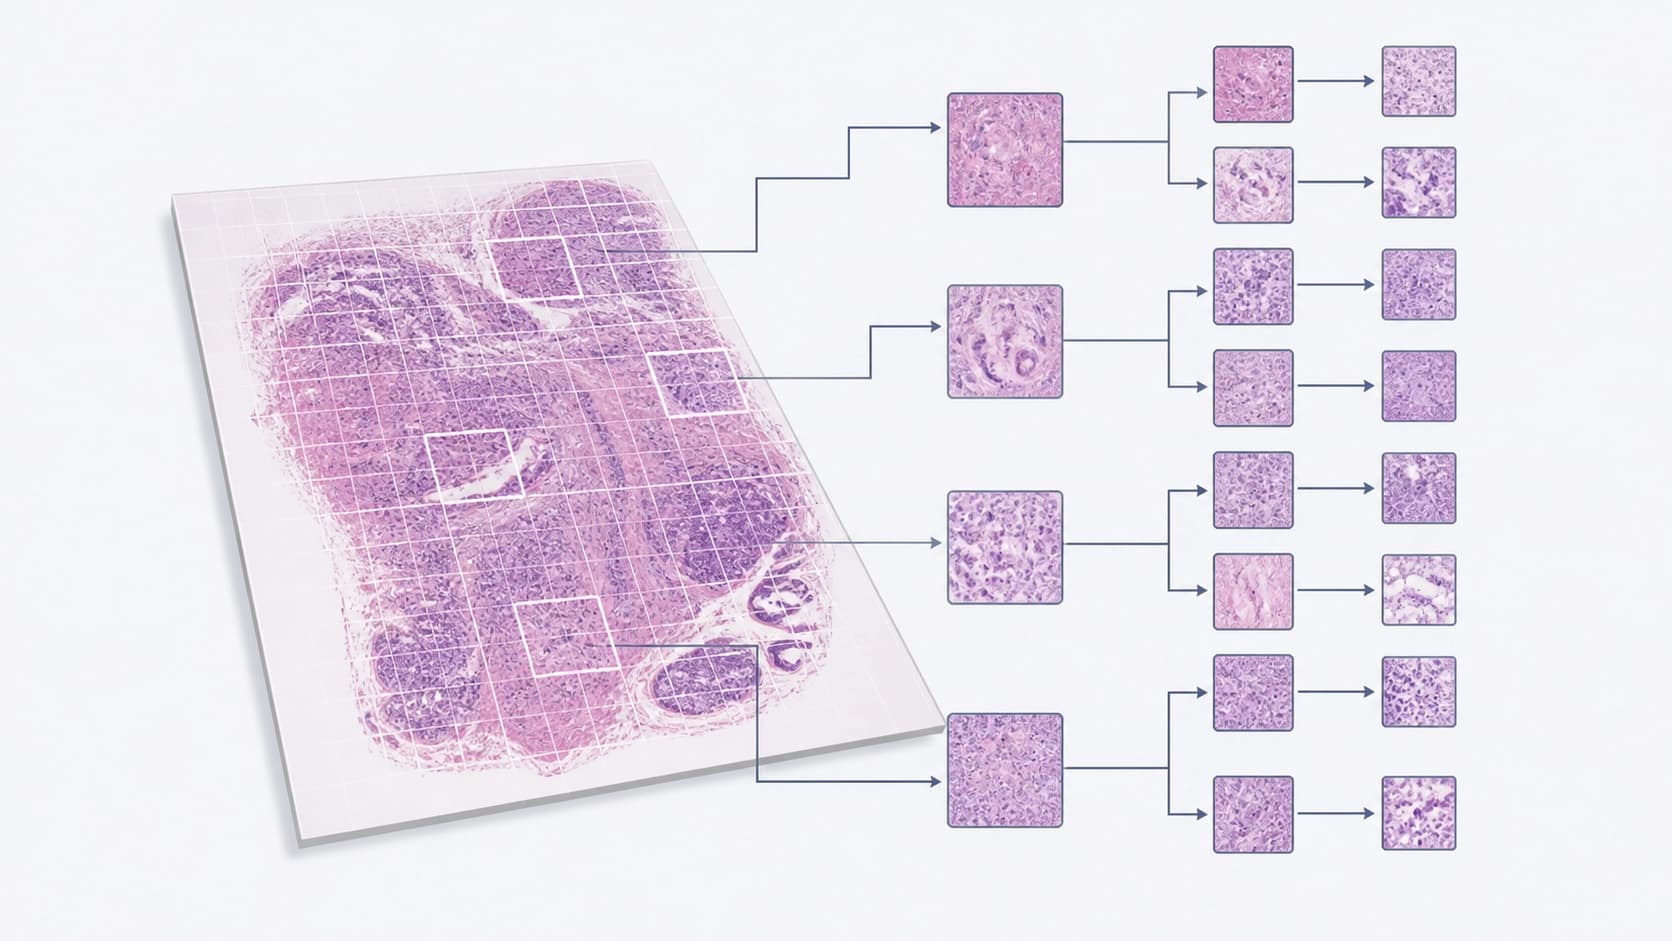
EviPathBench n'est pas conçu comme un ensemble de questions isolées à choix multiples, mais comme un arbre diagnostique. Les régions imbriquées les unes dans les autres à différents grossissements sont liées à des observations spécifiques à une échelle donnée, et finalement — à un diagnostic de niveau conclusion pathologique. On ne demande pas au modèle de simplement produire l'étiquette « cancer », mais de parcourir une chaîne : trouver une région, décrire l'observation à ce grossissement, remonter d'un niveau, mettre en cohérence les données entre les échelles et les synthétiser en une conclusion globale.
Quatre capacités évaluées
Les auteurs ont décomposé la compétence de travail sur lame en éléments constitutifs et évaluent chacun séparément :
- Appariement image-texte — interprétation de la preuve, lorsque le modèle relie ce qu'il voit à une description.
- Requête textuelle vers l'image (retrieval) — vérification : à partir d'une formulation, il faut retrouver le fragment correspondant dans la lame.
- Localisation de la région diagnostique — à proprement parler la collecte de preuves : où chercher exactement.
- Raisonnement multi-échelles — intégration des observations obtenues à différents grossissements en une image unique.
Cette division est précieuse en soi : elle montre que « comprendre une lame » n'est pas une seule capacité mais plusieurs, et qu'elles peuvent diverger très fortement entre elles.
Données et annotation
La base est constituée de 1 822 WSI issues de TCGA et de 17 135 parcours diagnostiques, annotés par dix pathologistes certifiés. Une cohorte privée de 190 lames de cancer du sein avec annotations détaillées est utilisée séparément — elle sert à tester précisément l'exploration autonome d'une préparation entière, sans indices sur l'emplacement de la zone d'intérêt.
Résultats : raisonner, ça marche ; chercher, non
L'évaluation a porté sur 19 modèles « vision-langage » — généraux, médicaux et spécialisés en pathologie — plus un modèle textuel de référence, nécessaire comme point de comparaison.
Le tableau obtenu est contrasté. Les meilleurs modèles ouverts dépassent 93 % de précision en raisonnement multi-échelles et plus de 50 % dans les deux tâches d'appariement cross-modal. On pourrait croire que tout va bien.
Mais pour ce qui est de la localisation de la région diagnostique — c'est le désastre. Le meilleur résultat en text-guided mean IoU n'atteint même pas 0,09. C'est moins bon qu'une simple heuristique qui place un rectangle au centre de la lame, sans rien analyser du tout. Autrement dit, un modèle entraîné à regarder le tissu cherche moins bien qu'un programme qui ne regarde nulle part.
L'échelle casse la recherche
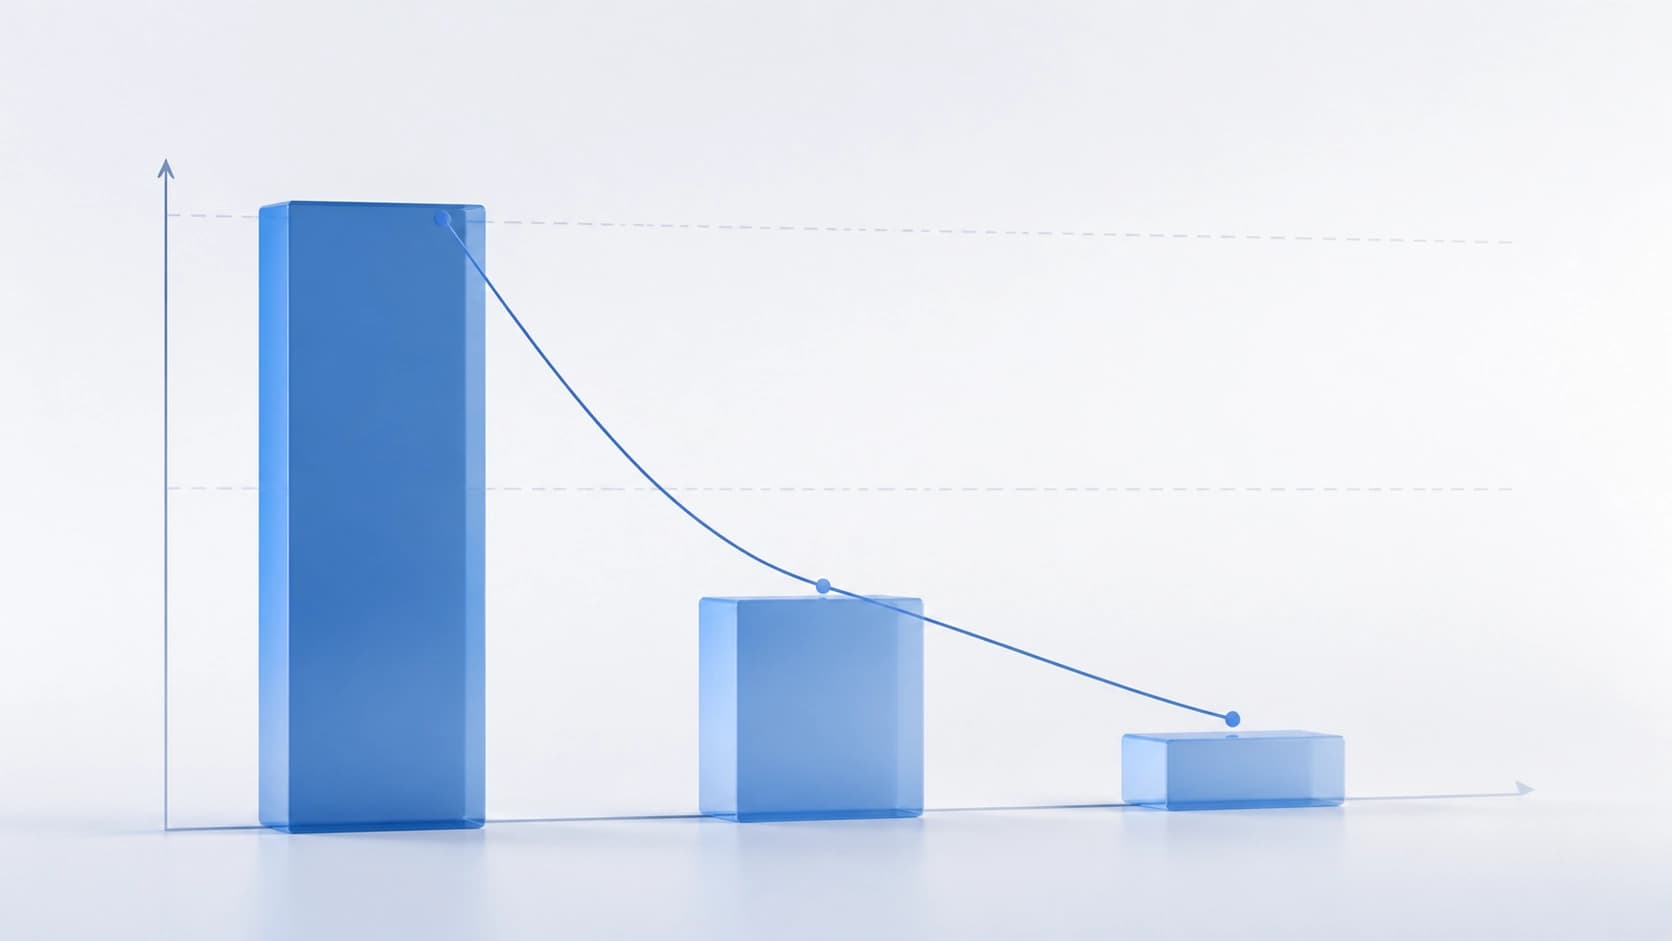
Une ligne d'expérimentation distincte porte sur l'exploration autonome de la lame. Ici, le hit rate absolu s'effondre à mesure que le grossissement augmente : 0,522 à faible grossissement, 0,185 à moyen et 0,020 à fort. La logique de cette chute est claire : à faible grossissement, le modèle voit l'architecture générale du tissu et tombe facilement « quelque part dans la bonne zone », mais plus le zoom est fort, plus le champ de vision est étroit et plus chaque erreur à l'étape précédente coûte cher. Les ratés s'accumulent, et au grossissement maximal, le modèle regarde presque à coup sûr au mauvais endroit.
Ce qu'il faut en retenir
La conclusion principale du travail se formule simplement : il existe un fossé profond entre la capacité à raisonner sur des preuves préparées et la capacité à obtenir ces preuves. La première est déjà plutôt bien maîtrisée par les modèles actuels, la seconde — presque pas du tout.
En pratique, cela signifie que la navigation sur lame ne peut pas encore être laissée au modèle « en toute autonomie » en attendant un résultat cliniquement pertinent. En revanche, le benchmark lui-même fournit un cadre général : il permet de mesurer les deux capacités et de voir si une amélioration donnée — apprentissage par renforcement, mémoire entre les étapes de zoom, recherche hiérarchique — permet de progresser dans la partie qui échoue.
Il faut aussi garder en tête quelques réserves. La cohorte privée se limite au cancer du sein, et l'essentiel des données provient de matériel rétrospectif de TCGA, ce qui signifie que la variabilité clinique réelle n'y est pas pleinement représentée. Les métriques de localisation sont sensibles à la manière exacte dont les limites des régions ont été annotées, et les quatre versions du preprint en un mois indiquent que les chiffres peuvent encore être affinés.