
Méthode CHOIR : l’énumération libre révèle les positions divergentes des modèles au sein des systèmes collectifs
Les auteurs proposent CHOIR, une approche dans laquelle des ensembles sollicitent à plusieurs reprises des listes de réponses classées, puis comparent la saillance des concepts regroupés entre les modèles, les formulations de prompts et les conditions liées aux rôles. L’étude montre qu’une forte similarité apparente entre les réponses ouvertes ne signifie pas pour autant un consensus : l’identité du modèle sous-jacent reste le facteur de distinction le plus constant, tandis que les consignes de persona modifient les concepts exprimés.
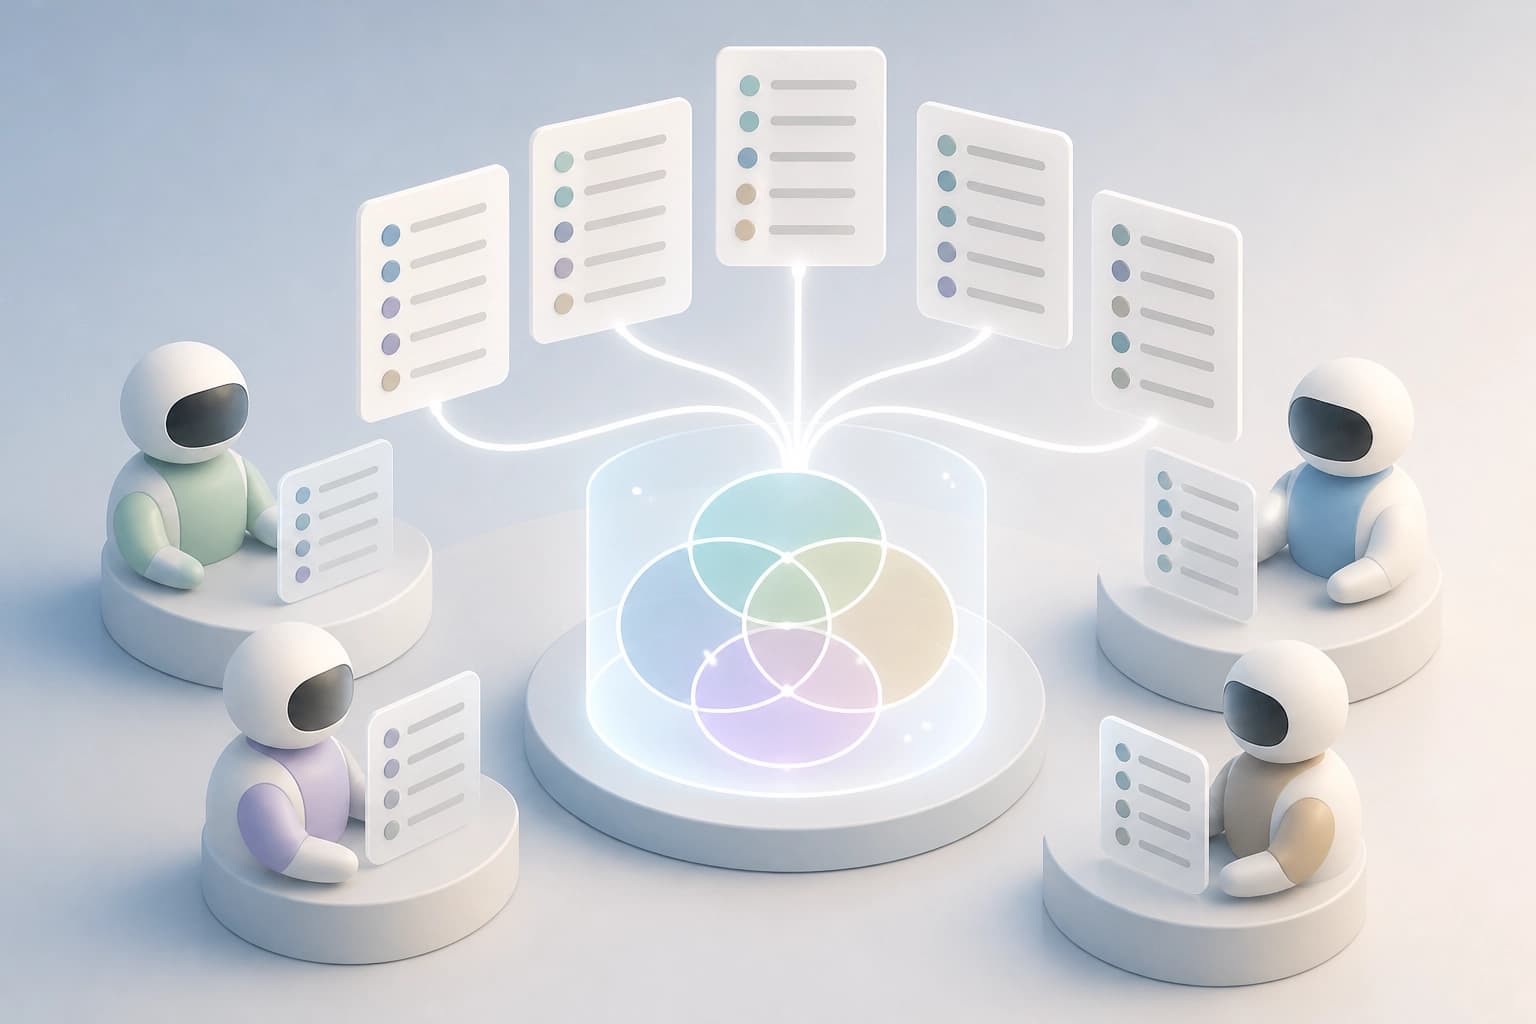
Ce que CHOIR apporte
CHOIR signifie Collective Hierarchically-Ordered Inquiry Responses. Cette approche adapte l’élicitation par liste libre aux ensembles de LLM. Son objectif est de mettre au jour les positions sur lesquelles les modèles d’un ensemble divergent. La concordance apparente des réponses masque ces divergences.
La méthode s’appuie sur des énumérations, et non sur des formulations toutes faites. Des requêtes répétées fournissent des éléments sur les thèmes que les modèles soulèvent spontanément. Ces éléments sont ensuite ramenés à une forme comparable.
Critère pratique : utiliser CHOIR lorsque les réponses de l’ensemble semblent identiques, mais qu’il faut comprendre précisément où les modèles divergent.
Étapes de la méthode
La méthode repose sur trois étapes.
- Requêtes répétées de listes classées auprès des modèles de l’ensemble.
- Regroupement des éléments des listes en concepts au niveau du prompt.
- Mesure de la saillance des concepts entre les modèles, les variantes de prompts et les conditions avec personas.
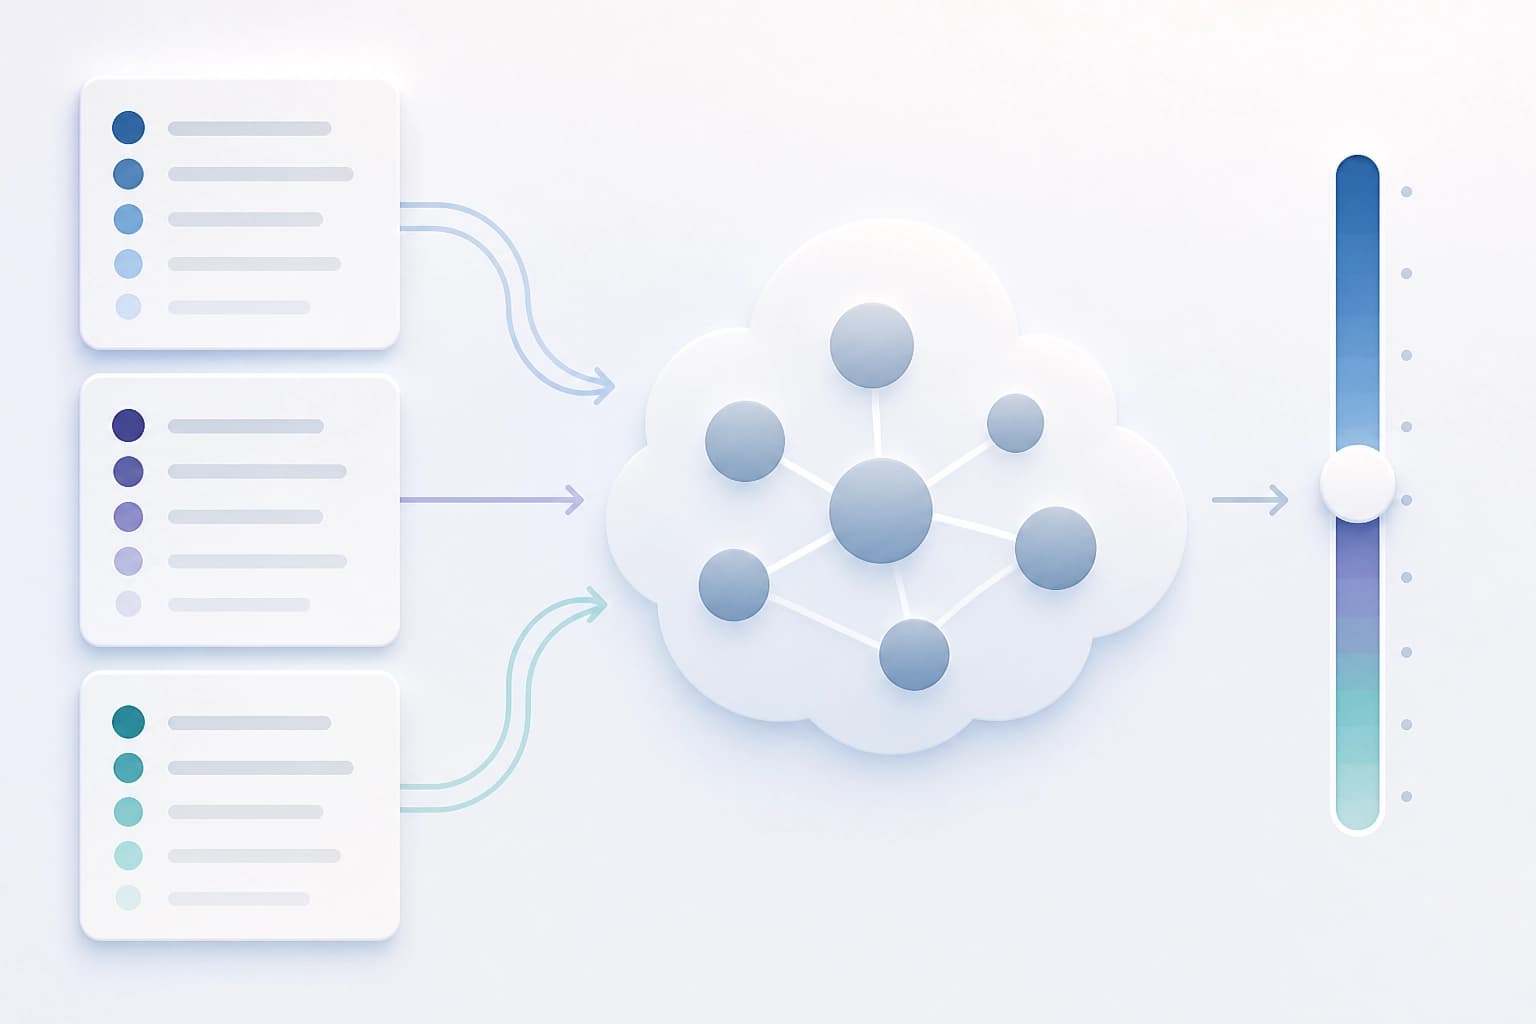
Chaque étape ajoute une dimension. Les listes fournissent la matière brute, le regroupement la rend comparable, et la mesure de la saillance révèle les différences. Sans ramener les éléments à des concepts, la comparaison reste au niveau des mots isolés.
Critère pratique : évaluer la méthode en vérifiant si elle préserve les différences après le regroupement des éléments en concepts.
Sur quels jeux de données la méthode a été testée
| Jeu de données | Description | Résultat |
|---|---|---|
| Infinity-Chat 100 | Jeu de prompts externe issu d’une étude récente sur l’homogénéité des réponses ouvertes des modèles | Reproduit un niveau élevé de concordance apparente : 93/100 prompts dépassent le niveau du hasard. Distingue les prompts étroits des prompts larges, dont il révèle la profondeur cachée des réponses |
| Jeu de données diagnostique ciblé | 27 questions conçues pour révéler des différences au niveau des mécanismes | Sert à effectuer des tests ciblés sur les divergences entre les modèles |
Les jeux de données répondent à des objectifs différents. Le jeu externe donne une vue d’ensemble de la concordance tout en distinguant les prompts larges des prompts étroits. Le jeu ciblé est conçu pour mettre en évidence les différences au niveau des mécanismes.
Critère de choix : utiliser le jeu de prompts externe pour obtenir une vue d’ensemble de la concordance, et le jeu diagnostique pour analyser les mécanismes.
Quels signes de divergence sont visibles
Les observations se répartissent en trois groupes.
- L’identité du modèle de base reste le signe le plus fort qu’il est possible de retrouver. C’est vrai aussi bien pour les tests ciblés que pour le jeu de prompts externe.
- Les prompts avec personas modifient les concepts qui se manifestent dans les signatures des modèles de base.
- Un module de classement ignorant la source met en évidence des candidats rares, mais stables, à étudier par la suite.
Les personas modifient la manifestation des concepts, mais n’effacent pas le signal du modèle de base. Le classement sans connaissance de la source sert de filtre pour l’analyse ultérieure.
Critère pratique : commencer par identifier le modèle de base, puis évaluer le déplacement induit par le persona.
Un cadre diagnostique plutôt qu’un constat de concordance
Les auteurs proposent de considérer l’homogénéité des réponses ouvertes comme un problème de diagnostic. La question se pose alors autrement : où les modèles convergent-ils, pourquoi convergent-ils et que peut-on encore détecter ?
- Où ils convergent — carte des concepts communs aux modèles.
- Pourquoi ils convergent — causes sous-jacentes à la concordance apparente.
- Ce qui reste visible — candidats mis en évidence par le classement sans connaissance de la source.
L’article a été publié dans les Proceedings of the Third Conference on Language Modeling (COLM 2026), en 2026. Il a été soumis à arXiv le 29 septembre 2026. Les auteurs sont Ben Wigler et Maria Tsfasman.
Critère : l’homogénéité des réponses n’est pas une conclusion finale, mais le point de départ d’un diagnostic approfondi.
Foire aux questions
Matériaux connexes
Tous matériaux
Évaluation des agents de programmation pour le développement XR interactif : résultats de GenXR-Bench
GenXR-Bench est publié : un ensemble de 112 tâches expertes pour évaluer de bout en bout les agents de programmation dans le développement XR interactif, de l’amélioration de fonctionnalités et de la correction de défauts à la création d’applications dont le comportement est testé sur du matériel grand public. Parmi les dix modèles testés, le meilleur résultat a été de 50,9 % en Pass@1 ; les défaillances récurrentes concernent notamment la gestion des événements asynchrones des capteurs, l’ancrage des objets dans l’espace réel et la compréhension des interactions dans un contexte physique.
5 novembre 2026
De la récompense scalaire au front de Pareto : synthèse RTL par LLM avec apprentissage par renforcement multicritère
Une méthode est proposée pour entraîner un modèle de langage à générer non pas un seul schéma, mais un ensemble de candidats RTL offrant différents compromis entre surface, latence et consommation d’énergie ; la récompense est calculée en fonction de la contribution de chaque variante à l’hypervolume du front de Pareto. Sur RTLLM v2, l’hypervolume relatif a augmenté de 13,3 points de pourcentage par rapport à la version de base sans optimisation PPA et de 14,4 points de pourcentage par rapport à l’apprentissage par renforcement mono-objectif.
5 novembre 2026
Les LLM médicales sont informés des révisions des recommandations, mais répondent souvent selon les anciennes règles
L’étude de ChronoEvo portant sur 1 709 changements dans les recommandations cliniques montre que, dans le modèle principal, 90,8 % des réponses repéraient la nouveauté, mais que seules 58,5 % l’appliquaient intégralement, avec un écart de 32,3 points de pourcentage observé dans 14 modèles. Même en renforçant la visibilité des mises à jour, le transfert intégral des nouvelles règles dans les recommandations cliniques n’a pas connu de hausse significative.
4 novembre 2026