
CaLR : optimisation latente sous contraintes causales pour une inférence robuste des modèles de diffusion
L’étude présente CaLR, une approche qui ramène le raisonnement à une optimisation sous contraintes dans l’espace latent ; la structure provient d’une matrice de topologie causale issue d’un modèle expert, et l’entraînement s’appuie sur la différentiation implicite. La méthode améliore la cohérence et permet de corriger les résultats intermédiaires au cours de la génération parallèle, ce qui se traduit par de meilleures performances sur des jeux de données complexes et dans des tâches soumises à des contraintes strictes, notamment le sudoku.
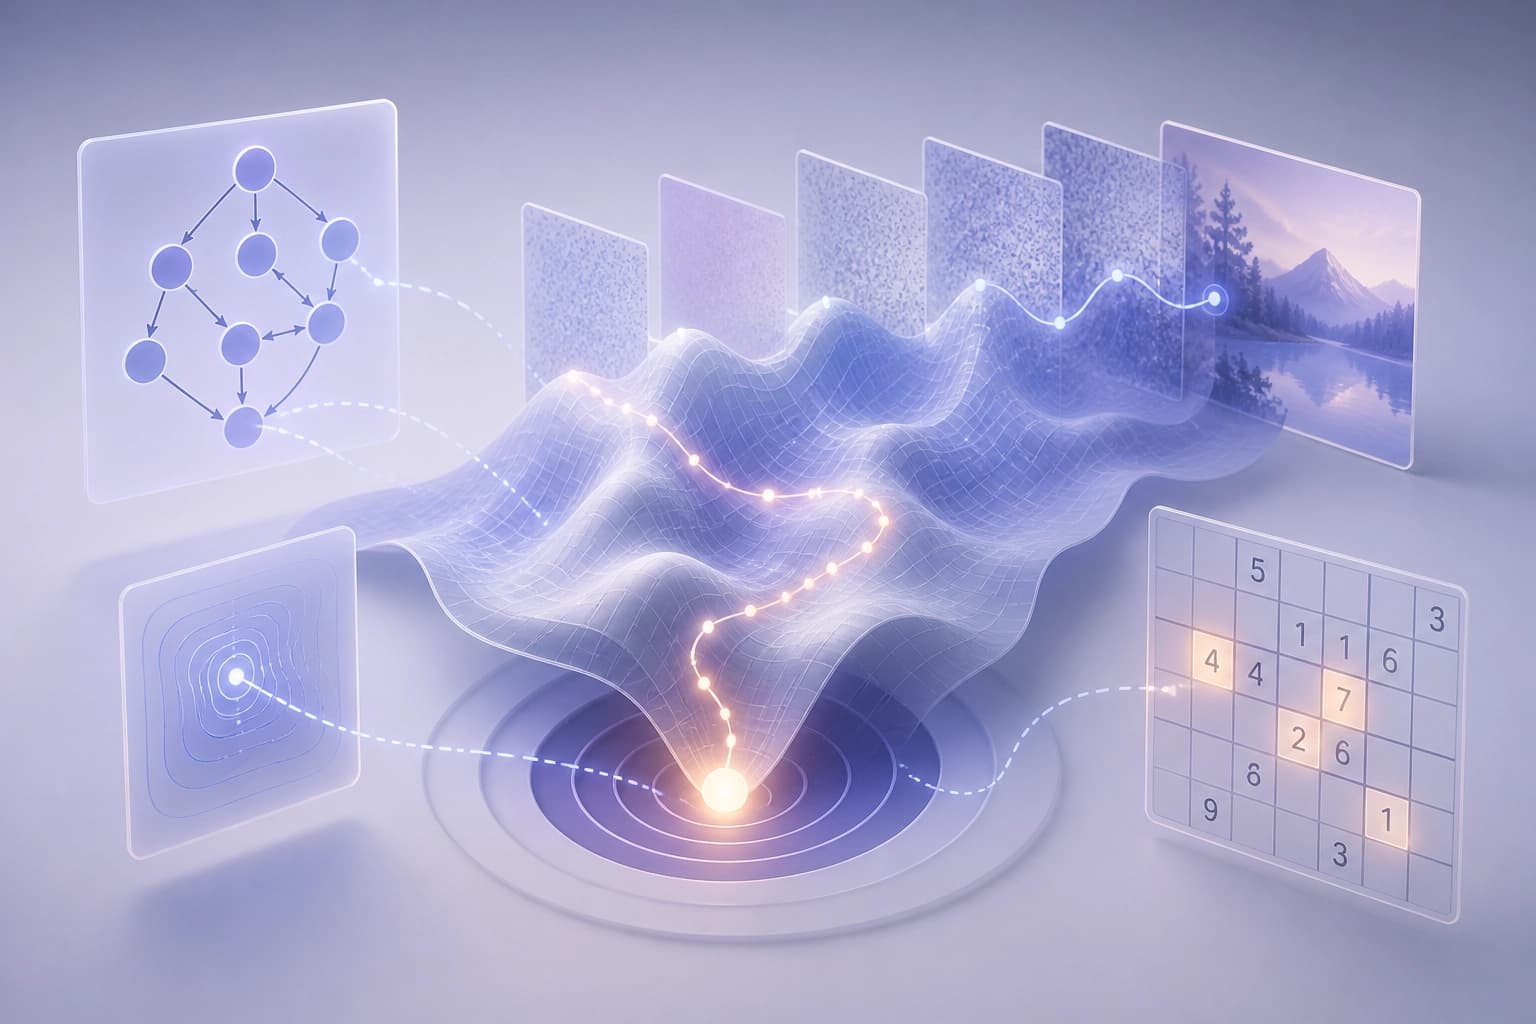
Problème : avidité locale des modèles AR et faible causalité des DLM
Les modèles autorégressifs souffrent d’une avidité locale. Les modèles de langage à diffusion manquent souvent d’une structure causale rigoureuse pour le raisonnement.
| Type de modèle | Limitation |
|---|---|
| AR | Avidité locale |
| DLM | Manque d’une structure causale rigoureuse pour le raisonnement |
Conclusion : le raisonnement nécessite un mécanisme qui relie la génération à des contraintes causales. Critère pratique : vérifier comment le modèle préserve la structure logique au fil des étapes intermédiaires.
Framework et objectif
CaLR est un framework conçu pour rendre l’inférence des modèles à diffusion plus robuste. Il formule le raisonnement comme une optimisation latente sous contraintes. Titre complet : « CaLR: Causal Latent Revision for Robust Diffusion Reasoning ». Auteurs : Wei Cai, Jian Zhao, Yuchen Yuan, Xuelong Li. Date de soumission : 17 sept. 2026.
Conclusion : CaLR associe une inférence robuste à l’optimisation de représentations latentes. Critère pratique : choisir cette méthode lorsque la tâche nécessite une structure causale dans le raisonnement.
Composants de l’approche
CaLR utilise trois éléments. Le premier est la matrice de topologie causale (CTM). Cette matrice est obtenue auprès d’un modèle expert. Le deuxième est la différentiation implicite. Le troisième est la « révision de la pensée » guidée par le gradient.
Matrice de topologie causale (CTM)
La CTM est une matrice de topologie causale. Elle provient d’un modèle expert.
Différentiation implicite
CaLR utilise la différentiation implicite.
« Révision de la pensée » guidée par le gradient
Cette opération vise à garantir la cohérence logique. Elle vise également à permettre l’autocorrection dynamique des étapes intermédiaires pendant la génération parallèle.
Conclusion : la CTM fournit la structure causale, la différentiation implicite intervient dans l’optimisation et la révision de la pensée corrige les étapes. Critère pratique : vérifier qu’il existe une source de structure causale et un mécanisme de correction.
Résultats annoncés
CaLR atteint des performances SOTA pour les DLM sur des benchmarks complexes. Le framework surpasse de solides références autorégressives. Il démontre une robustesse accrue dans les tâches à contraintes, comme le Sudoku.
| Propriété | Résultat |
|---|---|
| Performances des DLM | SOTA sur des benchmarks complexes |
| Comparaison avec les modèles AR | Surpasse de solides références AR |
| Robustesse | Robustesse accrue dans les tâches à contraintes, comme le Sudoku |
Conclusion : les avantages annoncés concernent les benchmarks complexes et les tâches à contraintes. Critère pratique : comparer les exigences de la tâche à la robustesse dans les tâches à contraintes. Pour les autres scénarios, le résumé ne fournit pas de données.
Foire aux questions
Matériaux connexes
Tous matériaux
Invariants polynomiaux canoniques pour le diagnostic des défaillances des simulateurs RL : où sont-ils vraiment utiles
Ce travail évalue la pertinence d’intégrer les lois physiques dans des modèles de dynamique entraînables : les invariants extraits des trajectoires et mis sous forme canonique à l’aide de bases de Gröbner n’apportent qu’un gain modeste en matière de prédiction, mais se révèlent très utiles pour le diagnostic — ils permettent de localiser la contrainte violée et d’identifier le paramètre erroné.
10 novembre 2026
AURA-Eval : comment vérifier qu’un agent LLM a reconnu le risque et modifié l’étape suivante
Le framework évalue le comportement des agents LLM non pas d’après leur verdict final, mais selon leur réaction au risque aux étapes clés : les trajectoires d’appels aux outils sont interrompues, puis le modèle doit poursuivre son raisonnement et son action, tandis qu’un panel de juges LLM examine la détection du risque, sa nature et la sécurité de l’étape. Sur 1 249 tâches issues de 157 trajectoires R-Judge, les actions dangereuses deviennent plus fréquentes chez 20 modèles en l’absence de voie sûre, et la levée de la supervision avant l’exécution fait basculer 52,3 % des cas initialement sûrs dans la catégorie des cas dangereux.
10 novembre 2026
Mémoire du réservoir de Chern-Simons : dynamique autonome de la connectivité et transfert de densité
L’article explique comment un réservoir conserve l’historique des signaux d’entrée à la fois dans la distribution de densité et dans les degrés de liberté géométriques. La comparaison de quatre mécanismes montre que le courant crée une composante de connectivité distincte, qui modifie la réponse ultérieure de la densité, tandis que la prise en compte de toutes les caractéristiques mesurées apporte un léger gain dans le décodage de l’ordre des impulsions.
10 novembre 2026