
Las señales de los semáforos están controladas por VLALight, un modelo VLA: inferencia de acciones de extremo a extremo directamente a partir del vídeo de cámaras viales
Los autores proponen VLALight, un modelo integral de tipo «visión-lenguaje-acción» que convierte directamente las grabaciones multicámara de las intersecciones en cambios de fase de los semáforos, sin recurrir a estados del tráfico definidos manualmente. Se basa en una percepción conjunta que tiene en cuenta la topología de la intersección, el aprendizaje por refuerzo a escala de red urbana y la selección adaptativa entre un razonamiento rápido y uno profundo. En siete conjuntos de datos reales de tres ciudades, la solución superó a los modelos de tráfico, los métodos de aprendizaje por refuerzo y los LLM/VLM usados como referencia.
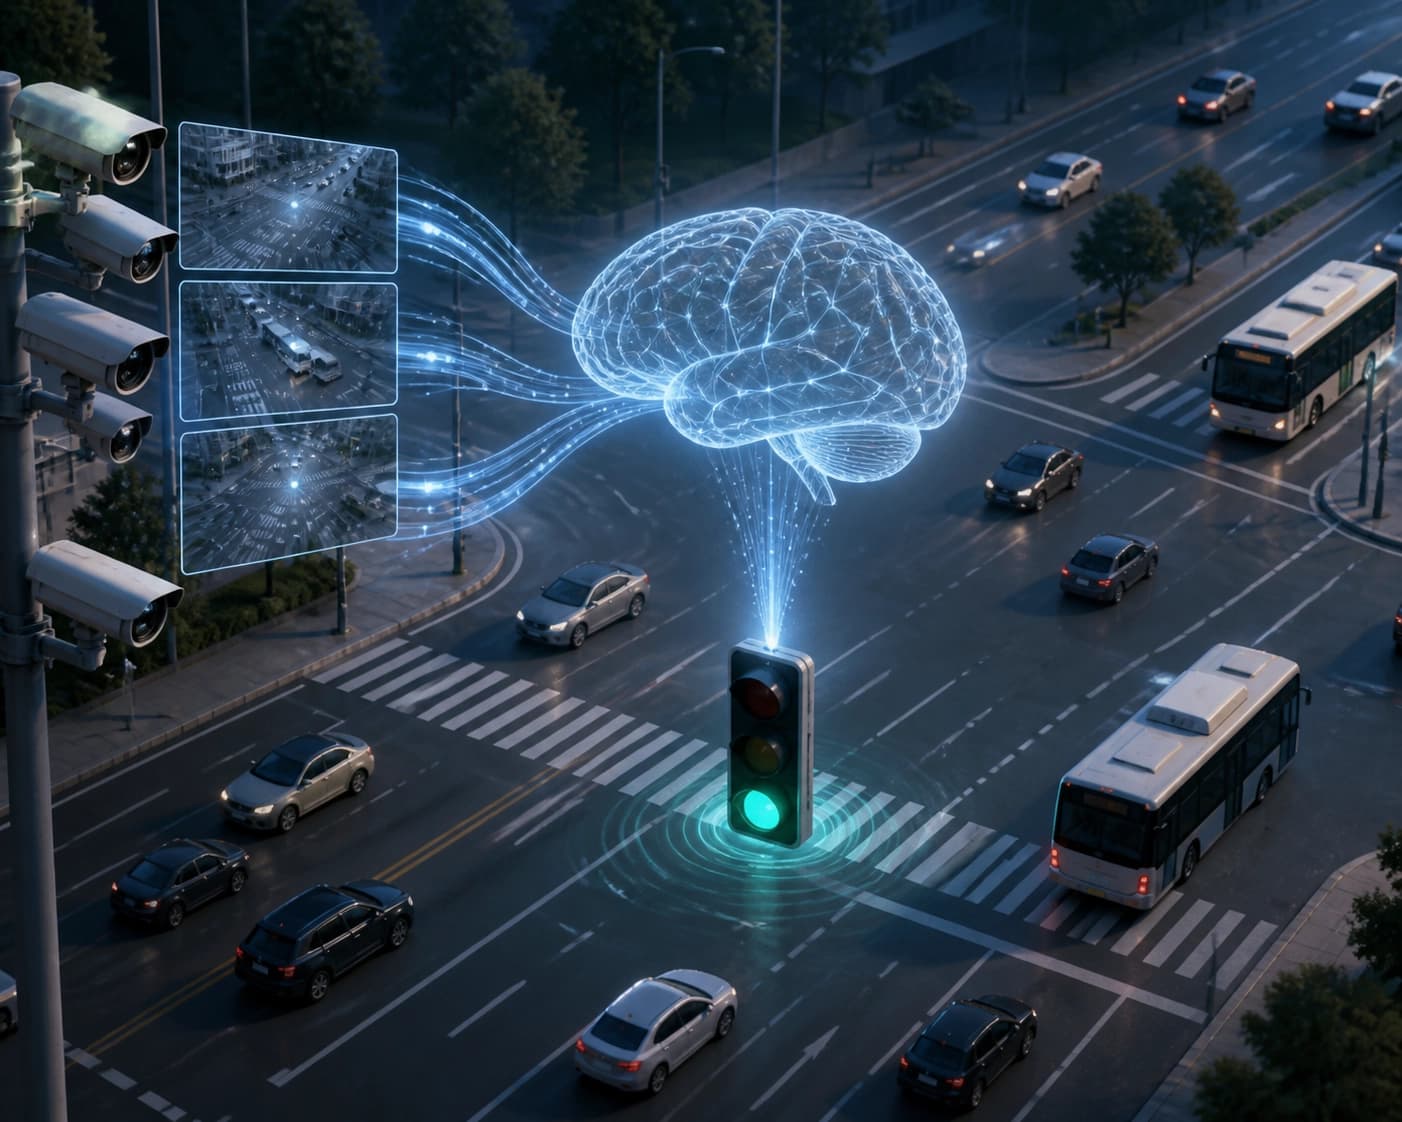
Qué es un modelo VLA para controlar semáforos
VLALight es un modelo de vision-language-action para controlar semáforos. Autores: Pan Zhang, Siqi Lai, Kemu Dong, Hao Liu. El artículo se presentó el 29 de septiembre de 2026. Es el primer modelo VLA para el control integral de semáforos mediante vídeos multivista de cámaras situadas en la vía.
El modelo transforma directamente las observaciones visuales en acciones coordinadas de los semáforos. Utiliza razonamiento espaciotemporal sobre múltiples objetivos. También incorpora topológicamente la percepción conjunta en las intersecciones.
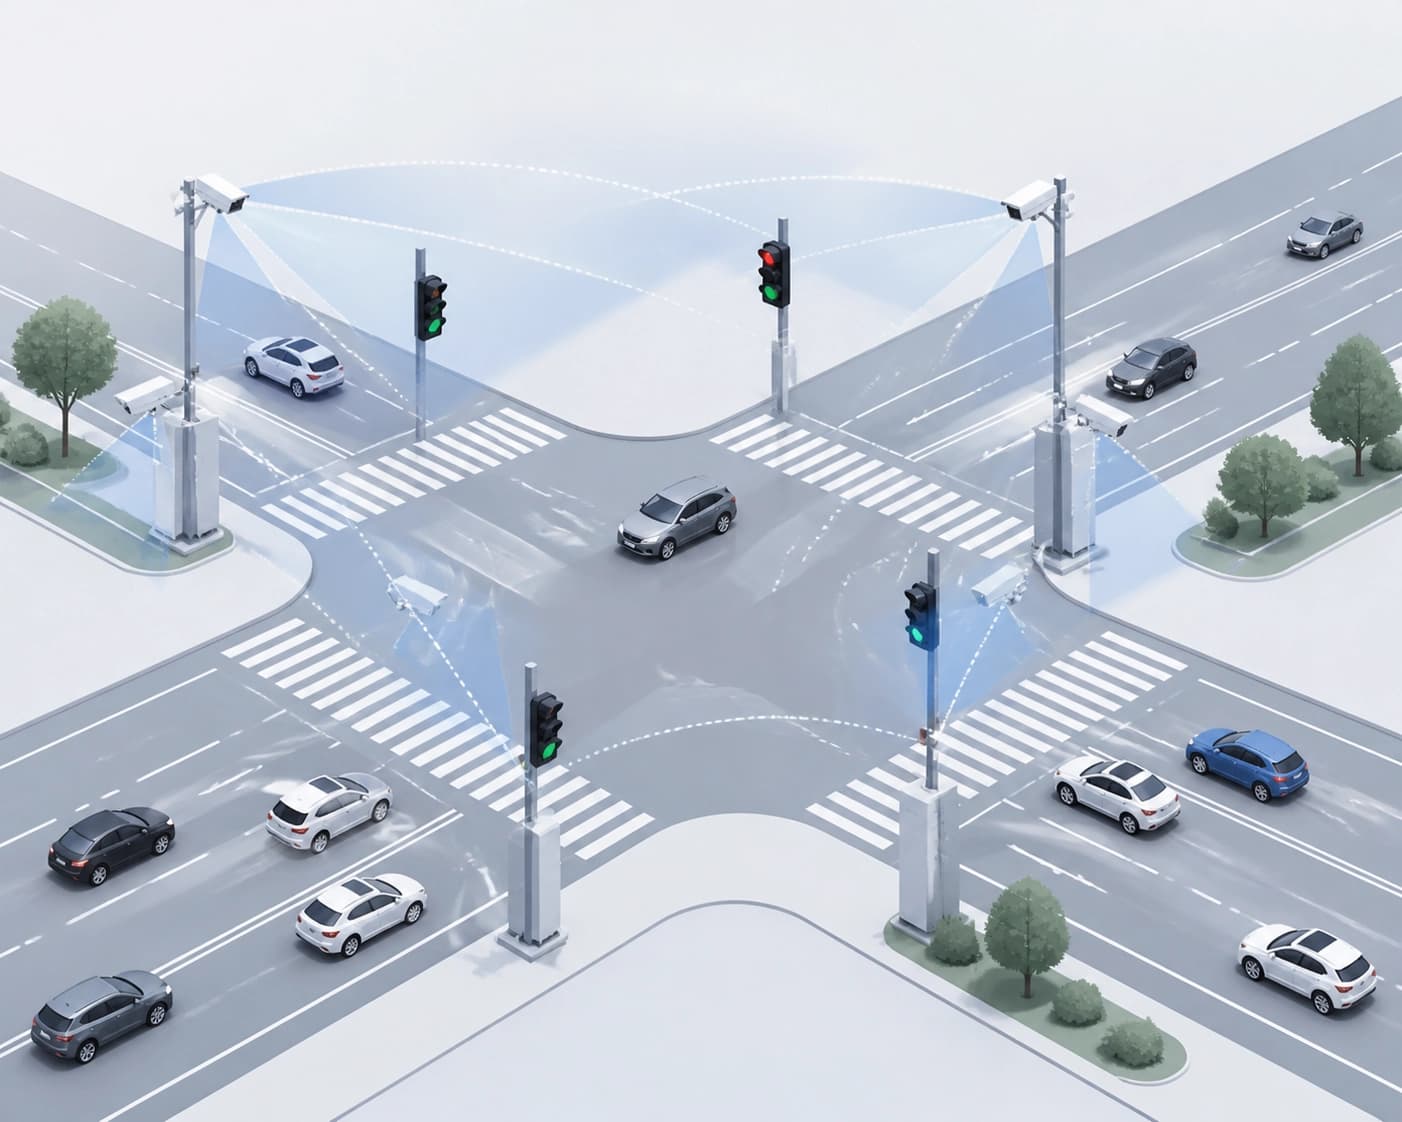
Características clave del enfoque:
- Inferencia integral: las observaciones visuales se convierten en acciones de los semáforos.
- Vídeo multivista: los datos proceden de cámaras situadas en la vía.
- Razonamiento espaciotemporal: el modelo tiene en cuenta múltiples objetivos.
- Integración topológica: percepción conjunta en las intersecciones.
Criterio de selección: el enfoque VLA combina percepción y control en un mismo modelo. Esto lo diferencia de los sistemas en los que estas tareas están separadas. La conexión integral entre vídeo y acciones es el criterio principal.
Cómo se entrena VLALight: dos etapas
El entrenamiento de VLALight incluye una estrategia de dos etapas. Primero se aplica supervised cold-start. Esta etapa desarrolla la comprensión visual de la situación del tráfico y la toma de decisiones sobre las señales. Después se incorpora cooperative agentic reinforcement learning.
La segunda etapa optimiza conjuntamente el control local y la eficiencia de toda la red de transporte. La primera etapa se ocupa de comprender la escena y las señales. La segunda optimiza el control local y la red.
| Etapa | Tarea | Qué optimiza |
|---|---|---|
| Supervised cold-start | Comprensión visual de la situación del tráfico y toma de decisiones sobre las señales | Habilidades iniciales del modelo |
| Cooperative agentic reinforcement learning | Optimización conjunta | Control local y eficiencia de la red |
Criterio de selección: comprobar si el enfoque incluye una optimización conjunta a nivel de red. Las decisiones locales sin contexto de red limitan el efecto. Las dos etapas separan el entrenamiento de la percepción y la optimización de la interacción.
Modos de razonamiento adaptativos y coste de inferencia
VLALight utiliza modos adaptativos de razonamiento rápido y lento. El razonamiento más profundo solo se aplica cuando aporta suficiente beneficio al control. El modelo utiliza mode-aware rollouts equilibrados y relative advantage optimization. Aprende a encontrar un equilibrio entre la calidad de las decisiones y el coste de inferencia.
| Modo | Condición de activación | Efecto |
|---|---|---|
| Rápido | El razonamiento profundo no aporta suficiente beneficio | Menor coste de inferencia |
| Lento | El razonamiento profundo aporta suficiente beneficio | Decisiones de mayor calidad |
Criterio de selección: equilibrio entre la calidad de las decisiones y el coste de inferencia. Los modos deben cambiar en función del beneficio para el control. Mantener siempre la máxima profundidad aumenta el coste.
Qué demostraron los experimentos
Los experimentos se realizaron con siete conjuntos de datos sobre tráfico real. Abarcan tres redes urbanas. VLALight superó a los métodos de referencia. Entre ellos se encuentran modelos de transporte, aprendizaje por refuerzo y LLM/VLM.
| Clase de métodos de referencia | Función en la comparación |
|---|---|
| Modelos de transporte | Referencia |
| Aprendizaje por refuerzo | Referencia |
| LLM/VLM | Referencia |
Los estudios de ablación confirmaron la eficacia de la percepción conjunta, la optimización a nivel de red y el razonamiento adaptativo. Los autores señalan el potencial de los modelos VLA para controlar sistemas de transporte físicos reales.
Criterio de selección: comprobar la composición de los métodos de referencia y si se incluyen ablaciones. Los experimentos abarcan tráfico real y tres redes urbanas. La contribución de cada componente debe confirmarse por separado.
Preguntas frecuentes
Material similar
Todos los materiales
Evaluación de agentes de programación en el desarrollo interactivo de XR: resultados de GenXR-Bench
Se ha publicado GenXR-Bench, un conjunto de 112 tareas expertas para evaluar de forma integral agentes de programación en el desarrollo interactivo de XR: desde la mejora de funciones y la corrección de defectos hasta la creación de aplicaciones con verificación del comportamiento en dispositivos de consumo. Entre los diez modelos probados, el mejor resultado fue un 50,9 % en Pass@1; los fallos recurrentes incluyeron la gestión de eventos asíncronos de sensores, el anclaje de objetos al espacio real y la comprensión de las interacciones en un contexto físico.
5 noviembre 2026
Anotación híbrida de imágenes: la automatización acelera el entrenamiento de modelos de visión por computadora
El artículo describe cómo el preetiquetado mediante algoritmos reduce el trabajo manual y mejora la calidad de los conjuntos de datos de entrenamiento, así como por qué sigue siendo necesaria la verificación selectiva por parte de una persona. También se analizan las limitaciones del método en condiciones de captura difíciles y con tipos de objetos poco frecuentes.
5 noviembre 2026
De la recompensa escalar al frente de Pareto: síntesis RTL de LLM mediante aprendizaje por refuerzo multiobjetivo
Se propone un método para entrenar un modelo de lenguaje para que genere no un solo diseño, sino un conjunto de candidatos RTL con distintos compromisos entre área, latencia y consumo energético; la recompensa se basa en la contribución de cada variante al hipervolumen del frente de Pareto. En RTLLM v2, el hipervolumen relativo aumentó 13,3 puntos porcentuales frente a la versión base sin optimización PPA y 14,4 puntos porcentuales frente al entrenamiento por refuerzo con un único objetivo.
5 noviembre 2026