Por qué la trayectoria es una mala unidad de medida
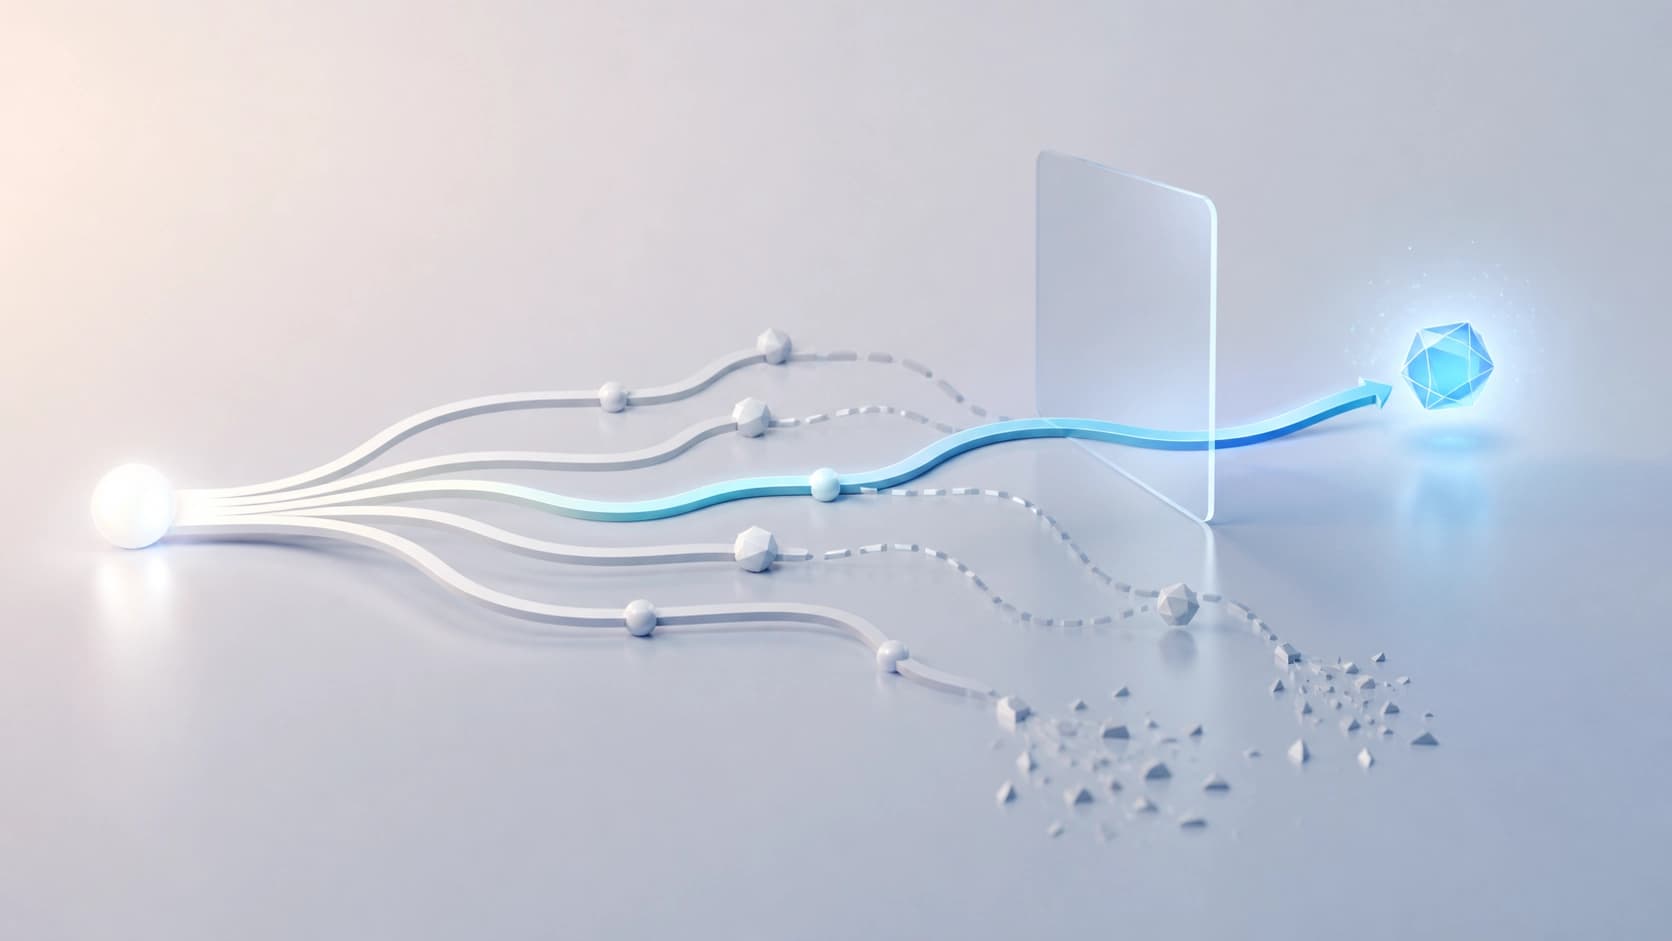
Los métodos modernos de razonamiento durante la inferencia funcionan con el mismo esquema: el modelo genera no una sola respuesta, sino todo un conjunto de cadenas candidatas, tras lo cual un modelo de recompensa externo elige la mejor. La lógica es simple: cuantas más variantes haya, mayor será la probabilidad de que entre ellas aparezca una acertada.
El punto débil está en otro lugar. Cada candidato se considera como un todo indivisible: o se acepta por completo, o se envía entero a la basura. Pero un razonamiento largo rara vez es homogéneo. El cuadro típico es un inicio seguro y correcto, un planteamiento cuidadoso del problema, un método bien elegido y, después, un colapso: un error aritmético, un bucle, una sustitución de la condición. Formalmente, toda la cadena se marca como fallida, aunque su primera mitad era perfectamente funcional.
El resultado son cálculos desperdiciados. Pagamos por la generación de tokens que eran correctos y luego los descartamos junto con la cola dañada. Precisamente a esta ineficiencia apuntan los autores del trabajo Selective Regenerative Decoding, publicado como arXiv:2608.24338 (cs.AI) el 25 de agosto de 2026.
SRD: tres ramas en lugar de dos
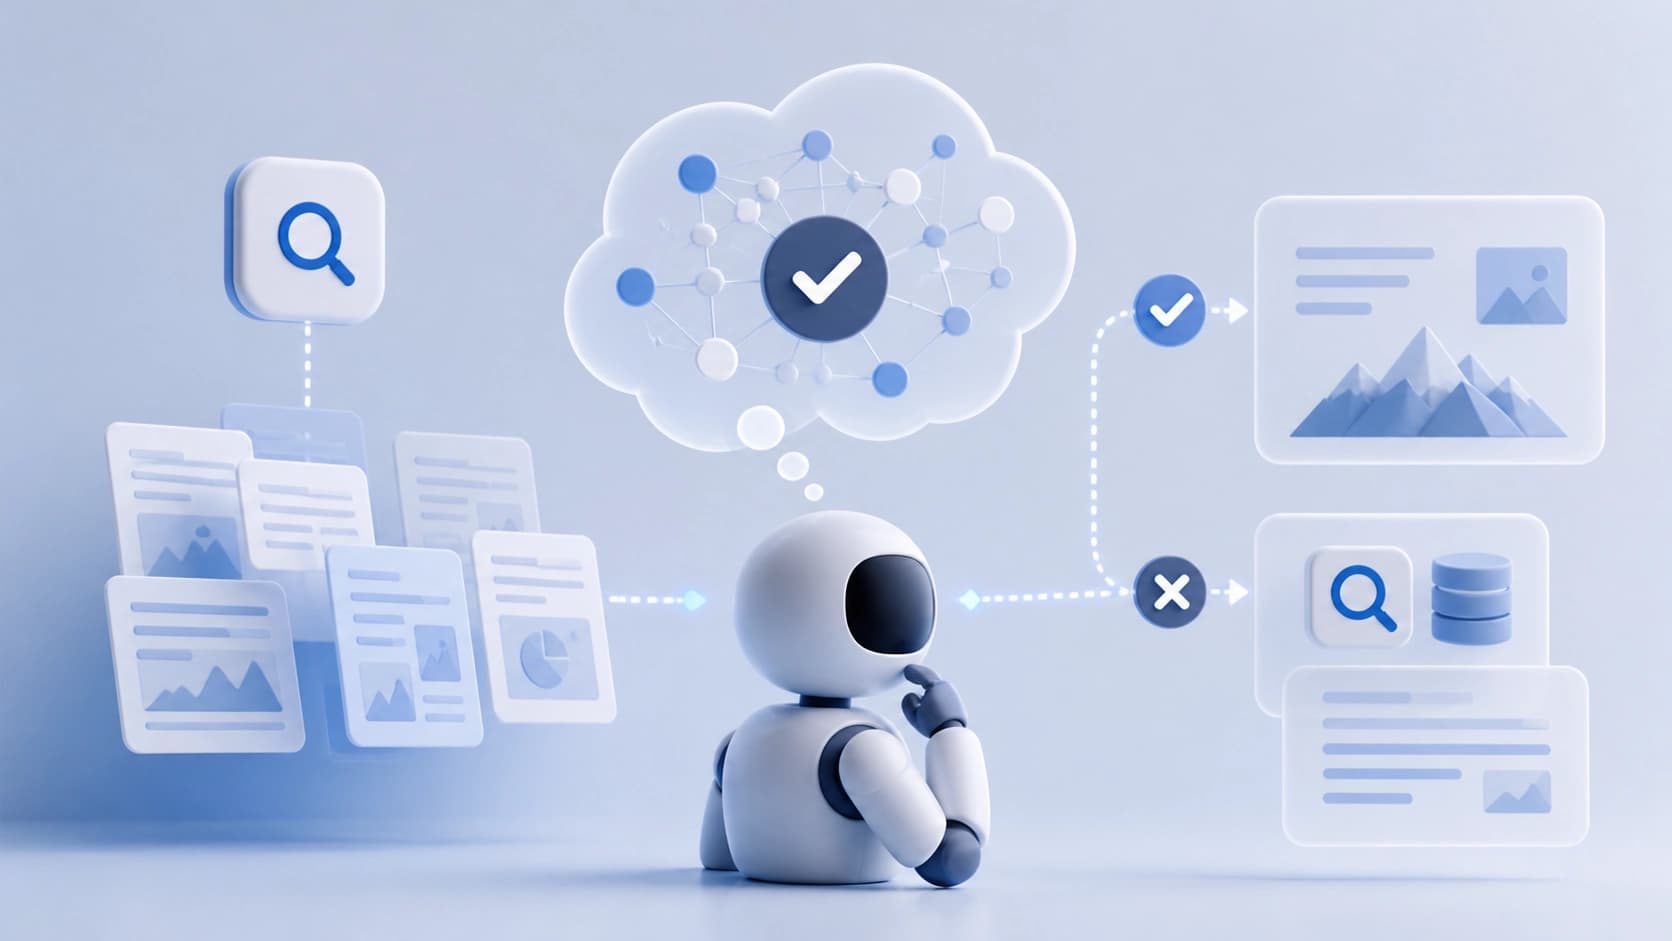
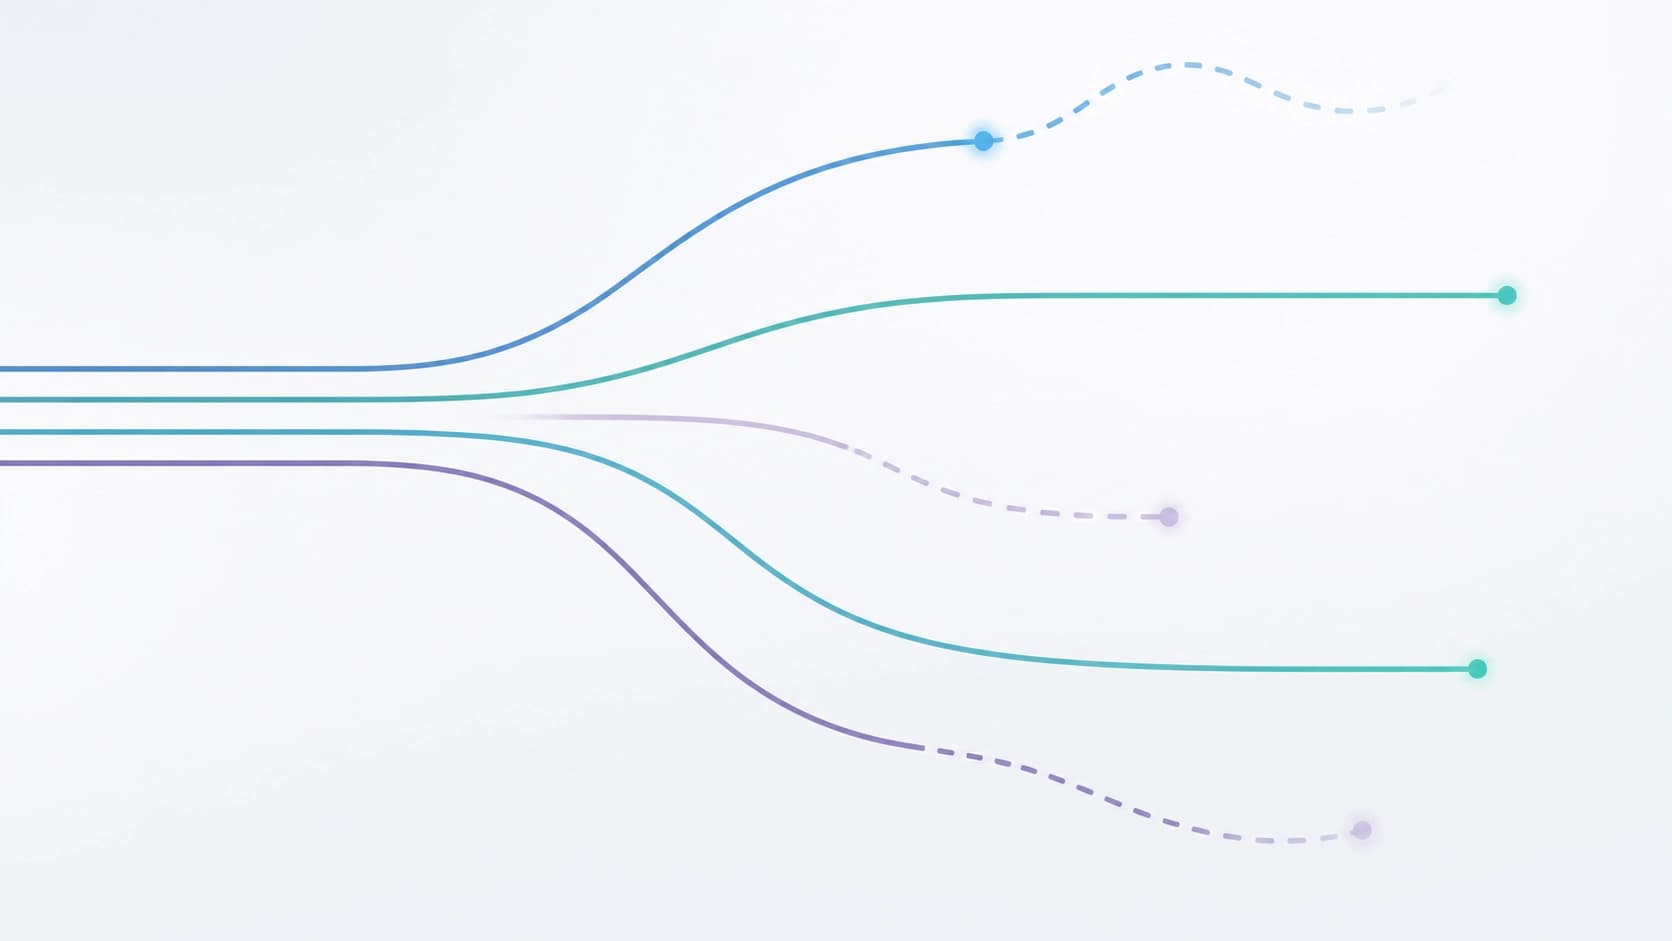
Selective Regenerative Decoding (SRD) propone renunciar a la elección binaria. En lugar de "aceptar o descartar", cada candidato se dirige a una de tres ramas:
- descartar — si la cadena es inútil de principio a fin;
- conservar — si supera la verificación en su totalidad;
- reelaborar — si hay una parte útil, pero el sufijo se ha degradado claramente.
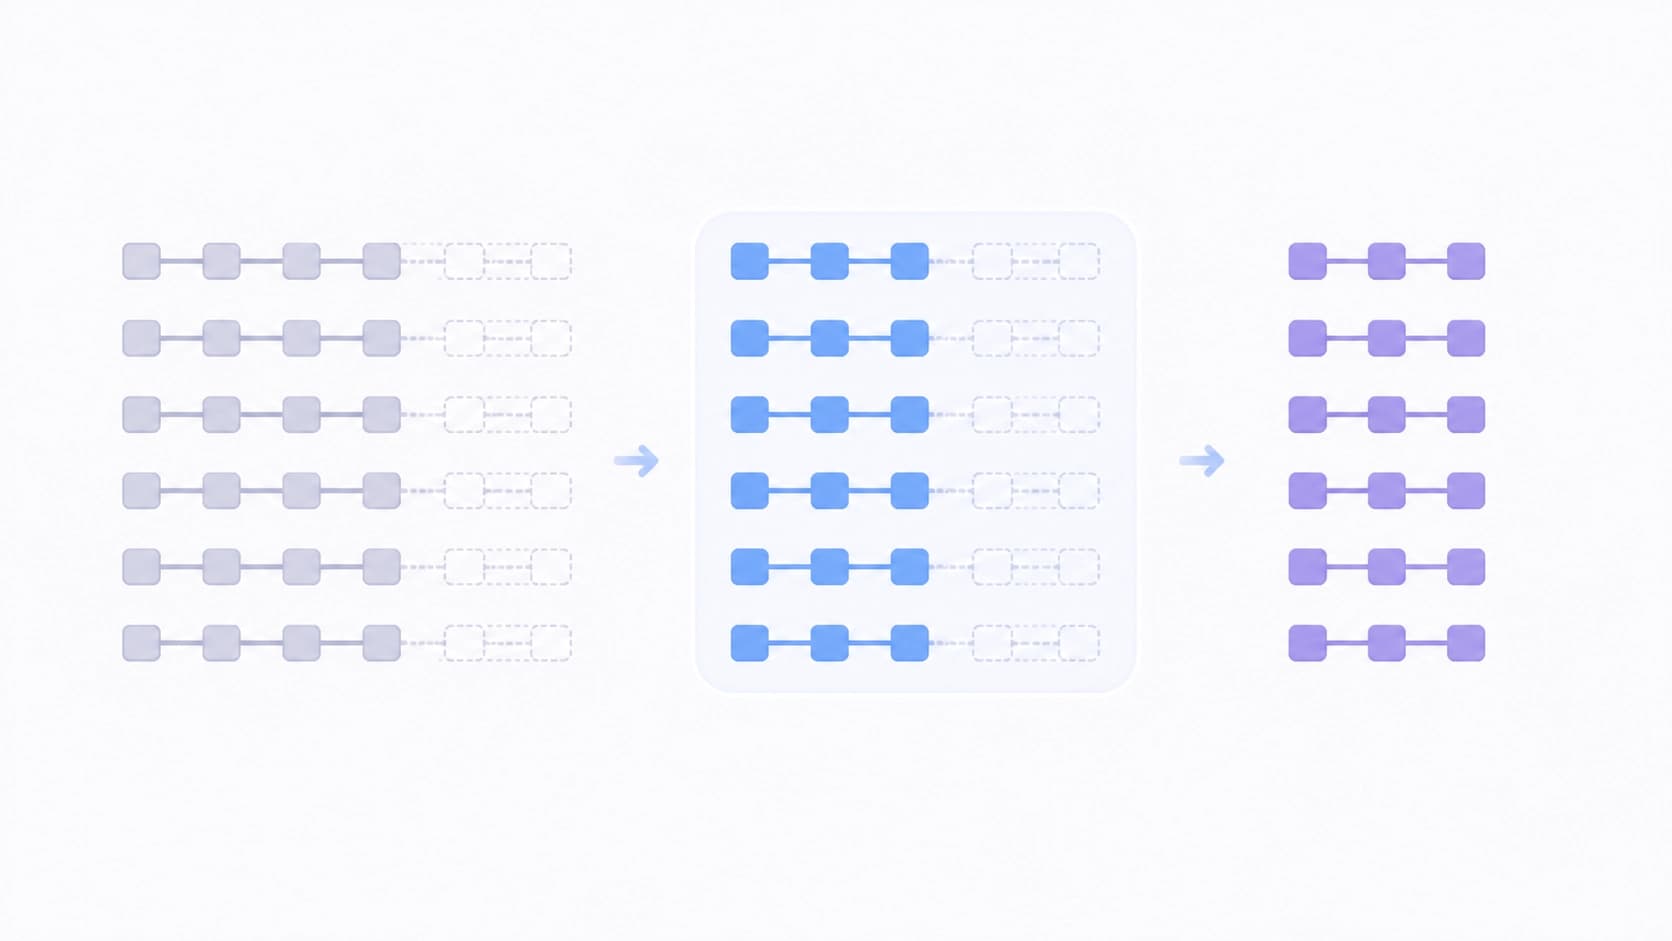
En el tercer caso, el sistema no reescribe el razonamiento desde cero, sino que conserva el prefijo de calidad y regenera solo el tramo dañado. Esto se parece más a editar un borrador que a escribir un texto nuevo: no descartas una introducción acertada por un final fallido, sino que corriges lo que se rompió.
Los autores subrayan además que para esta intervención no se requiere un modelo donante más grande. Nada de un "maestro inteligente" que saque adelante a un alumno débil: todo el trabajo ocurre dentro de los recursos computacionales ya disponibles. Esto es precisamente lo que hace que el método sea aplicado y no un ejercicio teórico.
De dónde viene la ganancia
Lo más interesante del trabajo no es la heurística, sino su justificación. Bajo supuestos suaves, SRD ofrece un crecimiento demostrable de la eficiencia de muestreo de 1,28–1,36 veces respecto al rejection sampling clásico, y además la calidad esperada de la trayectoria final resulta estrictamente superior, y no simplemente "no peor".
La intuición aquí se entiende sin fórmulas. El candidato que ha pasado por la regeneración del sufijo ya contiene en sí mismo cálculos pagados: esos tokens del prefijo que no hace falta generar de nuevo. Cuantos más candidatos limítrofes de este tipo se logren rescatar, menor será la proporción de texto generado que acaba en la papelera. Y como al aumentar el conjunto de candidatos también crece el número de cadenas "casi acertadas", la ganancia no se mantiene constante: escala junto con el presupuesto de generación.
Dónde se comprobó
La parte empírica abarca cuatro tipos distintos de carga: MATH500 (problemas matemáticos), GPQA Diamond (preguntas de nivel científico), HotpotQA (preguntas de varios pasos sobre documentos) y AlpacaEval (seguimiento de instrucciones y evaluación de preferencias). Las pruebas se realizaron con varias combinaciones de "generador + modelo de recompensa", para que el resultado no dependiera de una única pareja afortunada.
Los resultados declarados: SRD alcanza la precisión que normalmente se obtiene con el modo Best-of-N, pero consume notablemente menos tokens generados. Y en escenarios con cómputo limitado, el método supera a speculative rejection, es decir, gana precisamente donde cada token adicional cuesta caro.
Qué cambia esto en esencia
El principal cambio que señalan los autores es metodológico. Antes, la elección ocurría a nivel de toda la trayectoria: el modelo de recompensa ponía una nota y decidía el destino de todo el razonamiento. SRD traslada la intervención al interior de la trayectoria, al nivel de segmentos, y gracias a ello abre un área de compromiso entre precisión y cómputo que hasta ahora apenas se había estudiado.
La conclusión práctica para quienes construyen pipelines de inferencia: la calidad del razonamiento y el costo de obtenerlo no son necesariamente magnitudes rígidamente vinculadas. Parte de los cálculos "sobrantes" se pueden recuperar si dejamos de tratar el borrador del modelo como un monolito.
Qué queda fuera de escena
Preguntas abiertas no faltan. La clave es cómo se determina exactamente la frontera entre un prefijo sano y un sufijo degradado: de este criterio depende cuántos candidatos llegarán siquiera a la tercera rama. Después está el costo de la propia regeneración (no es gratis), la sensibilidad a la elección del modelo de recompensa y la transferibilidad de las conclusiones más allá de los cuatro benchmarks utilizados.
El trabajo ocupa 20 páginas y fue presentado en ARR, es decir, por ahora es un preprint de la primera versión, no un resultado revisado por pares. Pero la dirección parece prometedora: en lugar de generar más y seleccionar con más dureza, se puede administrar con más cuidado lo que el modelo ya ha ideado.