Por qué el RAG agéntico se topa con una bifurcación
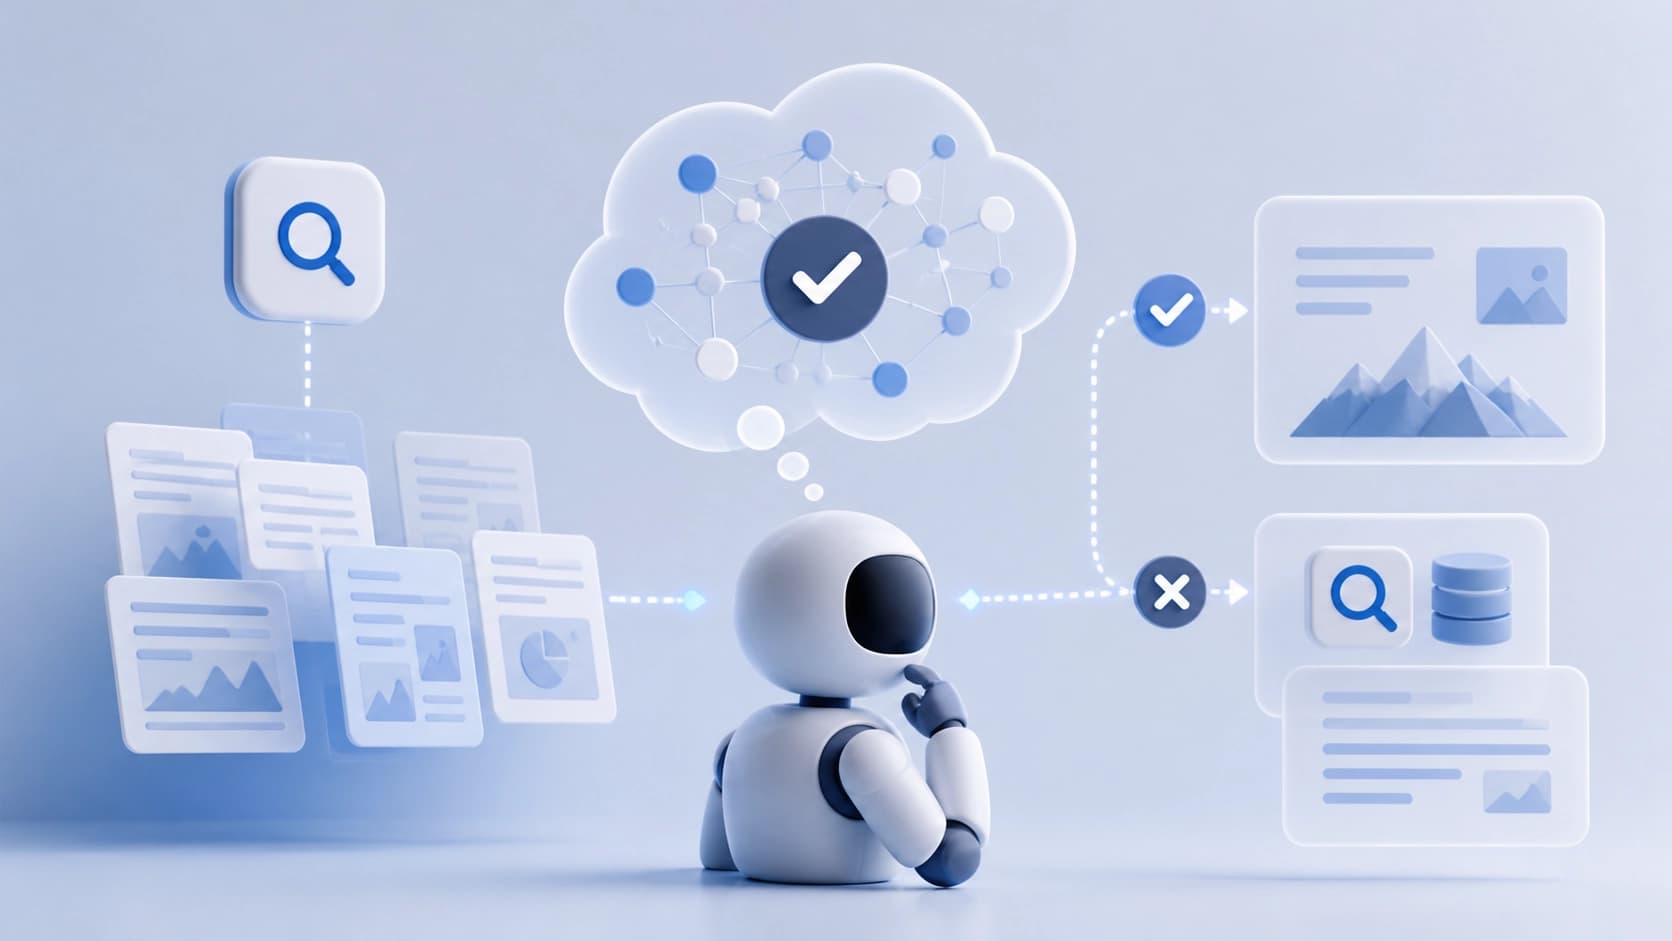
El RAG agéntico funciona como un ciclo: el modelo lee la pregunta, decide si necesita otra consulta a la búsqueda, recibe los resultados y vuelve a elegir — seguir buscando o responder ya. Cada iteración de más cuesta dinero y tiempo, cada una omitida amenaza con una respuesta incompleta. Resulta que la principal habilidad del agente no es la extracción de documentos, sino la capacidad de decir a tiempo «las pruebas son suficientes».
El aprendizaje por refuerzo clásico evalúa ese comportamiento desde fuera: la respuesta coincidió con la referencia — más, no coincidió — menos. Nadie pregunta qué piensa el propio modelo sobre la completitud de los datos reunidos. De ahí surgen dos enfermedades simétricas: la política o bien sigue cavando cuando por dentro ya todo está claro, o bien corta la búsqueda aunque los datos son obviamente escasos. La recompensa externa no distingue estas situaciones — el resultado es el mismo, pero el comportamiento es distinto.
Un cambio en el planteamiento del problema
Los autores del trabajo MetaRAG proponen mirar no solo la acción, sino también en qué medida coincide con la convicción interna del agente sobre la suficiencia de las pruebas. A este planteamiento lo llaman alineación de convicciones y acciones — belief-action alignment. La idea es simple: la calidad de la decisión de búsqueda no es una métrica aparte sobre la respuesta, sino la coherencia entre lo que el modelo «piensa» y lo que hace.
Cómo está construido MetaRAG
El framework se compone de tres partes: una verificación explícita antes de la acción, una sonda de convicción interna y una recompensa especial que conecta una cosa con la otra.
Verificación antes de la acción
El primer componente es Verify-first Action Generation. En lugar de emitir de inmediato el siguiente paso, la política primero lo pasa por un procedimiento explícito de verificación: si esa acción se ajusta al estado actual de la búsqueda. La idea es filtrar las decisiones impulsivas antes de que lleguen a la trayectoria. En esencia, es una «pausa» integrada en la generación, que suele faltarles a los agentes rápidos.
Sonda de convicción interna
El segundo componente es Internal Belief Probing. A partir del mismo contexto que ve la política (la pregunta más el historial de acciones y observaciones), se lee por separado su propia opinión: si ya estamos respondiendo a la pregunta en este momento. Es importante que no se trata de un modelo juez externo ni de anotación humana — la señal se toma de la misma política, solo que planteada de otra manera.
Recompensa por coherencia con un salvaguarda
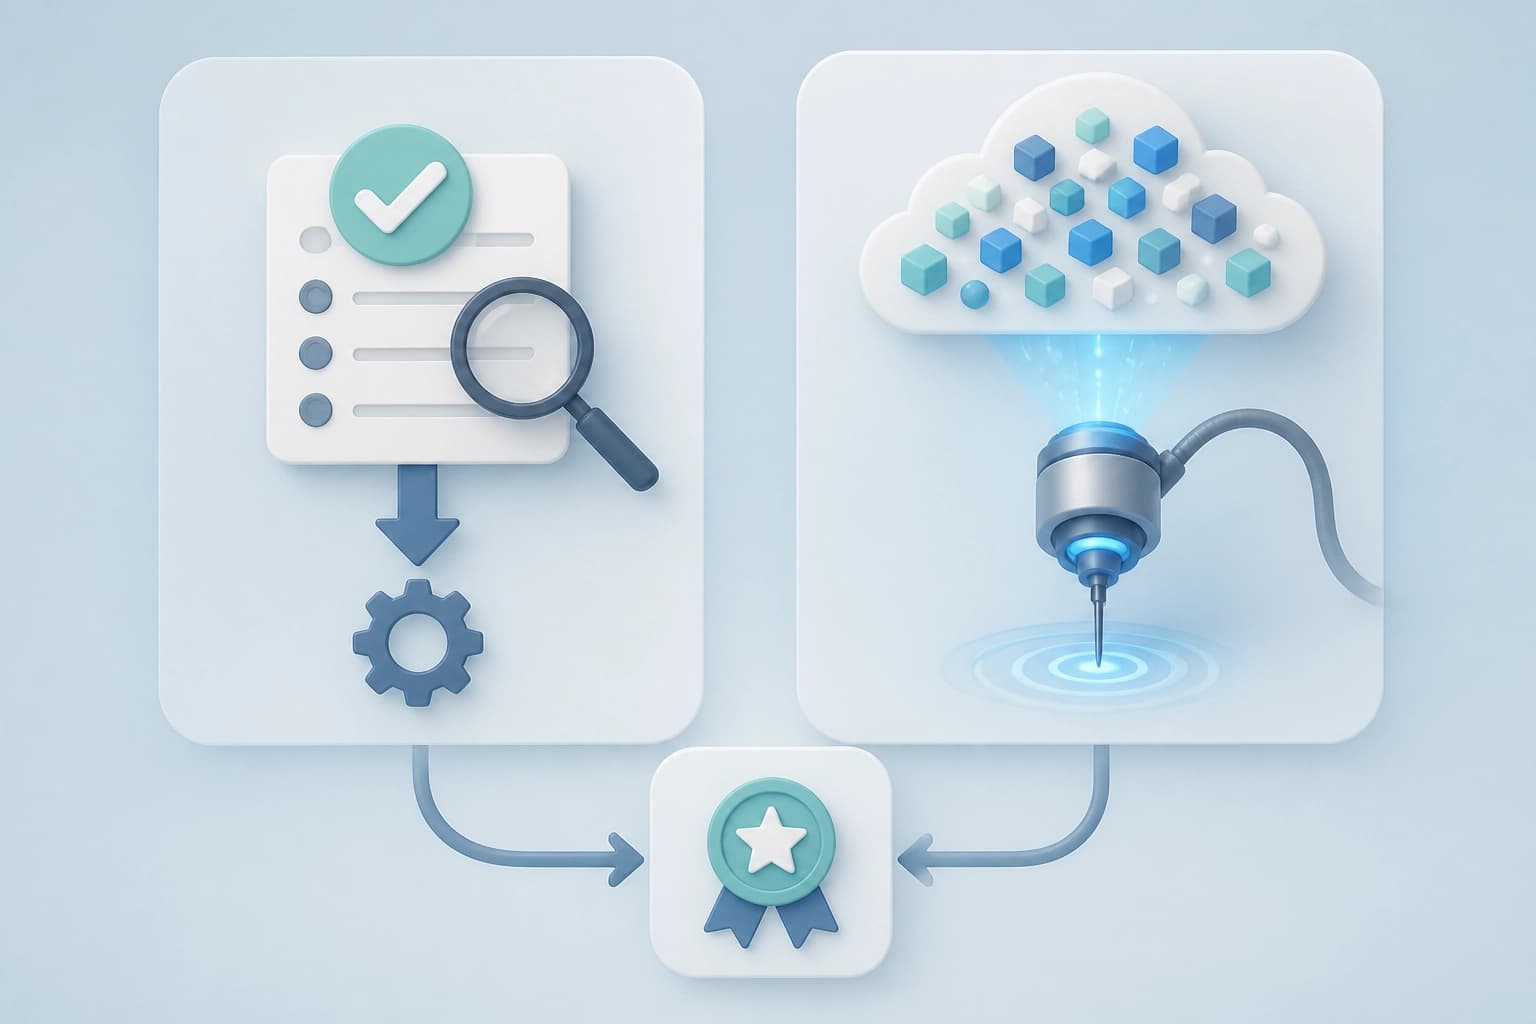
De estas dos señales se deriva la consistency reward: el agente recibe un incentivo cuando su acción coincide con la evaluación interna de la suficiencia de las pruebas. Aquí hay una trampa evidente — se puede empezar a recompensar un comportamiento «confiadamente incorrecto» si el modelo se equivoca de forma coherente y consistente. Los autores la cierran con un gate: la recompensa por coherencia se tiene en cuenta solo cuando la respuesta resultó correcta. En otras palabras, la coherencia no es un fin en sí mismo, sino un multiplicador de la corrección.
Un detalle aparte, importante para los profesionales: la sonda de convicción vive solo en la etapa de entrenamiento. En inferencia no se invoca, así que no aparecen cálculos extra por cada consulta — los costos adicionales se mantienen en cero.
Qué mostraron los experimentos
El trabajo se verificó en siete benchmarks públicos de preguntas y respuestas. El resultado declarado es una mejora sostenida del compromiso entre precisión y eficiencia respecto a métodos base de RL fuertes para el RAG agéntico. Es decir, la ganancia no está en responder simplemente con más precisión, sino en no pagar por ello con una búsqueda infinita.
Después, los autores comprobaron hasta qué punto el efecto se transfiere: a escenarios de investigación profunda (deep research), a distintos optimizadores y a distintos modelos base. En todas esas configuraciones, el método, según sus datos, conserva la ventaja. Este es justamente el tipo de verificación que suele faltar: una mejora en un solo modelo y un solo conjunto de datos se confunde fácilmente con un ajuste afortunado de hiperparámetros.
Qué significa esto en la práctica
Para los desarrolladores de sistemas de búsqueda agénticos, MetaRAG señala una dirección que es más barata de lo que parece. Si ya cuentan con entrenamiento de la política, añadir una señal sobre la convicción interna no requiere nuevos anotadores: el mismo contexto que la política ya ve puede usarse como fuente de señal. El gate por corrección es obligatorio en este caso — sin él, el agente puede aprender a equivocarse de forma bonita y segura.
La segunda conclusión se refiere al diseño de la recompensa en general. Las métricas externas responden a la pregunta «¿salió bien?», pero casi no dicen nada sobre «¿fue el agente adecuado en el momento?». Distinguir estas dos cosas es la idea principal del artículo: la coherencia entre convicción y acción es un objeto autónomo, optimizable por separado, y no un efecto secundario del aumento de precisión.
No obstante, conviene tener presentes los límites: los experimentos se limitan a benchmarks de QA y a escenarios de investigación profunda, y el propio enfoque se construye sobre el aprendizaje por RL, es decir, no es aplicable «de fábrica» a sistemas donde la política no se entrena en absoluto. Para esos casos es más útil la idea en sí — verificar explícitamente la acción antes de ejecutarla y evaluar por separado si la decisión coincide con la sensación interna de suficiencia de los datos.
El texto completo está disponible como arXiv:2608.24214 (v1, 25 de agosto de 2026, sección cs.AI) — el trabajo fue aceptado en el programa principal de la conferencia EMNLP 2026.