Por qué es tan difícil automatizar la evaluación de agentes de voz
Un agente de voz conversacional no es un solo modelo, sino un pipeline: reconocimiento de voz, razonamiento, invocación de herramientas, generación de respuesta, síntesis y streaming de audio. Un fallo en cualquier etapa no se queda localizado: se arrastra por la cadena y emerge ya en el propio diálogo. Por eso tiene sentido juzgar la calidad de la interacción solo de forma integral, end-to-end, y no por eslabones aislados.
Mantener una plantilla de evaluadores humanos es caro e incómodo: no se escala a cientos de miles de conversaciones y su atención decae hacia el final del turno. La salida natural es delegar la evaluación a un modelo de lenguaje. Un preprint reciente de arXiv:2608.24314 (Anupam Purwar, Shashank Singh, Kritika Srivastava) precisamente examina hasta qué punto esa salida está justificada y dónde se rompe.
Cómo los autores evaluaron a los jueces LLM
El experimento se construye sobre conversaciones reales de agentes de voz de dos sectores: telecomunicaciones y retail. Las evaluaciones humanas se compararon con los veredictos de GPT-4.1 y GPT-5, y no según una única escala general, sino según diez métricas: algunas describen la calidad de la propia conversación, otras la seguridad.
Tres configuraciones en lugar de una
Los mismos diálogos se pasaron por tres esquemas de evaluación: p0, p1 y p2. El sentido del ejercicio es simple: si el veredicto cambia según cómo se componga la rúbrica, significa que el juez no mide la calidad de la conversación, sino la forma de la instrucción. Cualquier métrica que "fluctúe" entre configuraciones no sirve para la automatización, al menos sin salvedades.
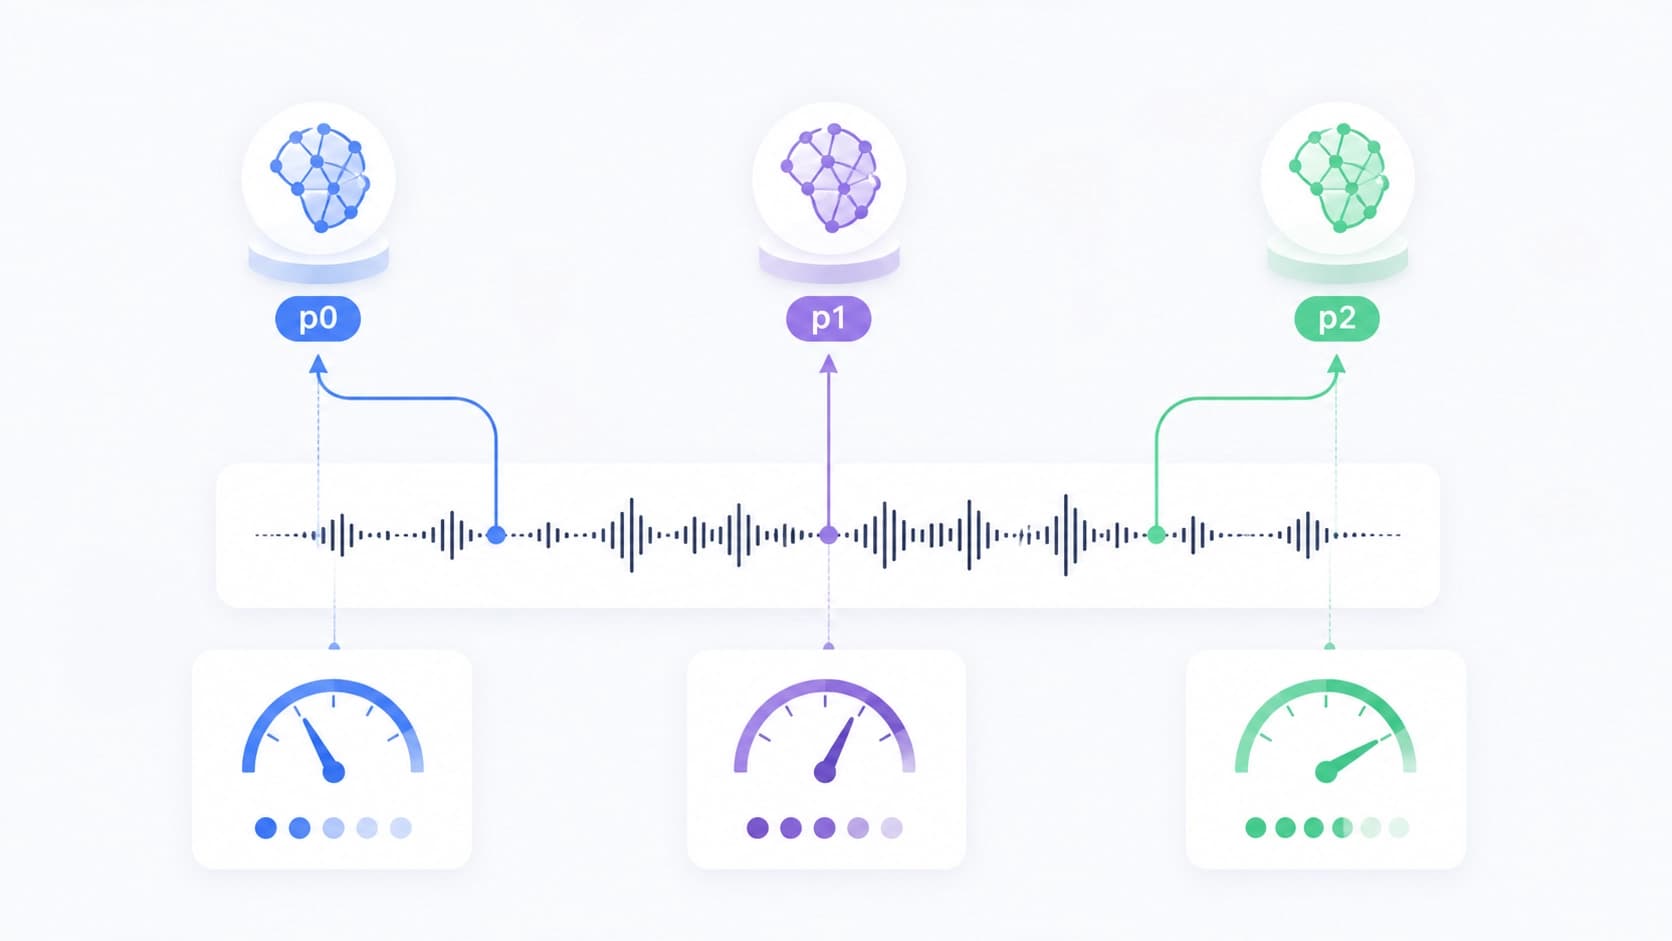
Qué se comparó exactamente
La concordancia agregada —el porcentaje de coincidencias entre humano y modelo— es solo la capa superficial. Los autores cavan más profundo: observan las correlaciones de cada métrica por separado, comprueban cuán estables son las evaluaciones dentro de un grupo de personas y analizan las discrepancias sistemáticas entre humano y LLM. Ese corte permite entender qué atributos de la conversación se prestan a la evaluación automática y cuáles chocan con el contexto y la interpretación.
Dónde se equivoca el juez LLM
La conclusión clave suena más a advertencia que a promoción del método: la fiabilidad de la evaluación automática no es uniforme, depende de la métrica concreta y de la configuración. Los mismos modelos-juez dan resultados sólidos en unas escalas y flaquean notablemente en otras.
Recovery Turn Count
Esta métrica cuenta cuántos turnos necesitó el agente para sacar la conversación de un fallo. La evaluación automática aquí no es fiable: el juez no siempre distingue una recuperación con sentido de una formulación afortunada por casualidad. Un diálogo que una persona calificaría como rescatado, el modelo lo registra fácilmente como un fracaso, y viceversa.
Métricas de seguridad por exhaustividad
Safety-recall es el segundo punto problemático. La lógica del error es predecible: el juez ve un diálogo donde el agente no dijo nada peligroso y otorga una puntuación alta, sin preguntarse si siquiera existía la posibilidad de violar la política. Una violación omitida es el tipo de error más costoso, y es justo donde la automatización es más débil.
El dominio cambia la calibración
La fiabilidad de los jueces difiere entre telecomunicaciones y retail. La conclusión práctica: los umbrales y las rúbricas no pueden trasladarse mecánicamente de un sector a otro; lo que está calibrado en un dominio, en otro se desajusta.
La calibración importa más que el porcentaje de coincidencia
Una cifra única de concordancia adormece la vigilancia. El modelo puede coincidir con las personas en promedio sobre grandes números, pero ser sistemáticamente más indulgente en los casos límite, y ese sesgo no se ve tras el porcentaje global. Por eso el análisis correlacional de la calibración y el desglose de las discrepancias por cada clase de casos son más útiles que una sola métrica resumen: muestran no "cuán cerca estamos", sino "hacia dónde y en qué nos equivocamos".
Cómo integrar esto en un pipeline real
Los autores no proponen renunciar a la automatización: proponen un esquema híbrido. El juez LLM asume la evaluación masiva, y las personas se quedan donde se necesita contexto y alta confianza en el veredicto. Las reglas prácticas son las siguientes:
- ejecuta la rúbrica en al menos dos o tres configuraciones y compara los resultados, no solo la puntuación final;
- calcula la concordancia de cada métrica por separado, no con un único número para todo el dataset;
- mantén a una persona en safety-recall y en las métricas de recuperación tras fallos;
- verifica la calibración en tu propio dominio antes de fijar umbrales automáticos;
- conserva los casos de discrepancia humano/modelo: son material listo para reentrenar la rúbrica.
Qué queda en resumen
El juez LLM es una herramienta útil para la evaluación a gran escala de agentes de voz, pero no un sustituto del evaluador. Su fiabilidad está distribuida de forma desigual: parte de las métricas puede delegarse sin problema a la automatización, y parte requiere una mirada humana. La utilidad del estudio radica en que ofrece un marco empírico para ese reparto del trabajo, y recuerda que la pregunta "¿confiar al modelo la evaluación?" es incorrecta mientras no se precise en qué métrica concreta y en qué dominio.