Problema: código que se ejecuta pero hace lo que no debe
Los agentes basados en grandes modelos de lenguaje ya son capaces de tomar un artículo científico y producir un repositorio funcional a partir de él. El problema es que "funcional" y "reproducible" no son sinónimos. Un script puede superar con éxito todas las pruebas, entrenar un modelo e imprimir una métrica vistosa, mientras que en su interior se ha sustituido silenciosamente el orden de los pasos, se ha perdido un multiplicador en la función de pérdida o se ha colocado un marcador de posición en lugar de una etapa no trivial.
Es precisamente este modo de fallo el que los autores de un nuevo trabajo denominan deriva semántica (semantic drift): el código generado se desvía silenciosamente de lo que se describe en la especificación del artículo. El error no salta a la vista: vive en los detalles que nadie verifica automáticamente. El resultado es una reproducción que formalmente tuvo lugar, pero que científicamente no confirma nada.
Qué es SA-Bench
Para medir la deriva, primero hay que hacerla observable. De esto se ocupa SemanticAlign-Bench, abreviado SA-Bench: un benchmark de diagnóstico descrito en el artículo arXiv:2608.24252 (aceptado en Findings of EMNLP 2026, autores: Xue Hu, Zewei Pan, Zeli Su, Zhou Liu y Wentao Zhang).
El material abarca 30 trabajos de las conferencias ICLR, ICML y NeurIPS de 2025 y se distribuye en cinco áreas de aprendizaje automático. No se evalúan las "sensaciones" que produce el código, sino un conjunto de afirmaciones verificables. En total, el benchmark reúne 1.491 de estas afirmaciones.
Semantic Alignment Units: los átomos de la especificación
La idea metodológica clave es descomponer la descripción del artículo en los elementos más pequeños que puedan verificarse manualmente contra el repositorio. Estos elementos se denominan Semantic Alignment Units (SAU). Cada unidad es una afirmación concreta sobre la implementación: un hiperparámetro específico, una fórmula, un orden de operaciones, una condición de parada, un esquema de división de datos.
Este enfoque granular es importante porque priva a la evaluación de su carácter binario de "salió / no salió". En lugar de una sola marca de verificación por artículo, aparecen cien preguntas pequeñas, y se ve exactamente dónde flaqueó la implementación.
Cuatro dimensiones de la deriva
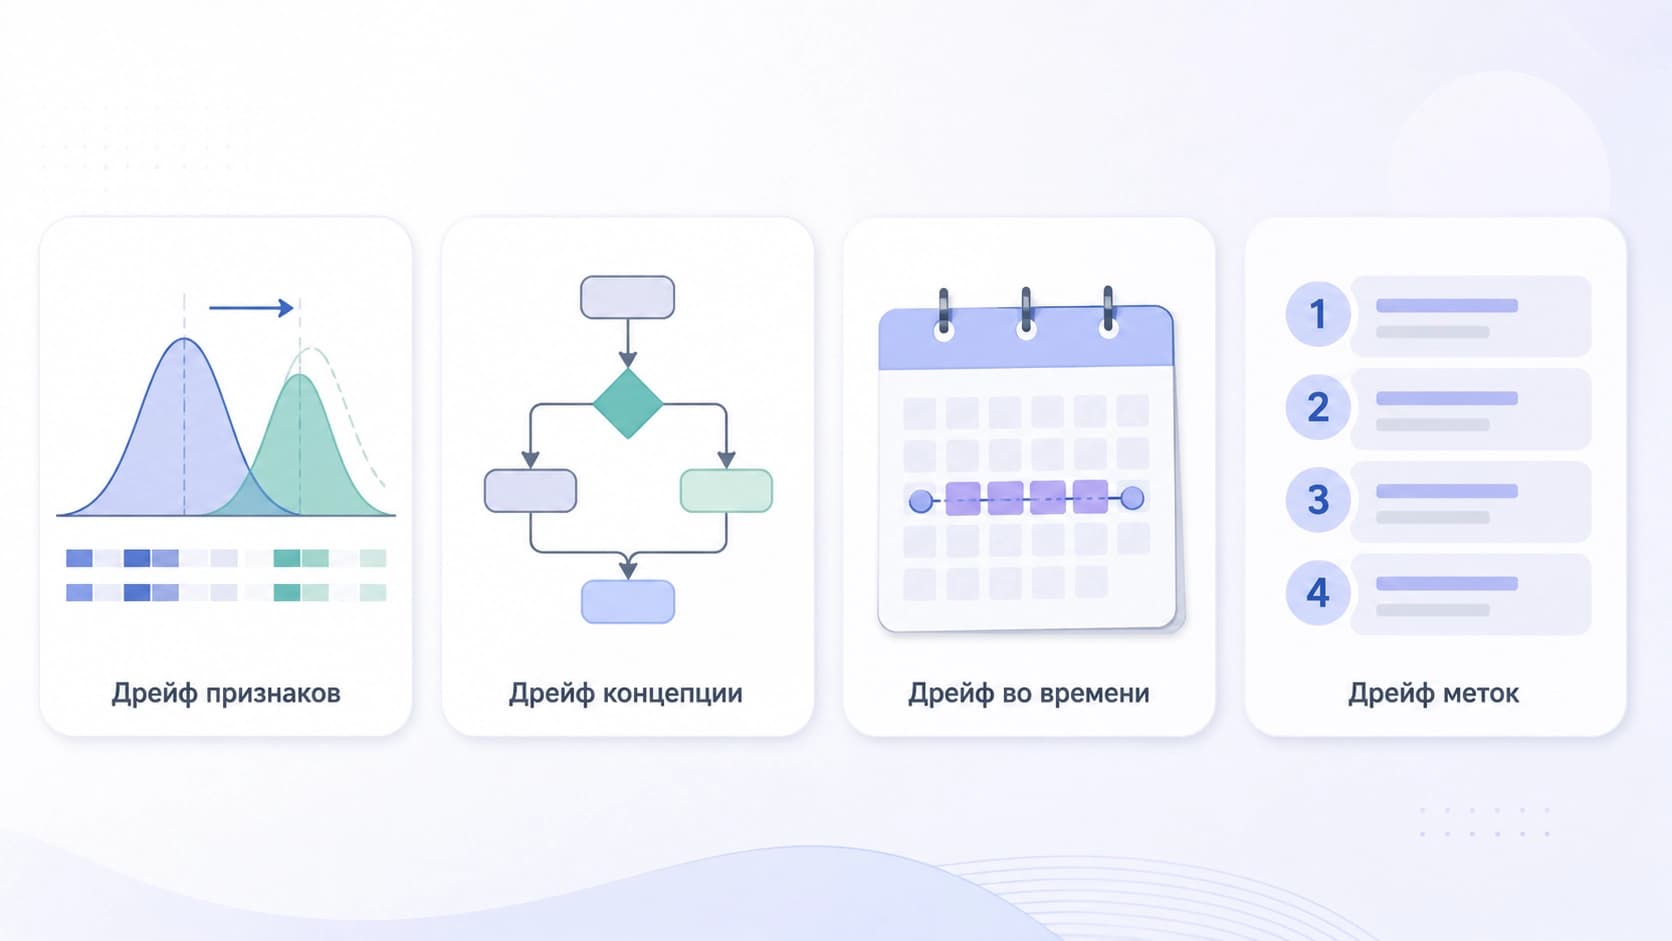
Cada repositorio se evalúa según cuatro ejes de diagnóstico:
- deriva numérica — los valores de coeficientes, dimensiones, umbrales y otras magnitudes no coinciden con la especificación;
- deriva metodológica — el propio procedimiento de entrenamiento o de cálculo está estructurado de forma distinta a la prevista en el trabajo;
- deriva de protocolo — se ha violado el esquema del experimento: la división de la muestra, las condiciones de comparación, el reglamento de evaluación;
- deriva de orden — los pasos se ejecutan en una secuencia incorrecta, y esto cambia el resultado.
La separación de los ejes aporta un beneficio práctico: el desarrollador ve, no un abstracto "la calidad es baja", sino un tipo concreto de fallo.
Resultados: 0.301 como techo
Los autores probaron 12 configuraciones de generadores: cuatro modelos en combinación con tres scaffolds. Cada evaluación se midió en fracciones de la unidad.
Las cifras resultaron aleccionadoras. El mejor resultado lo mostró la combinación de Claude y PaperCoder: en promedio, 0.301 puntos SAU de 1.0 posible. La puntuación media global de las 360 evaluaciones fue de 0.221.
En otras palabras, incluso la configuración más potente ejecuta correctamente menos de un tercio de lo que exige la especificación. Al mismo tiempo, los modelos no ignoran los requisitos: la taxonomía de fallos muestra que los agentes normalmente intentan cubrir la mayoría de los puntos, pero los implementan incorrectamente. La mayor parte de las afirmaciones anuladas proviene de dos escenarios: la falta de correspondencia entre la implementación y el propósito (implementation mismatch) y los stubs, es decir, los lugares donde en vez de la lógica real se deja una formalidad vacía.
Este perfil de errores revela algo importante: no se trata de la pereza del agente ni de que "no haya terminado de leer" el artículo. Se trata de que reproduce con confianza una versión verosímil pero incorrecta.
La ejecutabilidad no equivale a la fidelidad científica
Una conclusión aparte del trabajo se refiere a cómo están diseñados los scaffolds modernos. Aquellos optimizados para la ejecutabilidad —para que el código simplemente se ejecute y no falle— aportan un beneficio limitado a la reproducción científica. Es lógico: una ejecución exitosa verifica la sintaxis y la presencia de dependencias, pero no dice nada sobre si la lógica coincide con el propósito de los autores.
Para reducir la brecha se necesitan scaffolds de otro tipo: los que ponen en primer lugar la verificación de las especificaciones semánticas. En términos simples, el agente no solo debe escribir y ejecutar código, sino contrastar cada uno de sus pasos con una afirmación del artículo y ser capaz de demostrar que la coincidencia existe.
Qué cambia esto en la práctica
SA-Bench no es una competición de modelos, sino una herramienta de diagnóstico. Su valor radica en que traslada el debate sobre la reproducibilidad del plano de "funciona / no funciona" al plano de "cuán exactamente se corresponde". El benchmark, las anotaciones y el pipeline de evaluación están disponibles en acceso abierto, de modo que la metodología puede aplicarse también a tareas propias: por ejemplo, para verificar pipelines internos de generación de código a partir de especificaciones técnicas, y no solo de artículos científicos.
Para quienes construyen agentes, la conclusión es la siguiente: aumentar la "inteligencia" del generador sin una capa de verificación separada choca contra un techo. La deriva semántica no es un bug de un modelo concreto, sino una propiedad del enfoque en el que nadie verifica la correspondencia semántica. Y mientras no aparezca esa capa, la reproducción de código de investigación seguirá siendo una tarea en la que una persona todavía tiene que leer cada línea.