Producto escalar como cuello de botella
Casi todas las arquitecturas de atención modernas están construidas de la misma manera: la consulta y la clave se comparan mediante un producto escalar (o su versión normalizada), el resultado se convierte en pesos, y la salida se ensambla como una suma ponderada de los valores. El truco es universal, pero tiene un precio: la geometría del espacio de características en este esquema está fijada de forma rígida: la similitud se mide "en línea recta", sin tener en cuenta que distintas direcciones en el espacio pueden tener distinta relevancia y distinta escala.
Precisamente a esta limitación apunta el trabajo arXiv:2608.24462 «Mahalanobis-Based Multi-Head Attention for Complex State Propagation» (autor: Xiaohe Li; sección cs.AI). En lugar del producto habitual, utiliza un kernel RBF construido sobre la distancia de Mahalanobis. En términos simples, la similitud entre elementos de la secuencia no se calcula "a lo bruto", sino con corrección por la estructura de covarianza de los datos, como si el espacio, antes de la comparación, se estirara y rotara ligeramente para que las direcciones correlacionadas no se consideren independientes.
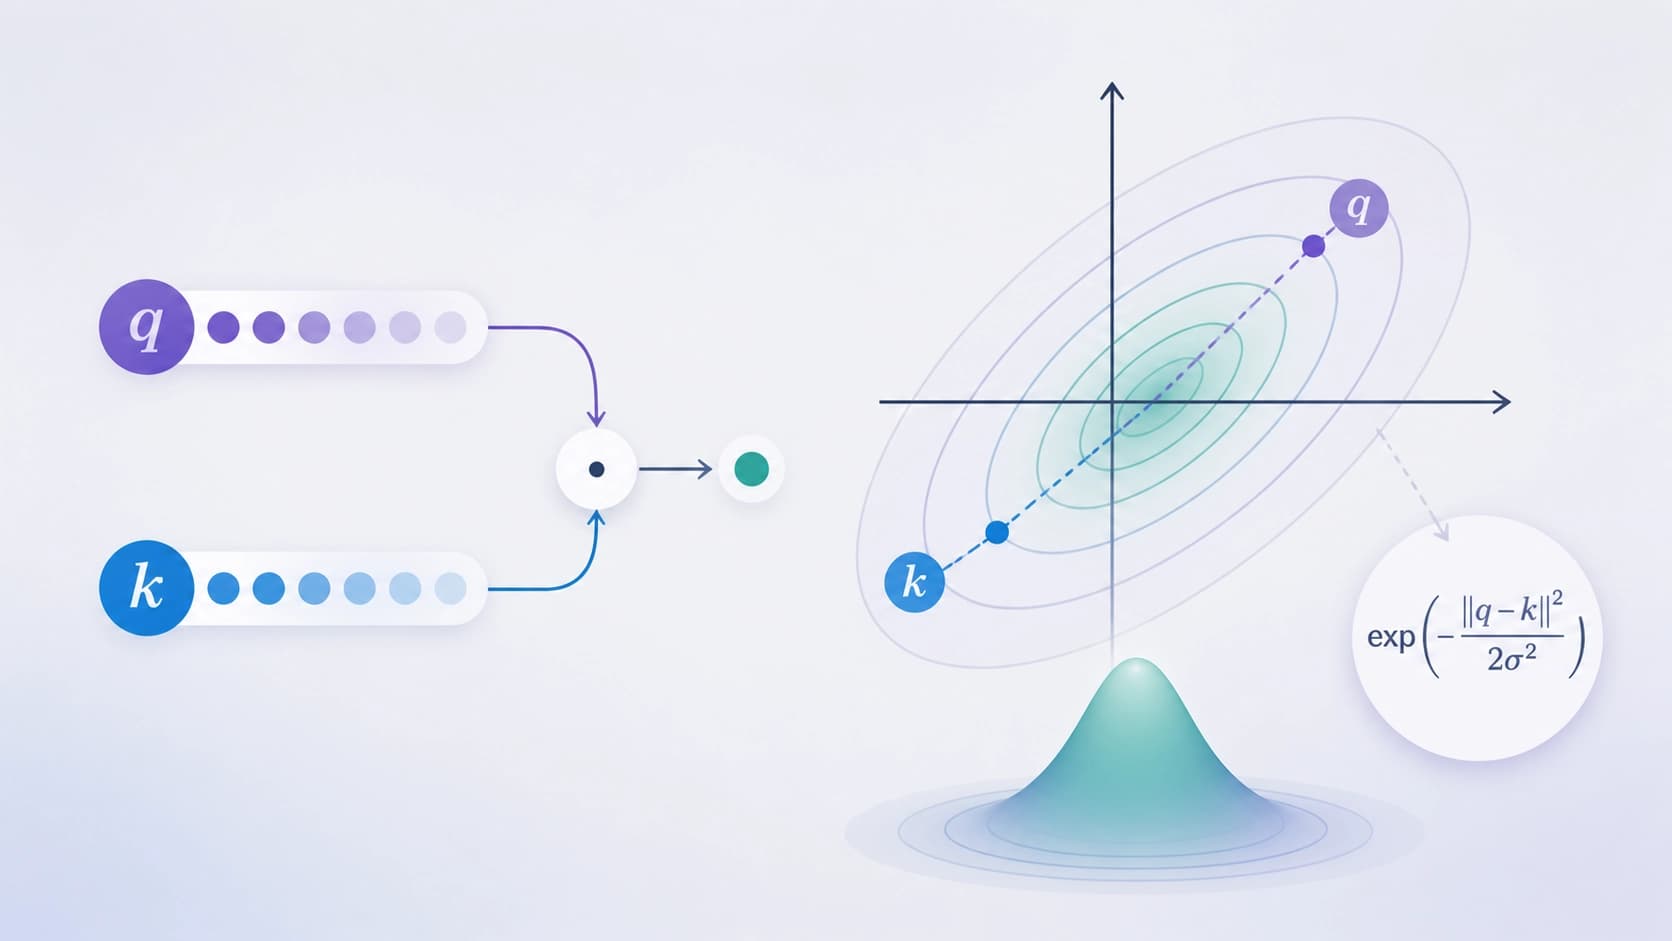
Qué aporta la distancia de Mahalanobis
Atención en un espacio de dimensión infinita sin crecimiento de parámetros
La afirmación clave del autor: el kernel RBF sobre la distancia de Mahalanobis permite calcular la atención como si esta viviera en un espacio de características de dimensión infinita, pero sin que aumente el número de parámetros entrenables. Esto no es magia, sino consecuencia de que el kernel ya de por sí define una transformación no lineal: no hace falta una capa separada para desplegar las características. En la práctica, esto implica requisitos más modestos de memoria y optimización, lo que en la era de los modelos gigantescos resulta casi provocador.
Definición positiva y Tree Attention
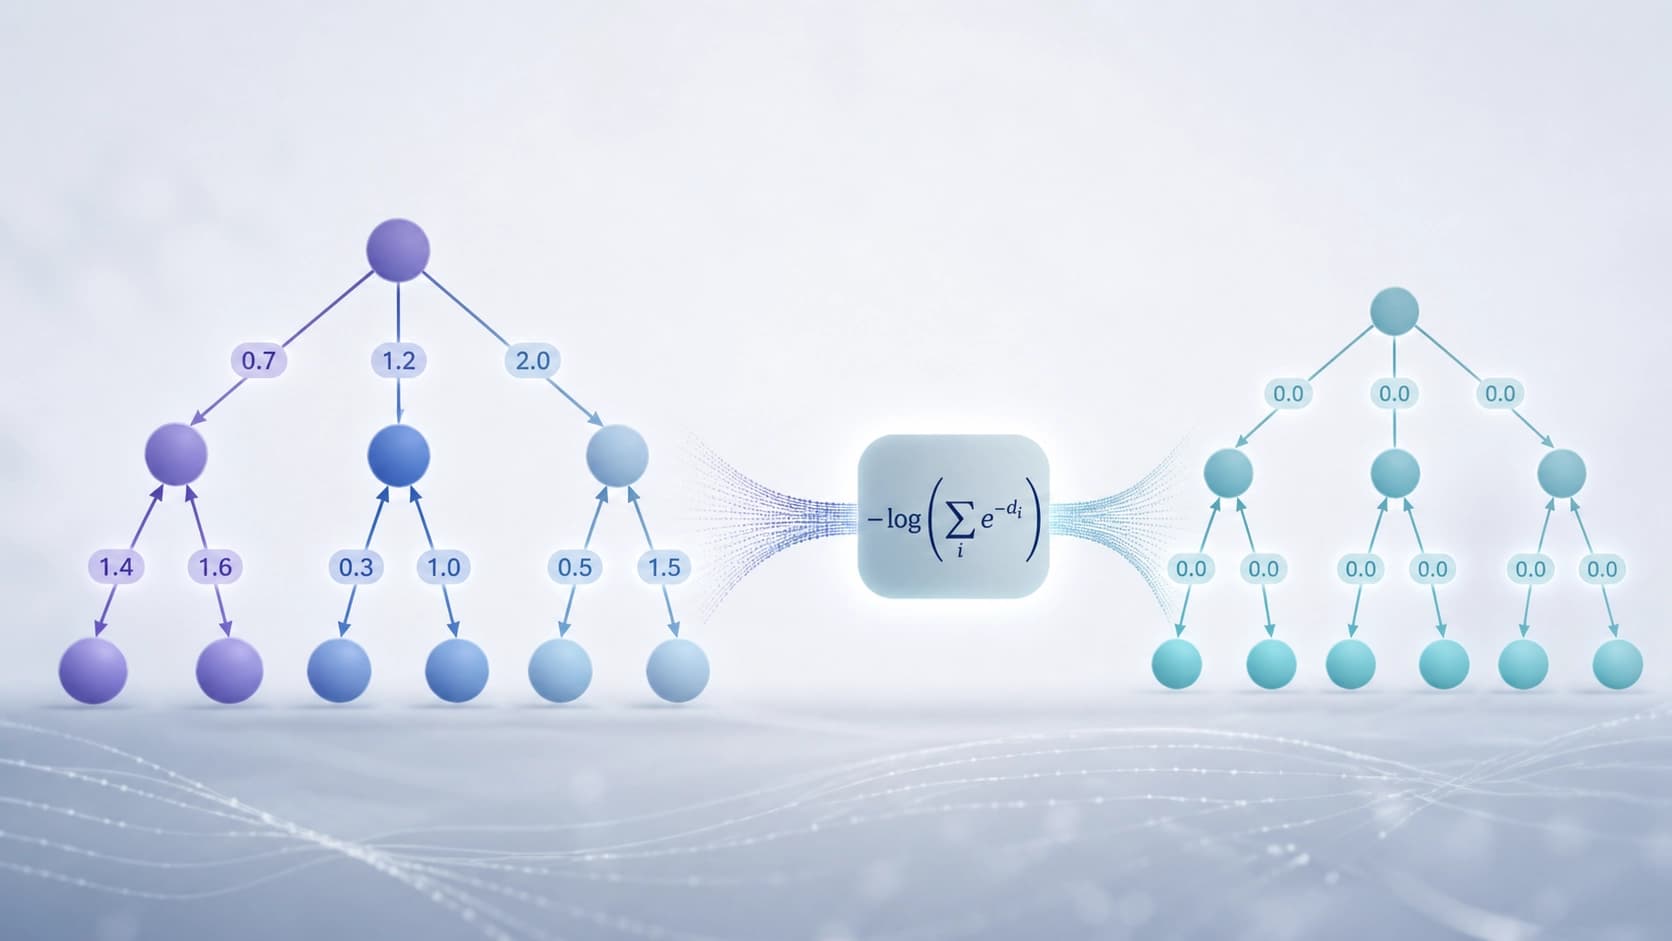
La segunda capa de la idea se apoya en una propiedad matemática de la distancia de Mahalanobis: es definida positiva. A partir de esto se puede construir directamente lo que en el artículo se denomina Tree Attention: las puntuaciones de atención se construyen no a partir de similitudes "en bruto", sino de distancias acumuladas a lo largo del árbol. Para que tales acumulaciones no se desvíen numéricamente, se aplica una corrección mediante LogSumExp: a la distancia se le resta el logaritmo de la suma de exponenciales sobre las aristas. En esencia, es una forma de conciliar las contribuciones de distintos caminos en el árbol sin perder su peso relativo.
Para el lector no familiarizado con los detalles, una analogía útil es la siguiente: en lugar de sumar "similitudes" de cualquier manera, el modelo las normaliza cuidadosamente a medida que avanza hacia el interior de la estructura. Esto se parece más a contabilidad que a intuición, pero precisamente esa meticulosidad permite que el razonamiento se mantenga estable en cadenas largas de dependencias.
Attention meshing: las cabezas empiezan a hablar entre sí
Habitualmente, la atención multi-cabeza está organizada como un conjunto de expertos casi independientes: cada cabeza calcula lo suyo, y la mezcla ocurre solo en la salida, mediante una proyección lineal. En MHA-CSP, las matrices de distancias de Mahalanobis se reutilizan repetidamente: sobre su base se construye el mecanismo de "attention meshing", que hace que los kernels de distintas cabezas interactúen directamente. El autor declara un doble beneficio: mayor precisión y entrenamiento más eficiente, ya que el mismo trabajo computacional no se duplica.
Experimentos: 119K parámetros frente a grandes modelos base
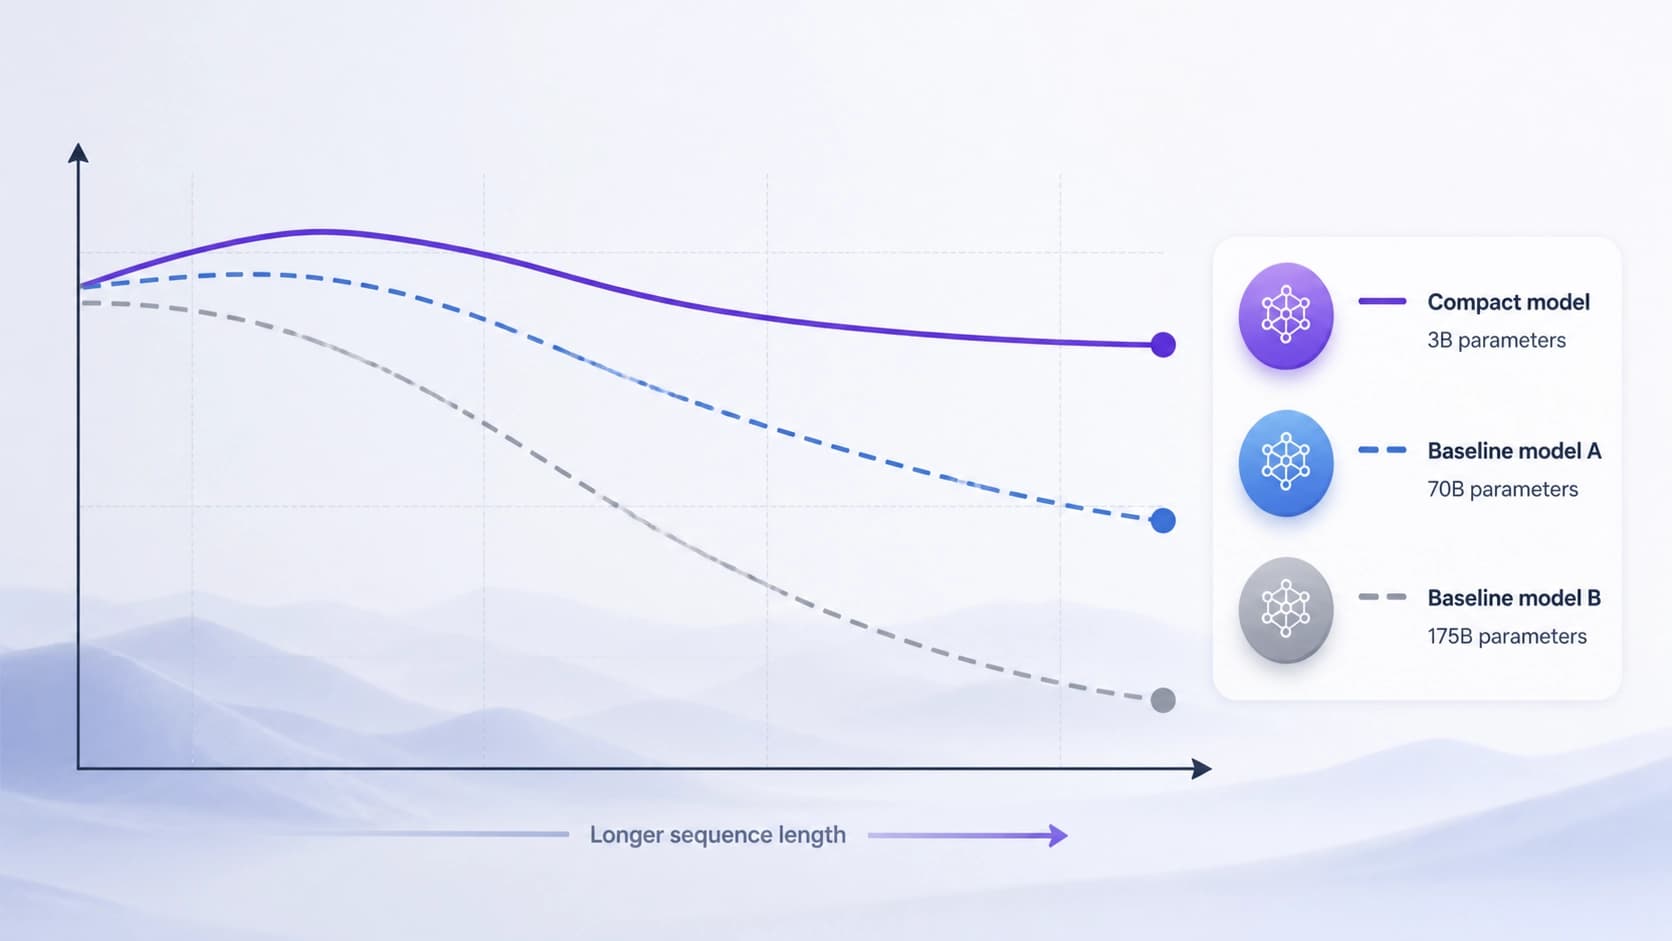
La parte más sonada del trabajo es la comparación. MHA-CSP, con apenas 119 mil parámetros, se compara con transformers base y redes convolucionales de grafos entrenados desde cero en condiciones idénticas. La tarea es el seguimiento de estados en secuencias largas. Además, el teacher forcing se aplicó exclusivamente sobre el estado oculto final, es decir, el modelo no recibía pistas en cada paso, como suele hacerse en un entrenamiento más instructivo.
Según afirma el autor, MHA-CSP supera de forma consistente a los competidores. Los modelos base se apoyan, o bien en atención densa (transformer), o bien en la propagación de información por el grafo (GCN), mientras que MHA-CSP logra un razonamiento estructurado gracias a la corrección sintética de distancias y a un recorrido económico de la información, heredado del backbone CSP.
Conviene subrayar: no se trata de que un modelo pequeño "alcance" a los grandes en todo. Se trata de una clase concreta de tareas: secuencias largas con estructura simbólica interna, donde lo importante no es solo memorizar el contexto, sino mantener su estado. Es precisamente ahí donde la geometría de distancias y la normalización arbórea empiezan a funcionar.
Qué cambia esto en la práctica
La conclusión principal del trabajo se formula así: la propagación de estados con valores complejos (complex-valued state propagation) en combinación con la corrección multi-cabeza conjunta resulta una herramienta funcional para captar estructuras simbólicas. Y establece un nuevo compromiso entre eficiencia y calidad para tareas de razonamiento estructurado.
Visto en perspectiva, aquí se percibe una tendencia de los últimos años: en lugar de aumentar parámetros, los investigadores buscan sesgos inductivos más acertados, es decir, incorporan en la arquitectura las suposiciones correctas sobre la naturaleza de los datos. El producto escalar era una suposición cómoda, pero bastante tosca. Sustituirlo por un kernel con métrica de covarianza es un intento de decirle al modelo: "no todas las direcciones en el espacio son iguales, tenlo en cuenta desde el principio".
Una mirada cautelosa desde fuera
Hay razones para no lanzarse a reescribir los pipelines. En primer lugar, los resultados se obtuvieron en un conjunto concreto de tareas de seguimiento de estados; trasladarlos a la generación de texto, la multimodalidad o escenarios conversacionales sin una verificación aparte no es aconsejable: en el abstract no hay tales experimentos. En segundo lugar, un único autor y la primera versión del preprint (v1, enviada el 25 de agosto de 2026) implican que aún no hemos visto una replicación independiente: el archivo de 377 KB está disponible en PDF, HTML y fuentes TeX, pero la reproducción es otra historia.
Y aun así, la dirección parece productiva. Abandonar el producto escalar, trabajar directamente con la geometría de distancias, reutilizar cálculos entre cabezas: son precisamente los movimientos que reducen el coste del modelo sin sacrificar expresividad. Si los resultados se confirman en otros dominios, las redes "pequeñas pero bien construidas" tendrán un argumento de peso más.