El producto no se reduce a un solo punto en el espacio
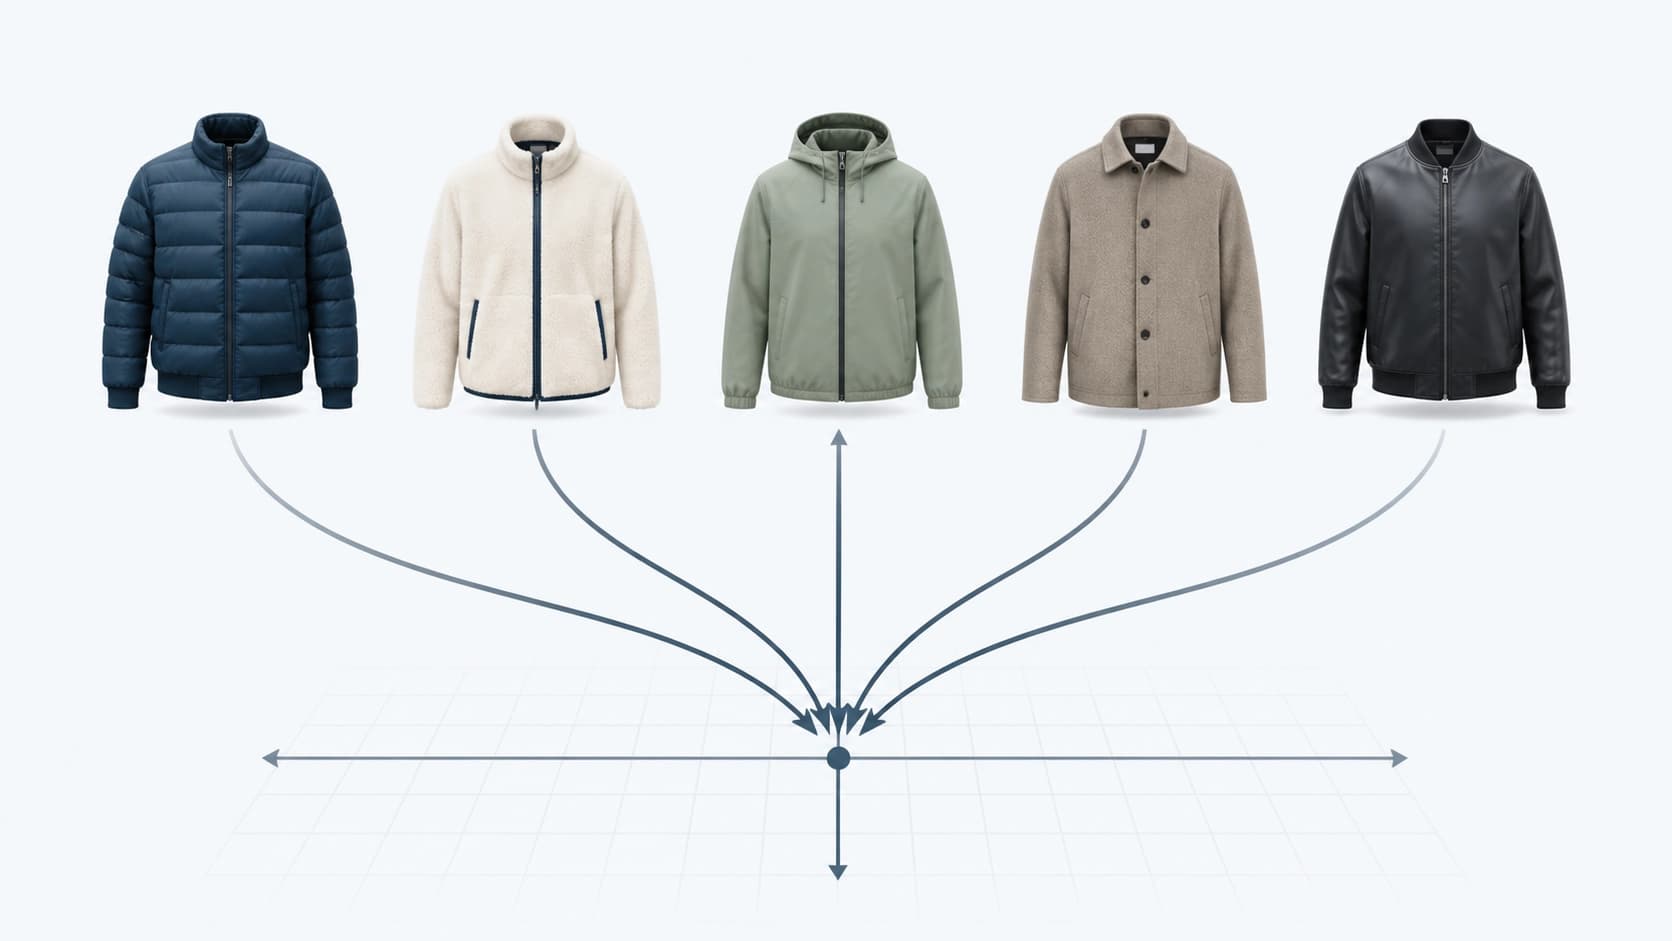
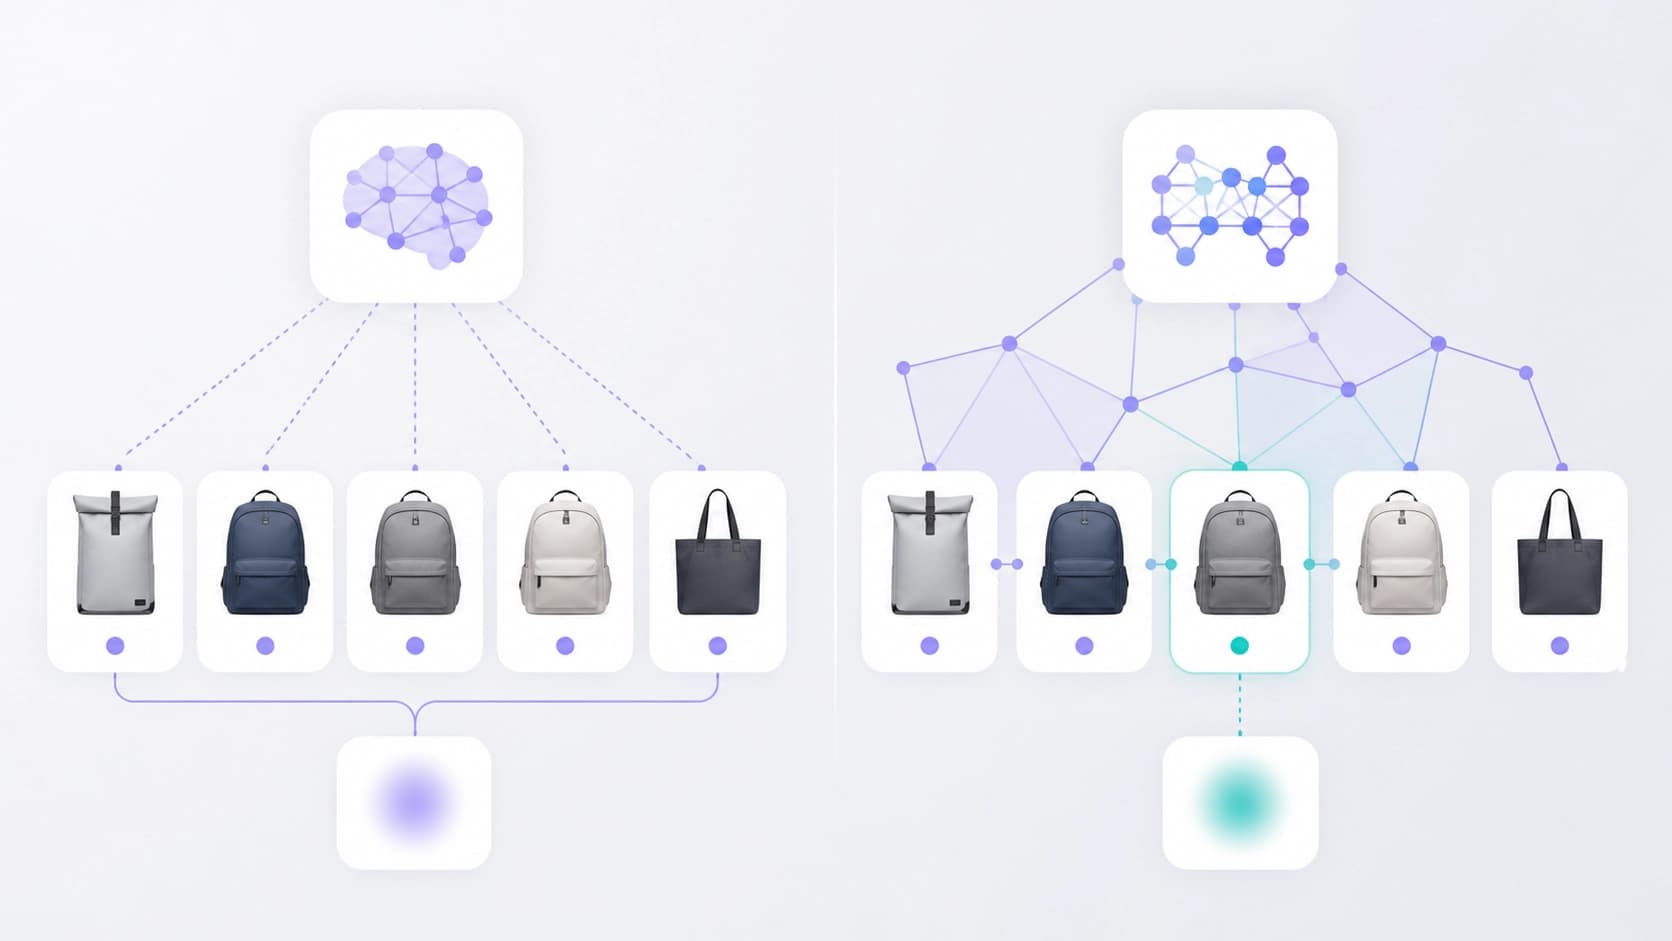
Los modelos de lenguaje multimodales grandes han aprendido a «entender» bastante bien las fichas de producto: vinculan la fotografía, el nombre y la descripción en un único campo semántico. Pero este esquema tiene un coste oculto. La información del producto se comprime en un único embedding global — un vector promediado donde los detalles se diluyen. Cuanto más intenta el modelo abarcarlo todo a la vez, menos concreción queda en el vector resultante.
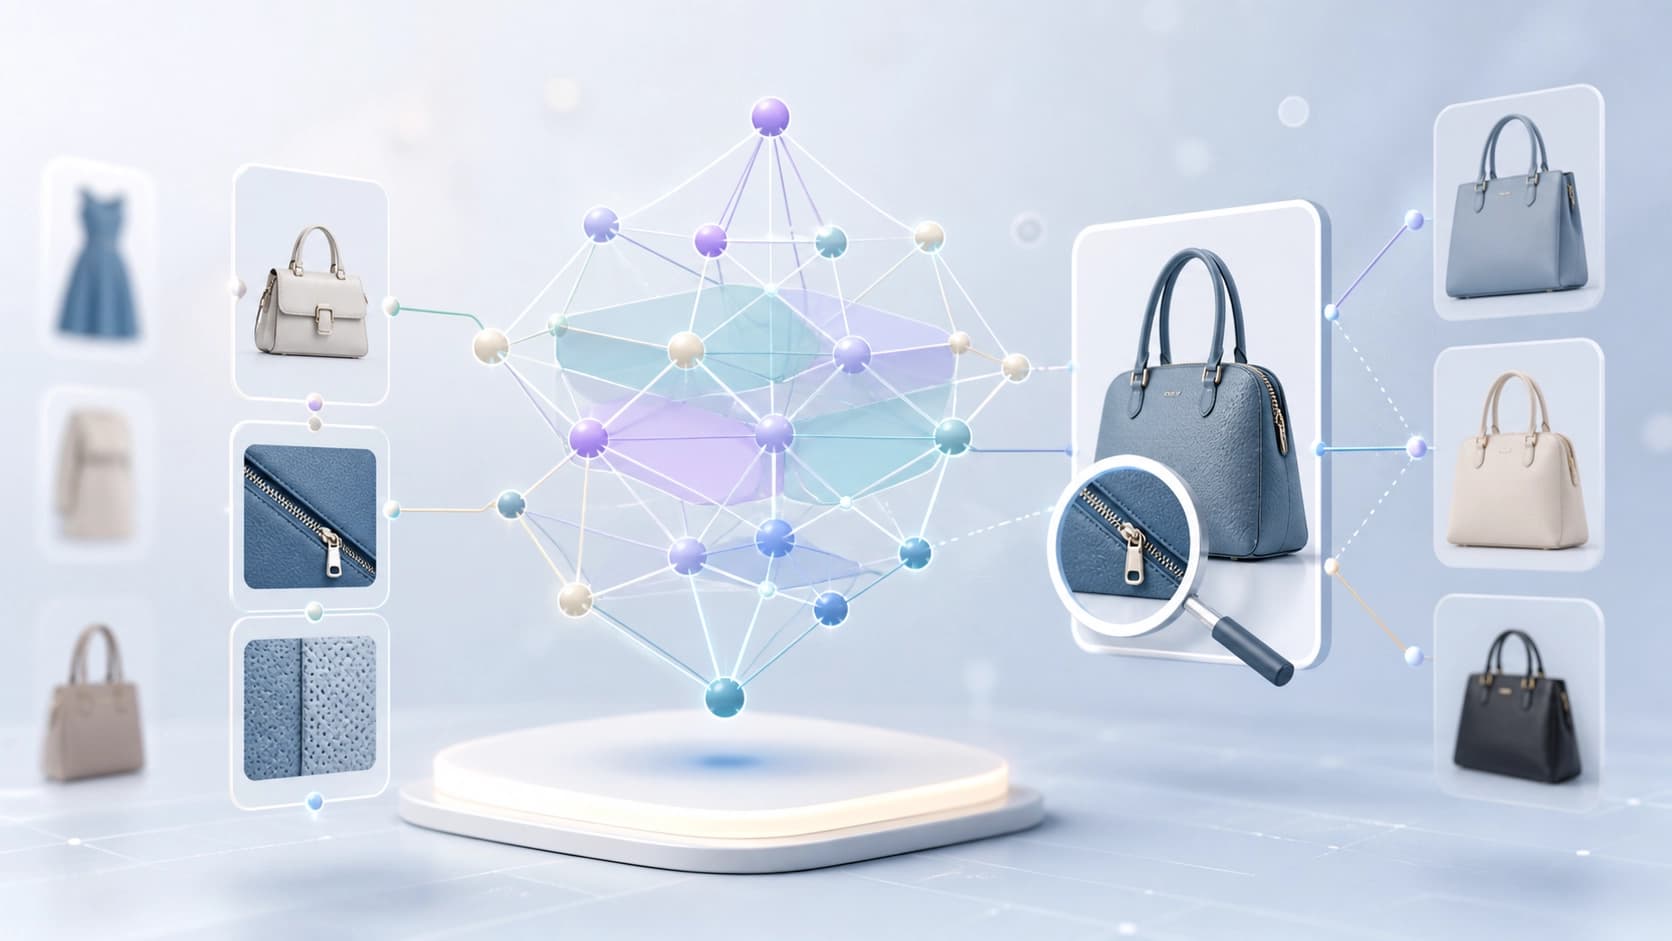
El precio de esa compacidad se ve en tareas donde precisamente importan los detalles. Dos chaquetas de materiales distintos, dos tazas con un esmalte casi idéntico, dos cables con conectores diferentes — visualmente son casi gemelos y en el espacio de embeddings acaban casi en el mismo punto. El usuario, sin embargo, no busca «algo parecido», sino un material concreto, una compatibilidad o una característica. Es en ese tipo de consultas donde el promediado empieza a estorbar: el modelo no distingue los atributos y, por tanto, el ranking resulta aproximado.
El artículo arXiv:2608.24467 (Qiuyu Zhu, Yi Gao, Zhichao Wan, Mingyang Ma, agosto de 2026) plantea el diagnóstico sin rodeos: los embeddings globales codifican implícitamente el producto en su totalidad, y eso limita la captación de atributos de grano fino. ¿Se soluciona con un simple «hagamos el vector más grande»? A juzgar por la lógica del trabajo, no: el problema no está en la dimensionalidad, sino en la forma de representación.
Un hipergrafo en lugar de una lista plana de embeddings
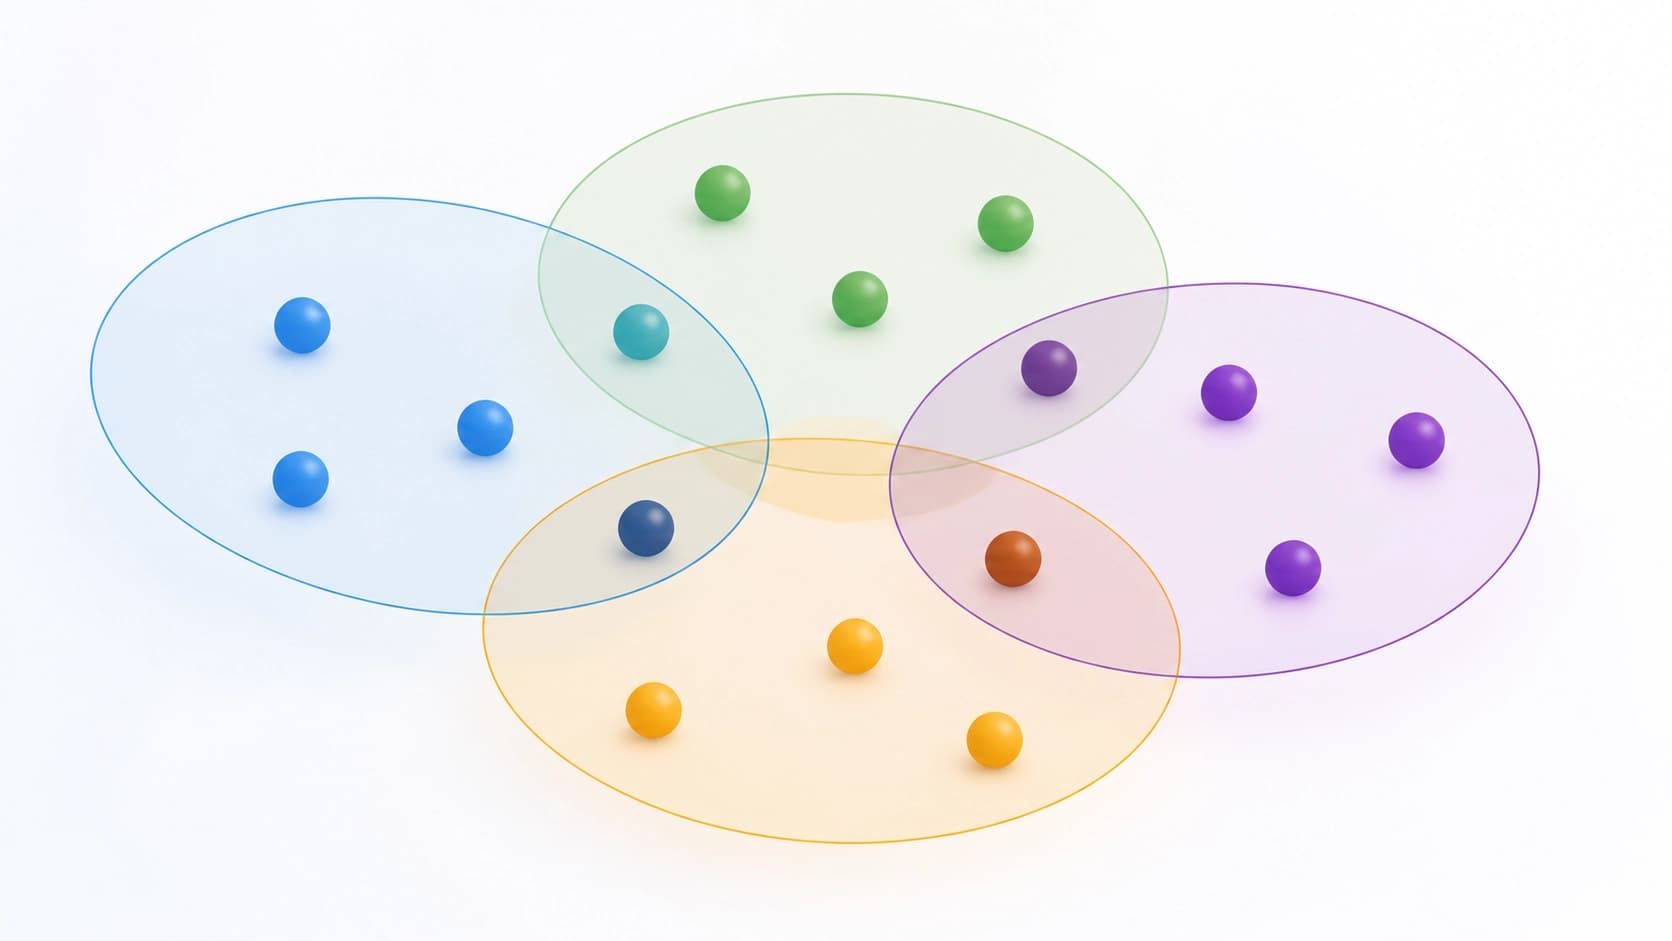
Los autores proponen HMGCLIP — un framework de embeddings multimodales basado en un hipergrafo heterogéneo. La diferencia con un grafo habitual es fundamental. Una arista normal conecta dos objetos; una hiperarista vincula directamente a un grupo — por ejemplo, todos los productos de una categoría unidos por un atributo común. Esta construcción permite describir relaciones que no se pueden descomponer en pares: «estas siete posiciones son una misma línea de materiales», «estas cuatro son análogos intercambiables».
Después, la topología del hipergrafo opera en dos direcciones. En primer lugar, de ella se extraen negativos complejos estructuralmente conscientes — esos ejemplos parecidos pero incorrectos con los que el modelo aprende a distinguir. Este es un punto importante: los negativos complejos no se eligen al azar del corpus, los sugiere la propia estructura de las conexiones. En segundo lugar, a través del hipergrafo se armoniza la semántica multigranular — tanto a nivel de relaciones como a nivel de hiperaristas. En términos simples, el modelo alinea entre sí no solo productos individuales, sino grupos semánticos completos.
Para qué sirve el mecanismo de inferencia de doble granularidad
Un detalle aparte es la dual-granularity inference. En la salida, el sistema combina dinámicamente las evidencias atributivas para trabajar con la misma seguridad tanto en tareas de grano fino como de grano grueso. El sentido práctico es que una consulta necesita un nivel general («muéstrame zapatillas») y otra, uno extremadamente concreto («zapatillas con membrana y un tipo específico de suela»). Un modelo enfocado solo en el detalle pierde amplitud; uno enfocado solo en lo general, precisión. Aquí se plantea que el sistema decida por sí mismo en qué nivel mirar.
Conjunto de datos y validación
Los autores no se limitaron a la arquitectura: publicaron un conjunto de datos integral de comercio electrónico de grano fino para que la tarea contara con un benchmark reproducible para futuras comparaciones. Esta es, quizá, una parte no menos valiosa del trabajo — sin un conjunto de datos público, discutir sobre distinción de grano fino carece de sentido, cada uno mide con el suyo.
Los experimentos se llevaron a cabo sobre el nuevo conjunto de datos y sobre el benchmark público MAVE. El resultado se declara sin ambigüedad: el enfoque supera a encoders multimodales potentes, a LLM multimodales y a soluciones base para comercio electrónico. Las cifras concretas y las tablas están en el propio trabajo; aquí lo importante es la conclusión de que un enfoque estructural de la representación aporta una ventaja que no se logra simplemente complicando el modelo.
Dónde resulta útil en la práctica
Lo primero y más obvio: la búsqueda y la selección de análogos. Cuando un comprador busca un reemplazo para algo que se ha averiado, necesita compatibilidad por atributos, no un parecido general de la imagen. Lo segundo: las recomendaciones, que ganan si saben distinguir una variante con otro material del mismo producto en otra configuración. Lo tercero: la limpieza del catálogo — los duplicados y casi duplicados que hoy se fusionan con automatismos a ciegas se separan con más sentido con una representación de grano fino.
Hay también una capa menos evidente: la explicabilidad. Las hiperaristas forman una estructura que muestra por qué unos productos acabaron cerca. Para los equipos que investigan errores de ranking, esto es más útil que un vector de naturaleza incomprensible.
Qué queda aún por resolver
Cualquier trabajo con estructura de grafo choca con el coste: el hipergrafo hay que construirlo y, al actualizar el catálogo, mantenerlo al día. Hasta qué punto resulta barato con millones de fichas y con qué frecuencia habrá que reconstruirlo, los autores no lo detallan en el resumen.
La segunda cuestión es la portabilidad. El conjunto de datos se recopiló en un único dominio, y se desconoce hasta qué punto el patrón de comportamiento de las hiperaristas se mantendrá al pasar, por ejemplo, de la ropa a la electrónica, donde los atributos están organizados de forma completamente distinta. La tercera: cómo convive este enfoque con los pipelines de producción ya en funcionamiento — cambiar la forma de representación suele implicar reindexar todo el índice de búsqueda.
Sea como fuere, la dirección está trazada con claridad. La discusión no gira en torno a qué modelo es más grande, sino a cómo almacenar correctamente el significado del producto: en un único punto promediado o en una red de relaciones donde los detalles no se diluyen.