
Problema: pocas pruebas, y la recompensa por ellas lo es todo
El aprendizaje por refuerzo con recompensas verificables (RLVR) se ha convertido en la principal forma de llevar los modelos de lenguaje a un nivel decente en la generación de código. El esquema es simple: el modelo escribe una solución, una verificación especial la ejecuta a través de las pruebas, y según el resultado se le asigna una recompensa al modelo. Todo se sostiene sobre una única suposición: que las pruebas realmente describen la tarea en su totalidad.
En la práctica, esta suposición casi siempre se incumple. El conjunto de casos de prueba es estrecho, la cobertura tiene agujeros, y el modelo encuentra bastante rápido no la tarea, sino una laguna: ajusta el código a las verificaciones concretas en lugar de aprender a resolver una clase de tareas similares. Después se pone en marcha la espiral conocida: reward hacking, seguido de la degradación de la política. El modelo pierde en habilidades generales exactamente en la misma medida en que prospera en una astucia estrecha.
Una analogía burda: un examen compuesto por dos preguntas. El estudiante que se aprendió las respuestas a esas dos preguntas obtiene la nota máxima, pero no domina la materia. Y cuanto más dura ese aprendizaje, peor se vuelve en todo lo demás.
La idea de RobustTests: los errores como generador de pruebas
Normalmente las pruebas se idean partiendo del enunciado de la tarea: qué entradas existen, dónde están los límites de los rangos, qué ocurrirá con una entrada vacía. Es lógico, pero precisamente ese camino es el que da una cobertura estrecha: el autor de las pruebas y el autor de la solución miran la tarea desde el mismo lado y son igualmente ciegos a los mismos puntos.
RobustTests invierte el proceso. En la base del framework está la síntesis de casos de prueba guiada por código defectuoso (faulty-code-driven test case synthesis). No se trata de código roto aleatorio, sino de soluciones «casi correctas»: aquellas que se diferencian de la correcta por un pequeño cambio de lógica — un signo de comparación confundido, un límite de bucle incorrecto, una rama omitida. Cada una de esas soluciones casi funciona, y precisamente por eso es valiosa.
Después se busca una entrada en la que el código casi correcto diverge del de referencia. La entrada encontrada se convierte en una prueba. Una prueba así posee una alta capacidad diagnóstica: no solo «verifica algo», sino que distingue dos comportamientos cercanos — el que queremos del modelo y el que parece plausible pero es erróneo.
El trabajo está descrito en el preprint de arXiv:2608.24135 (Yiwen Zhang y otros ocho autores, entre ellos Xiaodong Yan, Zhenyu Huang, Deng Zhao y otros; v1 — 25 de agosto de 2026, v2 — 27 de agosto de 2026, DOI 10.48550/arXiv.2608.24135, aceptado para EMNLP 2026). Los autores clasifican el material en dos secciones a la vez — cs.AI y cs.SE, lo cual es lógico: trata tanto del entrenamiento de modelos como de la ingeniería de pruebas.
Filtrado: agentes validadores y clustering
Cualquier síntesis automática de pruebas se convierte fácilmente en un generador de basura. Parte de las entradas ideadas resultará inválida, parte duplicará a otras, parte verificará el mismo comportamiento desde ángulos distintos. La señal útil de ese conjunto es escasa, y el ruido, mucho.
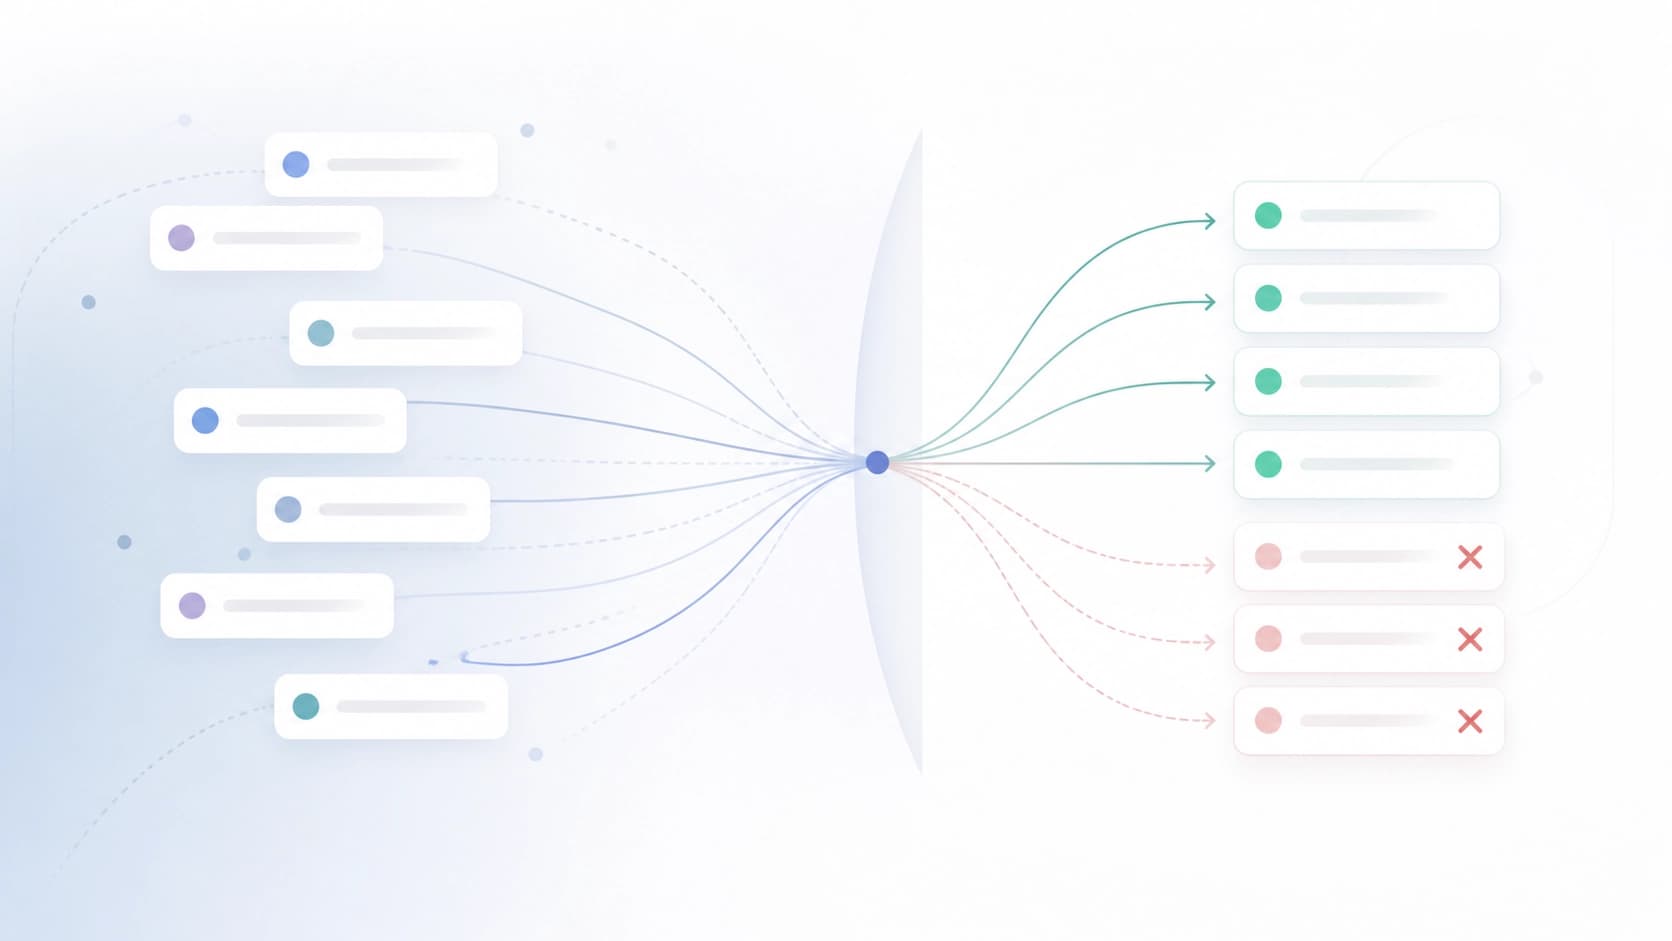
Por eso el pipeline incluye una segunda capa: agentes validadores que descartan los casos de prueba incorrectos y superfluos. A ellos se añade el clustering por rasgos de comportamiento: las pruebas se agrupan según qué comportamiento del código distinguen exactamente, y los duplicados dentro de un grupo se colapsan. Al final queda un conjunto compacto, donde cada elemento aporta información nueva en lugar de repetir al vecino.
Recompensa densa en lugar de señal escasa
El segundo componente del framework no concierne a las pruebas, sino a cómo se calcula la recompensa a partir de ellas. El enfoque binario clásico — «pasó todo o no pasó nada» — funciona mal cuando las pruebas se vuelven numerosas y de dificultad diversa: el modelo resuelve casi todo, tropieza con un caso límite y recibe el mismo cero que una solución completamente rota. La señal de aprendizaje se corta, y casi no hay de qué aprender con ella.
RobustTests introduce una función de recompensa densa por pasos (stepwise dense reward), basada en la proporción de verificaciones superadas — pass rate. El modelo recibe una señal parcial y entiende la dirección del movimiento: no «fracaso», sino «quedan dos pruebas de treinta». Esto resuelve dos problemas a la vez. En primer lugar, reduce el número de falsos negativos (false negatives), cuando una solución correcta es rechazada por una prueba demasiado estricta o simplemente errónea. En segundo lugar, hace el entrenamiento más estable: la recompensa deja de ser un evento raro y se convierte en una escala.
Merece la pena subrayar por separado el vínculo entre estas dos ideas. La recompensa densa solo tiene sentido cuando las pruebas realmente distinguen distintos tipos de errores; de lo contrario, simplemente promedias ruido. Y la síntesis de pruebas a partir de soluciones casi correctas, sin una recompensa densa, dejará el mismo corte de señal de siempre. Los componentes funcionan en pareja.
Dataset y resultados
Con este pipeline, los autores reunieron una versión ampliada del dataset CodeContests+, con una utilidad diagnóstica notablemente mayor: los conjuntos de pruebas empezaron a indicar con más precisión en qué paso exacto de la solución se equivoca el modelo.
La medida principal no es el tamaño del dataset, sino el comportamiento del modelo tras el ajuste fino. El entrenamiento RL de Qwen3-32B con RobustTests da un incremento absoluto del 3% en LiveCodeBench. El código y los datos los autores los publicaron en acceso abierto.
Aquí conviene mantener la sobriedad. Tres puntos porcentuales en un solo benchmark al ajustar un solo modelo no son una revolución en el campo, sino una mejora cuidadosa con un mecanismo comprensible. El valor del trabajo reside más bien en la metodología: propone una receta reproducible para exprimir más señal de las pruebas sin ampliar su número manualmente. Las limitaciones también son evidentes: aún queda por comprobar la transferencia del resultado a otros modelos, lenguajes y tipos de tareas.
Qué conviene llevarse de esto a la propia práctica
Aunque no vayas a montar un pipeline de RL y solo evalúes la calidad de la generación de código, la lógica se traslada casi sin cambios:
- Escribe pruebas a partir de los errores, no solo del enunciado. Toma una solución que casi funciona y encuentra la entrada donde se rompe. Una prueba así casi siempre es más informativa que una decena ideadas «a lo bruto».
- Calcula la proporción de verificaciones superadas, no el hecho de superarlas. La puntuación parcial da gradiente tanto en el entrenamiento como en el análisis de calidad: se ve dónde falla exactamente el modelo.
- Filtra las pruebas sintetizadas. Sin validación y deduplicación, un conjunto generado automáticamente se convierte rápido en un vertedero de verificaciones parecidas entre sí.
- Vigila qué está premiando realmente la recompensa. La escala densa reduce la tendencia a los atajos, pero no la elimina: si las pruebas no distinguen el comportamiento, cualquier recompensa tarde o temprano será hackeada.
La idea que transmite RobustTests es humanamente simple: la mejor fuente de pruebas difíciles no es la fantasía del autor, sino los propios casi-errores del sistema. Eso que el modelo estuvo a punto de hacer bien es el indicador más honesto de dónde pasa la frontera entre «parece una solución» y «solución».


