
Datos sin procesar en lugar de tablas listas
Los modelos actúan cada vez más como agentes de código: se les encarga escribir scripts para procesar datos, construir gráficos, calcular métricas, analizar volcados de ingeniería. Pero hay una clase de tareas que hasta ahora casi no se ha evaluado: el trabajo con la «materia prima» del nivel físico. Precisamente ese nicho lo cubre el benchmark EMRB (Electromagnetic Reasoning Benchmark), descrito en el preprint arXiv:2608.24086 (secciones cs.AI, cs.CE, cs.SE).
La idea clave es simple y por eso convincente. En la entrada solo hay registros I/Q sin procesar, es decir, muestras en cuadratura de la señal tal como llegan del receptor. Nada de características preprocesadas, espectrogramas etiquetados y mucho menos tablas con valores ya calculados. La magnitud a la que se refiere la pregunta el modelo debe primero detectarla en los datos, mediante código que él mismo escriba y ejecute.
En qué se diferencia de las mediciones habituales
En los últimos años han aparecido bastantes conjuntos de tareas en los que se propone a los modelos razonar sobre señales de radio. Pero lo más habitual es que allí ya se haya hecho el trabajo por el modelo: se extrajeron características del registro, se calculó el espectro, se estimó el nivel de ruido, se volcó todo en una tabla estructurada. En ese planteamiento solo queda aritmética y comparación de números: habilidades útiles, pero sin relación con la radiofísica.
La diferencia es fundamental. Cuando las magnitudes vienen dadas de antemano, un error del modelo en un paso temprano no se ve: una estimación incorrecta del ancho de banda o de la frecuencia simplemente no surge, porque esos valores se dieron en el enunciado. Cuando los datos están sin procesar, cualquier error en la etapa de exploración de la señal arrastra consigo todo el cálculo posterior. Por eso EMRB no evalúa el conocimiento de términos, sino la capacidad de construir una cadena: mirar las muestras, entender qué señal hay ahí, aislar la característica necesaria, calcularla correctamente y no perder las dimensiones.
Cómo está estructurado el benchmark
Los autores — Mingxu Zhang, Ying Sun, Yuhan Li, Yang Ji, Dazhong Shen, Ke Zhang y Shan Huang — reunieron 200 tareas. Las tareas se distribuyen en cinco niveles de dificultad y 27 tipos de preguntas: desde la detección trivial de señal hasta el diseño de un sistema OFDM. La fuente del material son 11 tipos de señales, y para cada una se preparó una verdad de referencia verificada.
Cinco niveles
Los niveles están ordenados según el aumento de la autonomía del modelo. Abajo están las mediciones de parámetros básicos: encontrar la señal, estimar sus características. Más arriba, la interpretación y la comparación, luego el análisis con varios pasos, después el diagnóstico y, por último, el diseño de sistemas, donde al modelo no se le pide medir, sino diseñar una solución bajo requisitos dados.
27 tipos de preguntas y 11 tipos de señales
Esta variedad es necesaria para que el resultado no dependa de un enunciado afortunado o desafortunado. Los distintos tipos de señales generan distintas trampas: en un caso estorba el ruido, en otro la superposición espectral, en otro hay que tratar con cuidado el muestreo. El número de tipos de preguntas y de señales juntos forma un espacio en el que es difícil acertar por casualidad.
Datos abiertos
Todos los materiales y el código están publicados en un repositorio público de GitHub, así que el resultado puede verificarse de forma independiente. Para un benchmark esto es más importante de lo habitual: si las tareas se generan en lugar de recopilarse manualmente a partir de registros de campo, la cuestión de la corrección de las referencias se vuelve central, y la apertura es aquí la única respuesta que funciona.
Qué mostraron los modelos
Se evaluaron 14 modelos de lenguaje: propietarios, de pesos abiertos y, por separado, modelos orientados al razonamiento. La dispersión final va del 24.1% al 78.9%. El propio rango ya dice mucho: la diferencia entre el mejor y el peor modelo aquí se mide no en porcentajes, sino en múltiplos.
Pero hay algo más interesante. El resultado medio cae bruscamente a medida que se complica el nivel: del 84.9% en las mediciones básicas al 21.2% en el diseño de sistemas. Es decir, los modelos se desenvuelven bastante bien cuando hay que calcular una magnitud medible, y casi se desmoronan cuando hay que ensamblar con esas magnitudes una solución funcional.
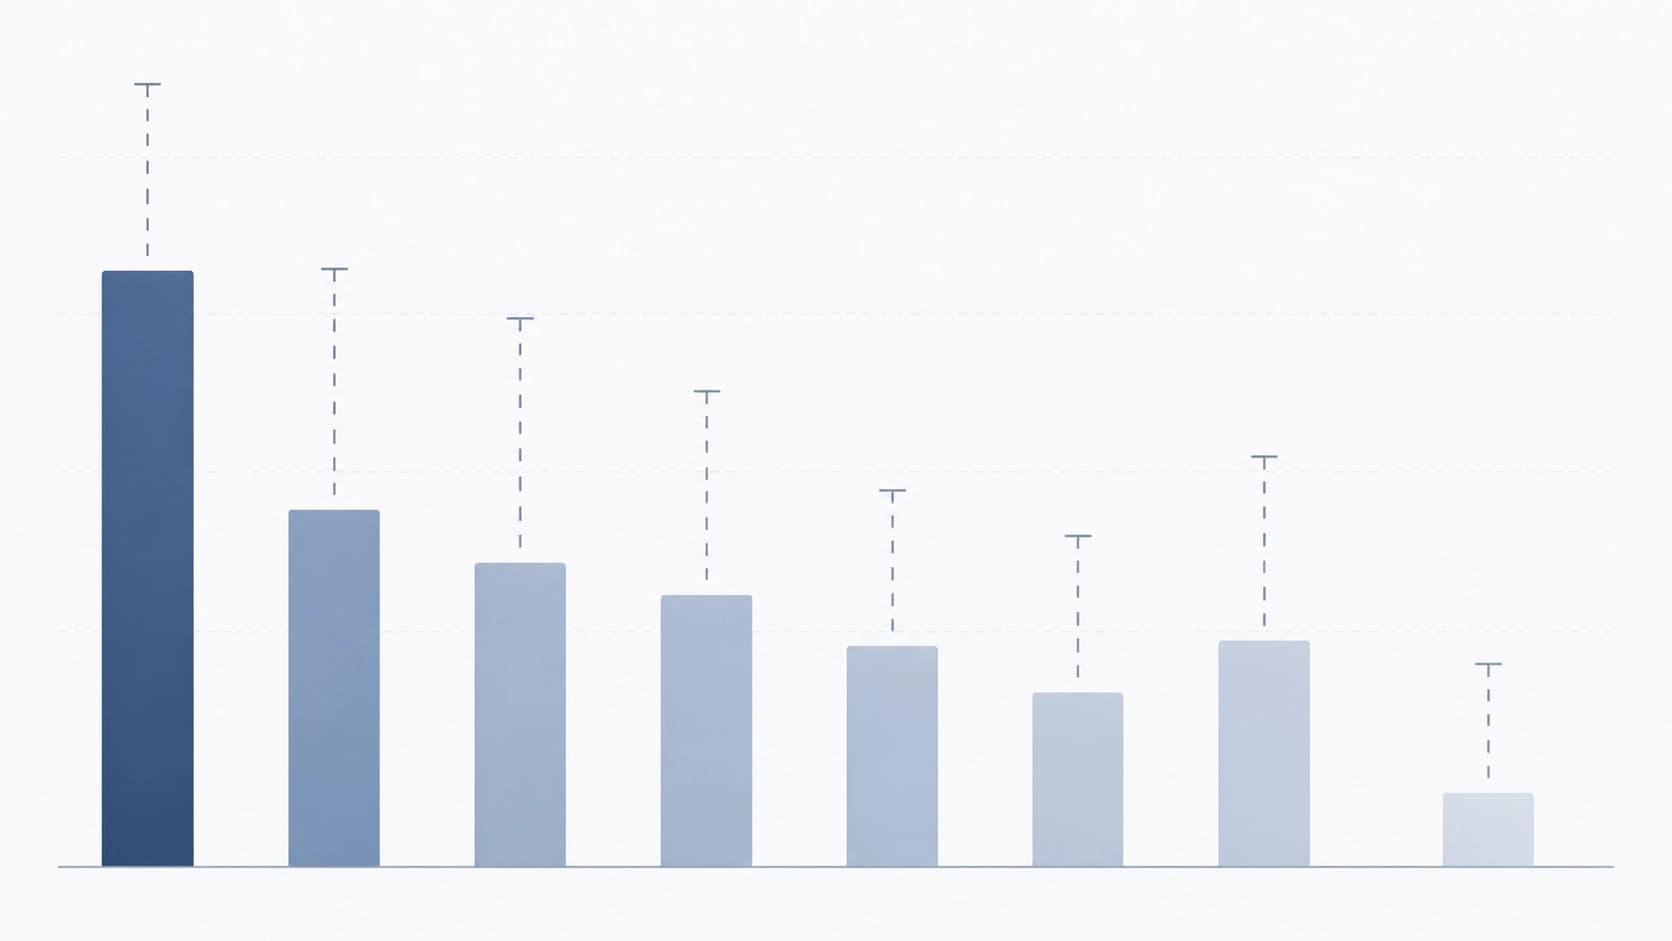
Esto hay que leerlo como un diagnóstico, no como una clasificación. El punto fuerte de los modelos actuales es la ejecución de código y la aritmética sobre un planteamiento conocido. El punto débil es la traducción de una tarea de ingeniería al lenguaje de pasos medibles: entender qué magnitudes hacen falta en general, en qué orden buscarlas, cómo comprobar que lo encontrado se parece en algo a la verdad. Precisamente esa brecha es lo que hace útil al benchmark.
ReconPilot: exploración, análisis, verificación
Los autores no se limitaron a medir. Propusieron ReconPilot, un enfoque estructurado en el que el trabajo se divide en tres etapas: exploración de la señal, análisis específico y autoverificación. Primero el modelo estudia el registro y se forma una idea de con qué está tratando. Después resuelve la tarea concreta. Luego vuelve sobre su resultado y lo comprueba en busca de coherencia.
En tres modelos base, el método añade a la puntuación total entre 3.8 y 17.6 puntos. La mejora se logró en 13 de las 15 combinaciones «backbone + nivel» probadas. Fíjense en la formulación: la ganancia no es uniforme y en dos casos no existe en absoluto. Es un indicio normal de un experimento honesto: no se encontró una píldora universal, pero la tendencia es sólida.
Es revelador que lo que ayuda es precisamente la separación explícita de fases. Un modelo al que simplemente se le pide «analizar la señal» tiende a saltar a los cálculos sin asegurarse de que ha entendido los datos. La exploración como paso obligatorio independiente le fuerza a mirar primero y calcular después.
Qué se deduce de esto
Para la práctica de ingeniería la conclusión es bastante directa: antes de confiar a un agente cálculos sobre mediciones reales, conviene ponerlo a prueba con datos sin pistas. Una interfaz cómoda y una respuesta fluida en el chat no dicen nada sobre si el modelo sobrevivirá al encuentro con un volcado sin preparar procedente de un receptor.
Hay también una idea más general que trasciende la radio. En cualquier ámbito donde el razonamiento se apoye en mediciones sin procesar —hidroacústica, vibraciones, telemetría—, el agente debe ser capaz de encontrar primero la magnitud en los datos y luego trabajar con ella. Las tablas con características ocultan esa parte del trabajo y, junto con ella, ocultan los errores.
Limitaciones y qué viene después
No se puede decir que la cuestión esté cerrada del todo. 200 tareas son un volumen respetable, pero no ilimitado, y la generación a partir de 11 tipos de señales implica que los registros de campo reales con todos sus artefactos no están representados allí. La evaluación de 14 modelos es una instantánea del momento, no una sentencia: la composición de los líderes en este campo cambia rápido.
Aun así, el planteamiento de la tarea parece correcto. Si queremos que los LLM trabajen no con un resumen de los datos, sino con los datos mismos, hay que evaluarlos exactamente allí donde se acaban las pistas. EMRB hace precisamente eso, y demuestra que el margen de crecimiento de los modelos en la exploración de señales es todavía muy grande.


